自回放微调:让模型能力扩展变得简单
TL;DR 在一个窄任务上微调多模态大模型,模型通常会忘掉大量原本掌握的能力。自回放微调(Self-Replay Fine-Tuning)的做法是:把经过筛选、由模型自己生成的通用领域回答混入训练数据,以此阻止遗忘。损失函数、模型架构和训练流程都不用改。在 4 个模型、2 个任务上††模型:MiniCPM-V-4.5、MiniCPM-o-4.5、GLM-4.1V 与 Qwen3-VL-4B。
任务:计数(Counting)与文档 OCR(Doc-OCR)。,它把遗忘减少了 80% 以上,同时几乎完整保留了任务增益。
微调并不总像往图书馆里添一本新书,更像是在一页旧纸上写新笔记:新学的内容越来越清晰,底下原有的字迹却开始褪色。在一个窄任务上集中训练模型,它在这个任务上可能进步很大,却丢掉了原本得心应手的语言、推理或视觉能力。这种此消彼长,就是灾难性遗忘(图 1)。
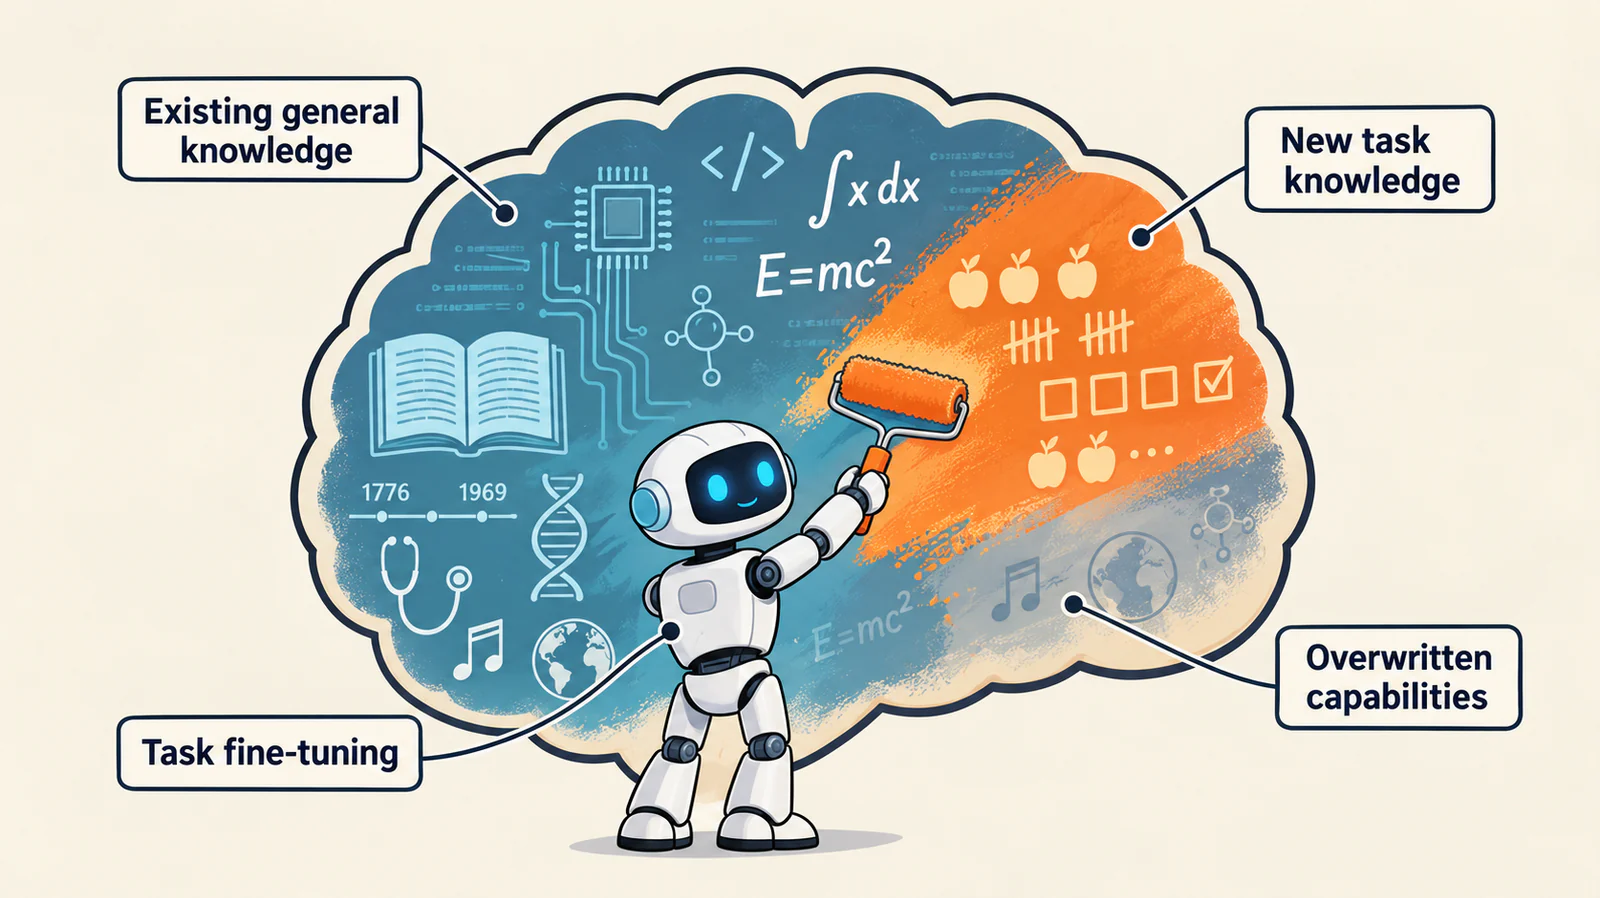
对已发布的多模态大模型做微调也是如此。给它一份干净的监督数据,教它数图片里的物体,计数准确率会迅速上升;可一旦重新跑一遍通用评测,损失随处可见:OCR、指令遵循、输出格式全都退步,受影响最严重的模型甚至丢掉了一半以上的通用得分。模型在窄任务上变得越强,丢掉的原有能力就越多。
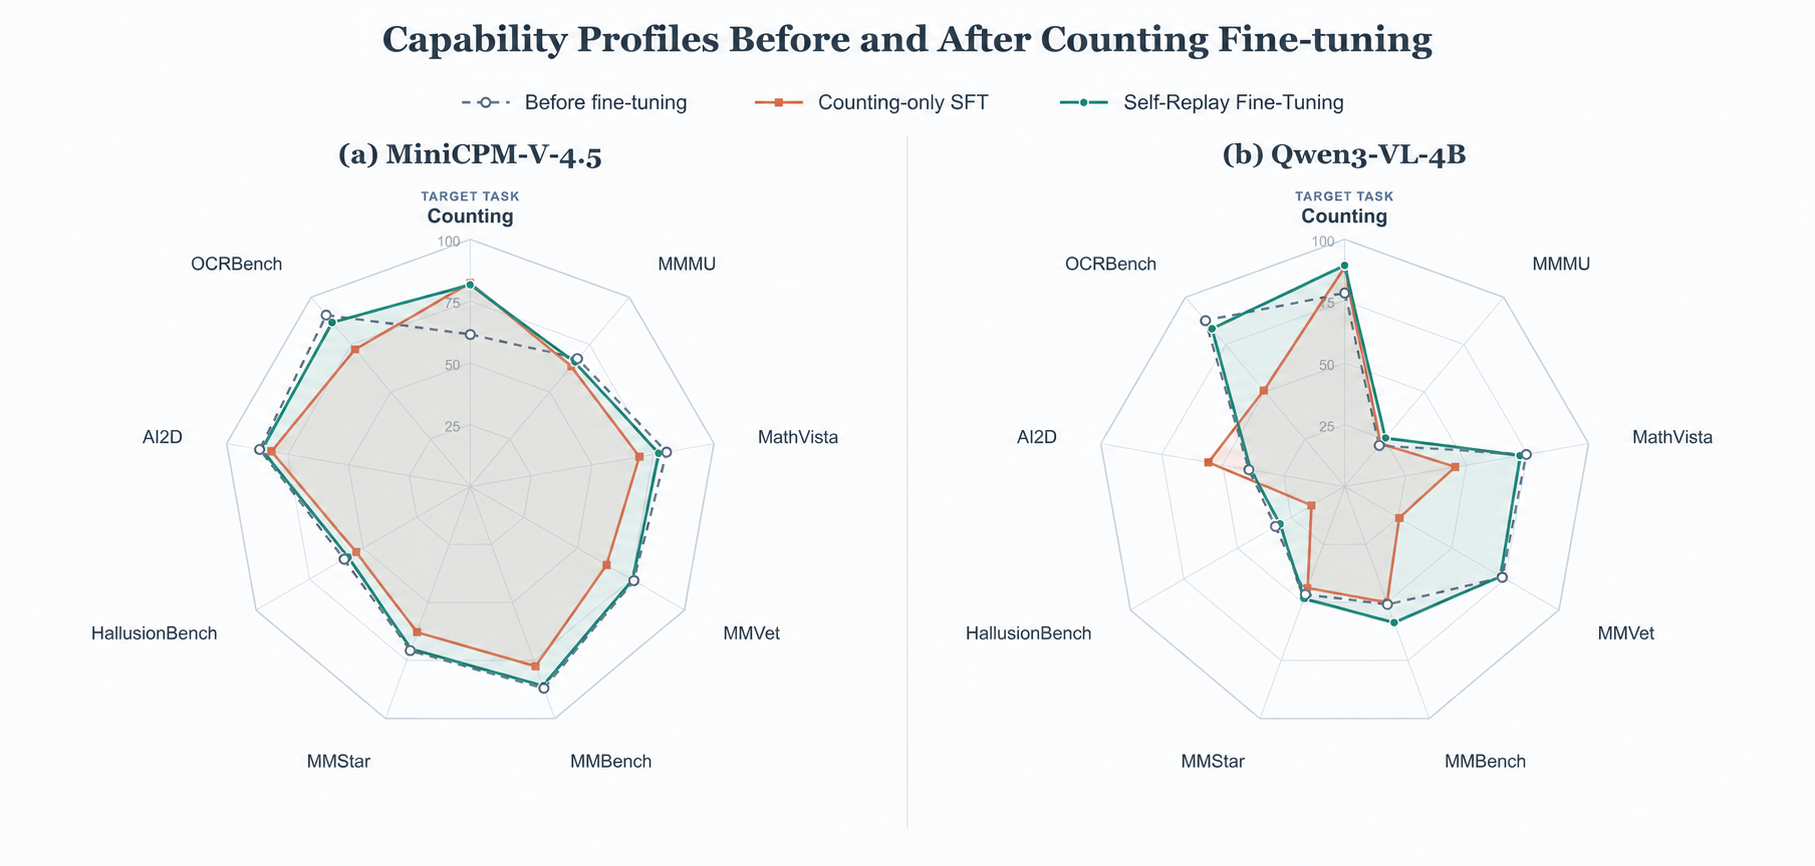
从更全面的能力视角看,这种权衡更加直观(图 2)。对 MiniCPM-V-4.5 和 Qwen3-VL-4B 而言,只用计数数据做 SFT,会把目标任务(计数)的得分向外推,同时把多项通用能力向内拉。使用自回放微调后,模型保留了几乎相同的计数增益,能力画像也恢复到接近微调前的样子。
这就是灾难性遗忘[1][1][1] McCloskey, M., & Cohen, N. J. (1989). Catastrophic interference in connectionist networks: The sequential learning problem. Psychology of Learning and Motivation, 24, 109–165.。下游 SFT 的参数更新会覆盖模型在微调前习得的能力:目标任务上的表现在提升,通用表现却在下降[2, 3][2, 3][2] Luo, Y., et al. (2023). An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning. arXiv preprint arXiv:2308.08747.[3] Li, H., et al. (2024). Revisiting Catastrophic Forgetting in Large Language Model Tuning. Findings of EMNLP 2024.。对已经部署的模型来说,这往往意味着丢掉了它原本最有用的那部分能力。
现有对抗遗忘的方法大致分为四类,每一类都有实实在在的代价:
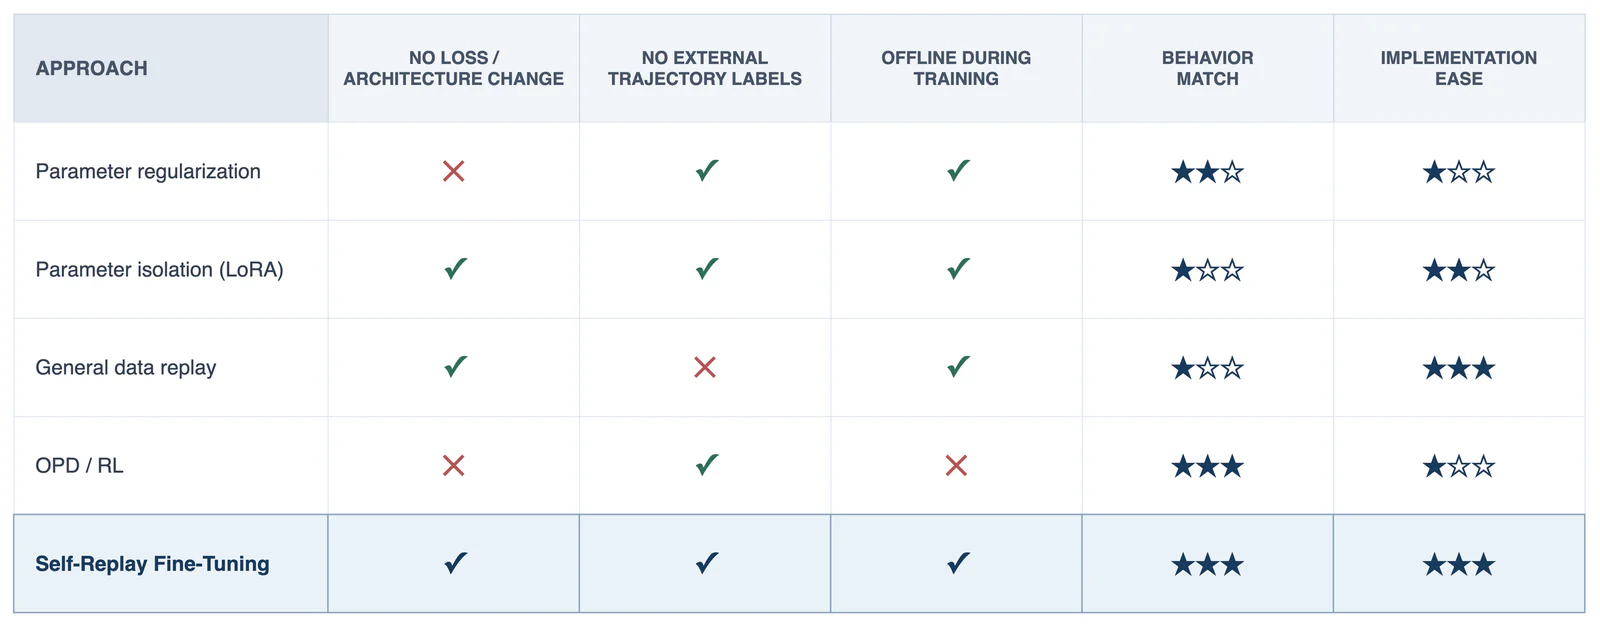
- 参数正则化(EWC)[4][4][4] Kirkpatrick, J., et al. (2017). Overcoming catastrophic forgetting in neural networks. Proceedings of the National Academy of Sciences, 114(13), 3521–3526.:惩罚参数偏离初始权重,但在多模态大模型的规模上,参数重要性的统计量很难估计和校准。
- 参数隔离(LoRA)[5][5][5] Hu, E. J., et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022.:限制权重的可变动范围,但这道上限同样可能压低任务表现。
- 数据回放[6][6][6] Rolnick, D., et al. (2019). Experience replay for continual learning. Advances in Neural Information Processing Systems, 32.:在下游微调中混入旧能力的数据,但原始训练数据可能涉密、拿不到,或不便长期保留。公开的替代数据通常是异策略(off-policy)的回答‡‡同策略与异策略:这里的「同策略」(on-policy)指标签的来源:自生成的回放回答从微调前的目标检查点一次性采样得到,在 SFT 过程中保持不变;「异策略」(off-policy)标签则来自外部模型或数据集。,在保持模型微调前的自身行为上效果较差。
- 同策略强化学习与蒸馏方法(如 GRPO 和 OPD,即同策略蒸馏)[7, 8][7, 8][7] Shao, Z., et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv preprint arXiv:2402.03300.[8] Lu, K. (2025). On-Policy Distillation. Thinking Machines Lab Technical Blog.:在模型自身的 rollout 上做优化,借助 KL 正则或蒸馏目标约束行为漂移、缓解遗忘。但同策略更新无法直接利用高质量的离线 SFT 轨迹:学习依赖模型自己探索出的行为,而在线 rollout 与打分又把数据生成和训练紧紧绑在一起,工程成本很高。
我们的出发点是一个简单的问题:怎样在引入高质量专家轨迹的同时,不损害模型已有的能力?我们让模型针对通用提示词生成候选回答,通过拒绝采样保留质量高、格式稳定的回答,再把它们作为普通 SFT 样本与任务数据混合。我们把这套做法称为自回放微调。由于回放标签来自模型自己,它们与模型原有的回答风格和分布更加吻合。这种方法只改变训练数据:不新增目标函数,不改架构,也不需要定制训练流程。下图从实用角度对比了它与其他抗遗忘方法的取舍。
抗遗忘方法一览
方法
我们在优化什么
每一次微调都要在两个量之间取舍,自回放微调的目标是让两者都朝好的方向走:
- 任务增益(Task Gain):微调后,目标任务的指标相对原模型提升了多少。
- 通用能力下降(General Drop):模型的通用能力下降了多少,取一组模型没有训练过的评测基准的平均值。
标准 SFT 通常以大幅的通用能力下降为代价,换取任务增益。自回放微调的目标是基本保住任务增益,同时把通用能力下降压到接近零。(正式定义与所报告的具体指标见附录 C。)
生成、筛选、记住
自回放微调使用两路相互独立的数据。任务数据集保留原有的输入和标签,为学习新任务提供监督。另一路把通用领域的输入交给微调前的模型,用来构造回放样本:经过采样和筛选,选中的模型生成回答成为回放目标。这些样本再与原封不动的任务数据混合,进行标准 SFT。任务标签一个都不替换。
回放现成的通用语料,就像拿陌生人的笔记复习:内容也许没错,却是用别人的口吻写的,反复操练反而会悄悄改掉你自己的习惯。自回放微调更像是复习自己做过的功课:微调之前,先让模型写出它对通用提示词的回答,我们只留下好的那些,再让它在训练中重温。因为这些材料本来就是模型自己的口吻,温习它们会强化模型原有的行为,而不是打乱它。
具体来说,自回放微调先离线完成四个构造回放数据的阶段,最后做标准的混合 SFT(图 3)。
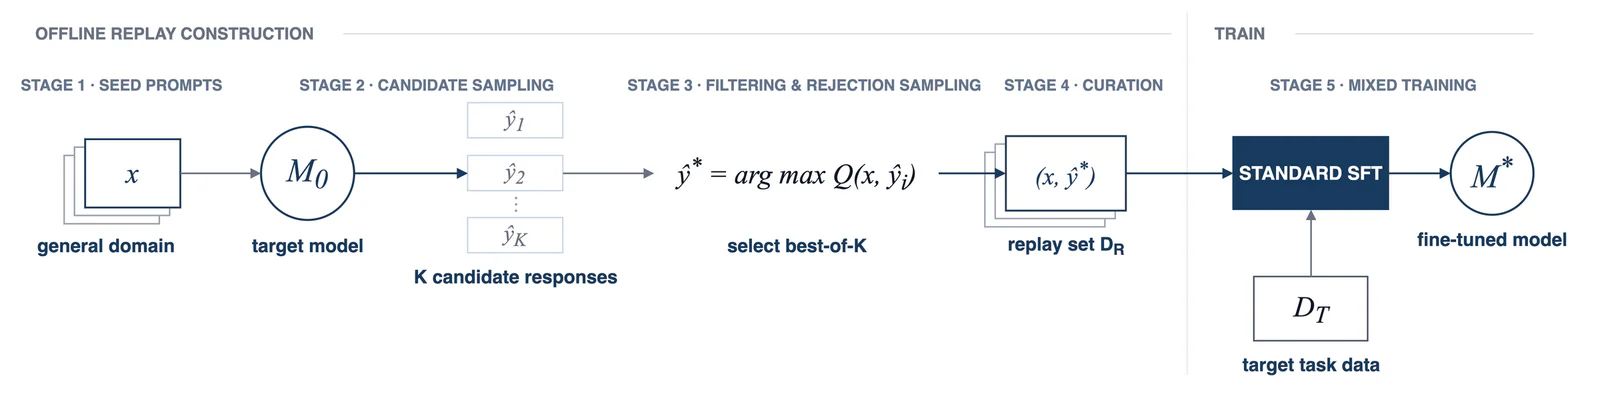
- 种子提示词。收集覆盖模型原有能力的提示词:通用指令、高频业务问题、偏好与交互数据,以及 OCR、VQA 等专项子集。
- 候选采样。对每个提示词,由即将被微调的模型生成 K 个候选回答。
- 筛选与拒绝采样。从事实正确性、格式、长度、安全性和思维链质量几个维度给候选回答打分,再从通过筛选的回答中保留最好的一个(best-of-K)。
- 整理。去重、补全元数据,并在各能力类别之间均衡配比,得到干净、可直接用于 SFT 的数据集。
- 混合训练。按 Task:Replay(任务数据 : 回放数据)比例把回放集混入任务数据,照常做 SFT。
查看伪代码
# 1. Seed prompts covering the model's original capabilities
prompts = load_seed_prompts()          # general chat, business, preference data, OCR/VQA, ...

# 2-3. Sample K candidates per prompt; keep the best one that passes every check
replay = []
for p in prompts:
    candidates = [model.generate(p, temperature=T) for _ in range(K)]
    passed = [c for c in candidates if quality_ok(c)]   # facts, format, length, safety, CoT
    if passed:
        replay.append((p, best_of(passed)))             # rejection sampling / best-of-K

# 4. Curate: dedup, fill metadata, balance across capability buckets
replay = curate(replay)

# 5. Mix with task data and run standard SFT. Nothing else changes.
train_data = task_data + alpha * replay
sft(model, train_data)
前四个阶段在训练前离线完成,得到的回放集再与任务数据混合,做标准 SFT。quality_ok 和 best_of 都是可插拔的,同一套流程可以沿用到不同的模型和验证器上。各阶段的细节见附录 B。
实验
主实验在计数(Counting)任务(物体计数,约 18 万条样本)上进行,覆盖四个模型:MiniCPM-V-4.5、MiniCPM-o-4.5、GLM-4.1V 与 Qwen3-VL-4B。所有设置的超参数完全相同,只有数据配比不同。完整设置见附录 C。
遗忘减少 80%–99%,任务增益基本不变
以 4:1 的比例加入自生成回放数据§§混合比例:Task:Replay = 4:1,即回放样本占混合训练集的 20%。后,四个模型的通用能力下降都减少了 80%–99%,任务增益的损失不到 0.8 分(图 4a)。有两个例子尤其突出:GLM-4.1V 在普通 SFT 下通用得分从 75.5 暴跌到 32.2,用自回放微调后几乎完全恢复到 73.1;Qwen3-VL-4B 的通用得分甚至略高于微调前,出现了小幅正迁移,而不是损失。
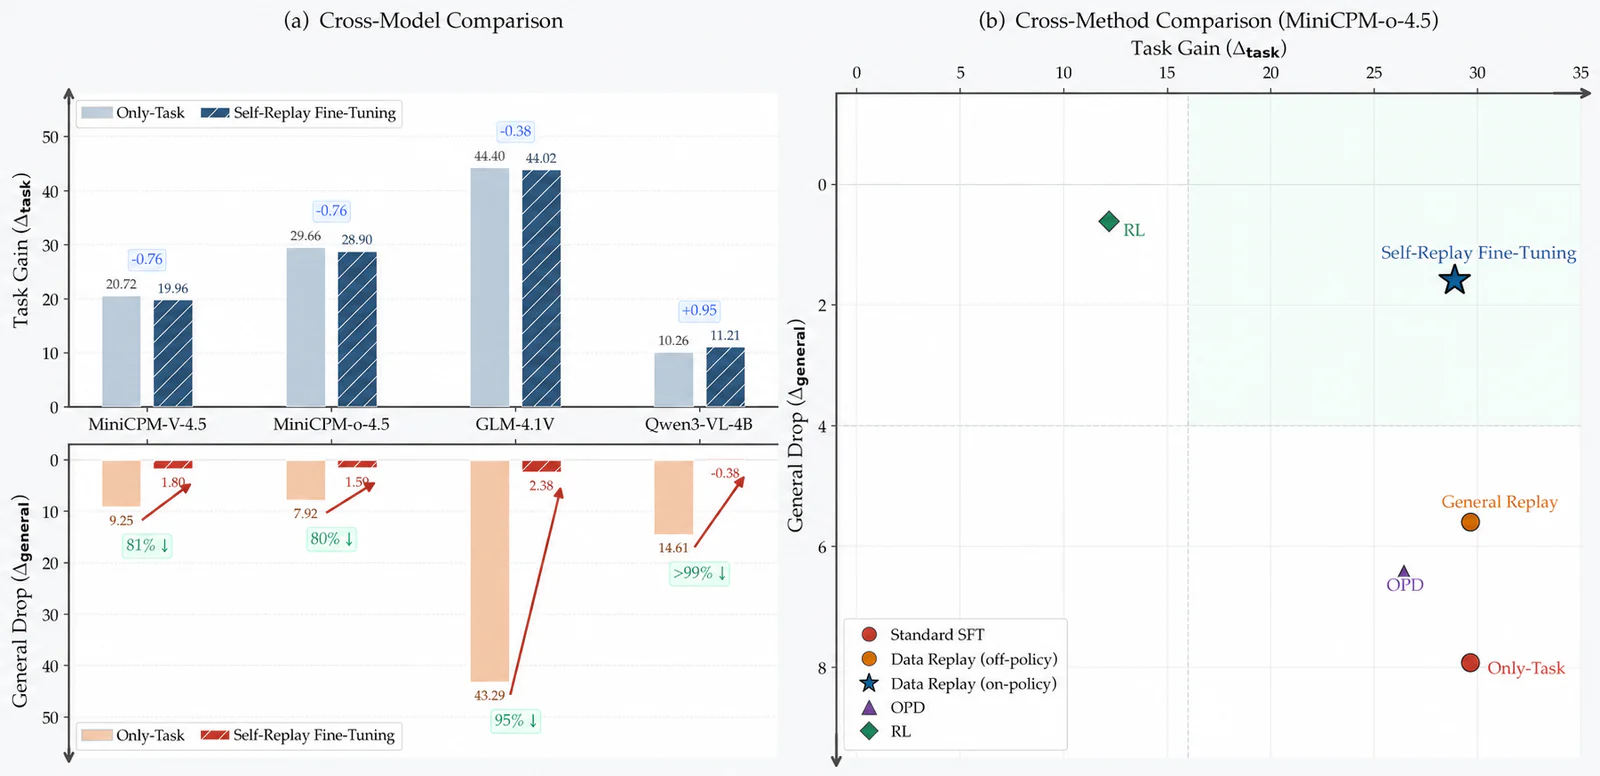
表 2. 自回放微调的跨模型对比(计数任务)。
| 模型 | 通用能力下降: Only-Task → 自回放 | 遗忘减少 | 任务增益: Only-Task → 自回放 |
|---|---|---|---|
| MiniCPM-V-4.5 | 9.25 → 1.80 | 81% | 20.72 → 19.96 |
| MiniCPM-o-4.5 | 7.92 → 1.59 | 80% | 29.66 → 28.90 |
| GLM-4.1V | 43.29 → 2.38 | 95% | 44.40 → 44.02 |
| Qwen3-VL-4B | 14.61 → −0.38 | >99% | 10.26 → 11.21 |
平均值掩盖了具体是哪些能力受损。在 GLM-4.1V 上,仅用计数数据的 SFT 让 OCRBench(识别图中文字)从 831 跌到 290,MMBench 从 86 跌到 31,MMVet(开放式视觉问答)从 68 跌到 22;自回放微调把它们分别拉回到 833、86 和 58。
这些结果说明,自回放微调在不同模型上的效果是一致的。接下来要问的是:与现有的抗遗忘方法相比,它能否在任务增益与能力保留之间取得更好的权衡?
自回放微调与其他抗遗忘方法的对比
我们在 MiniCPM-o-4.5 + 计数任务上,把自回放微调与 OPD、强化学习(RL)和异策略回放做对比,每种方法都取其最佳配置。
图 4b 显示,在评测的各种配置中,自回放微调在任务增益与能力保留之间取得了更优的权衡:任务增益高,遗忘少。其余配置至少在一个维度上表现更差。OPD 对初始化非常敏感,效果从几乎无效(Task→Base 几乎什么都没学到)到比普通 SFT 还差。强化学习保住了通用能力,但任务学得很差。异策略的通用数据回放是最接近的对手,但它造成的遗忘仍是自回放微调的约 3.5 倍。
表 3. 跨方法对比(MiniCPM-o-4.5,计数任务)。每种方法取最佳检查点。¶¶指标: 表示通用能力下降; 表示能力保留带来的收益超过了任务表现上的代价。
| 方法类别 | 方法 | 任务准确率 | Δtask | 通用得分 | Δgeneral | 净收益 |
|---|---|---|---|---|---|---|
| - | 基线(零样本) | 55.70 | - | 77.58 | 0.00 | - |
| 标准 SFT | Only-Task | 85.36 | 29.66 | 69.67 | 7.92 | - |
| OPD | Task→Base | 57.60 | 1.90 | 77.92 | −0.34 | −19.50 |
| Base→Task | 82.13 | 26.43 | 71.13 | 6.45 | −1.76 | |
| Mixed→Task | 79.66 | 23.96 | 69.16 | 8.42 | −6.21 | |
| RL | 二值奖励 | 66.54 | 10.84 | 77.40 | 0.18 | −11.09 |
| 连续奖励 | 67.87 | 12.17 | 76.96 | 0.62 | −10.20 | |
| 数据回放 | 通用数据(异策略) | 85.36 | 29.66 | 72.00 | 5.59 | 2.33 |
| 自回放微调 (同策略) | 84.60 | 28.90 | 76.00 | 1.59 | 5.57 |
图例:蓝色表示正迁移;绿色表示任务增益与能力保留兼顾得较好;红色表示在关键对比维度上最差;下划线表示净收益最高。OPD 的命名中,「X→Y」表示「教师→学生」。强化学习的命名中,二值奖励 = 0/1 精确匹配,连续奖励 = 1 − |pred − gt| / gt。
在这组对比中,自回放微调取得了最好的权衡,但汇总结果看不出这个优势从何而来。因此,我们针对标签来源、回放比例和提示词来源做了控制变量的消融实验。
收益从何而来
下面三组消融实验分别考察标签来源、回放比例和提示词来源。综合来看,结果都支持这样的看法:起重要作用的是模型自身的标签,而不只是加入了更多通用数据。所有消融实验都在 MiniCPM-o-4.5 的计数任务上进行。
关键在同策略标签,而不只是更多通用数据
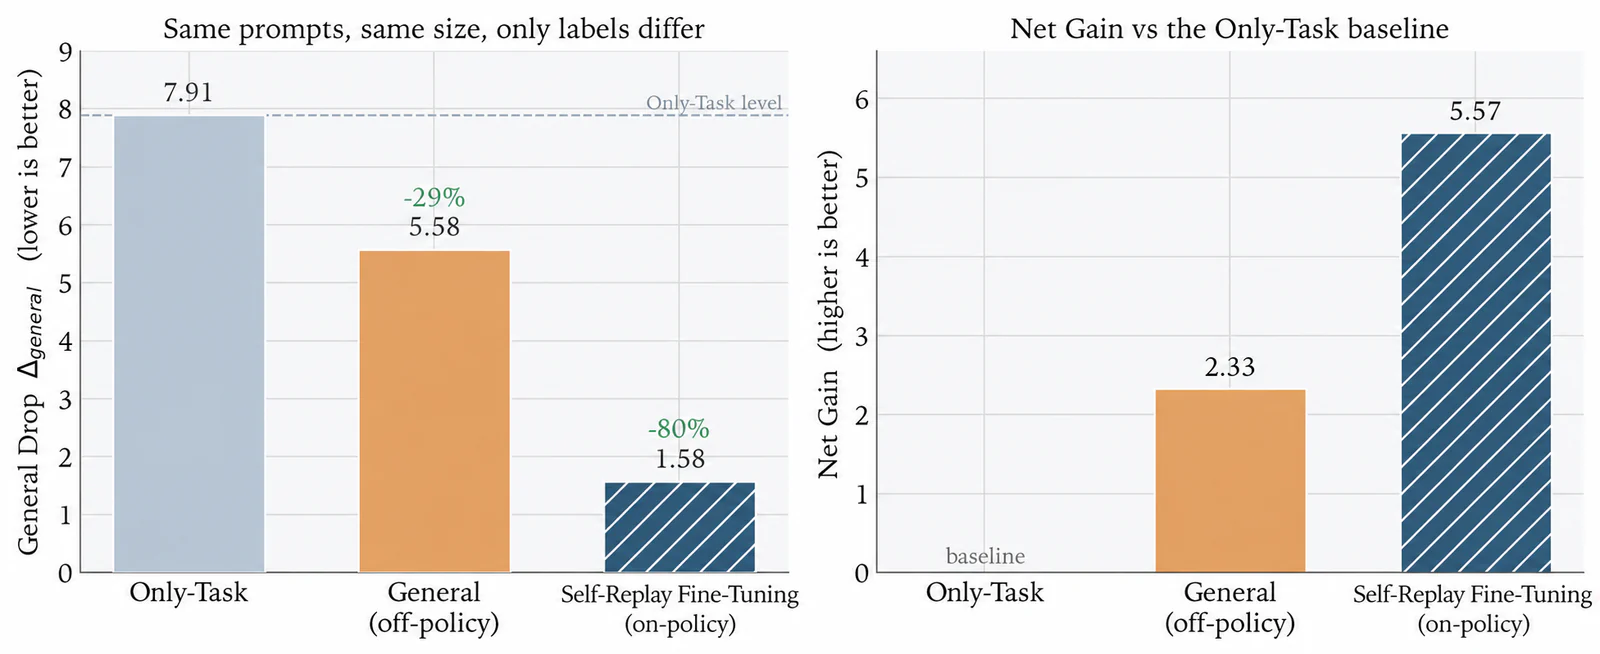
我们固定提示词集合与样本数量,只改变标签的来源:一组用模型自己的输出(同策略),另一组用开源数据里的原始答案(异策略),其余完全相同。
异策略回放有一定帮助,把通用能力下降从 7.91 降到 5.58;同策略的自生成回放标签则把它降到 1.58,降幅约 80%,任务准确率不变(图 5)。关键不在于加入通用数据,而在于加入与模型微调前自身行为相匹配的数据。
比例扫描中,4:1 的净收益最高
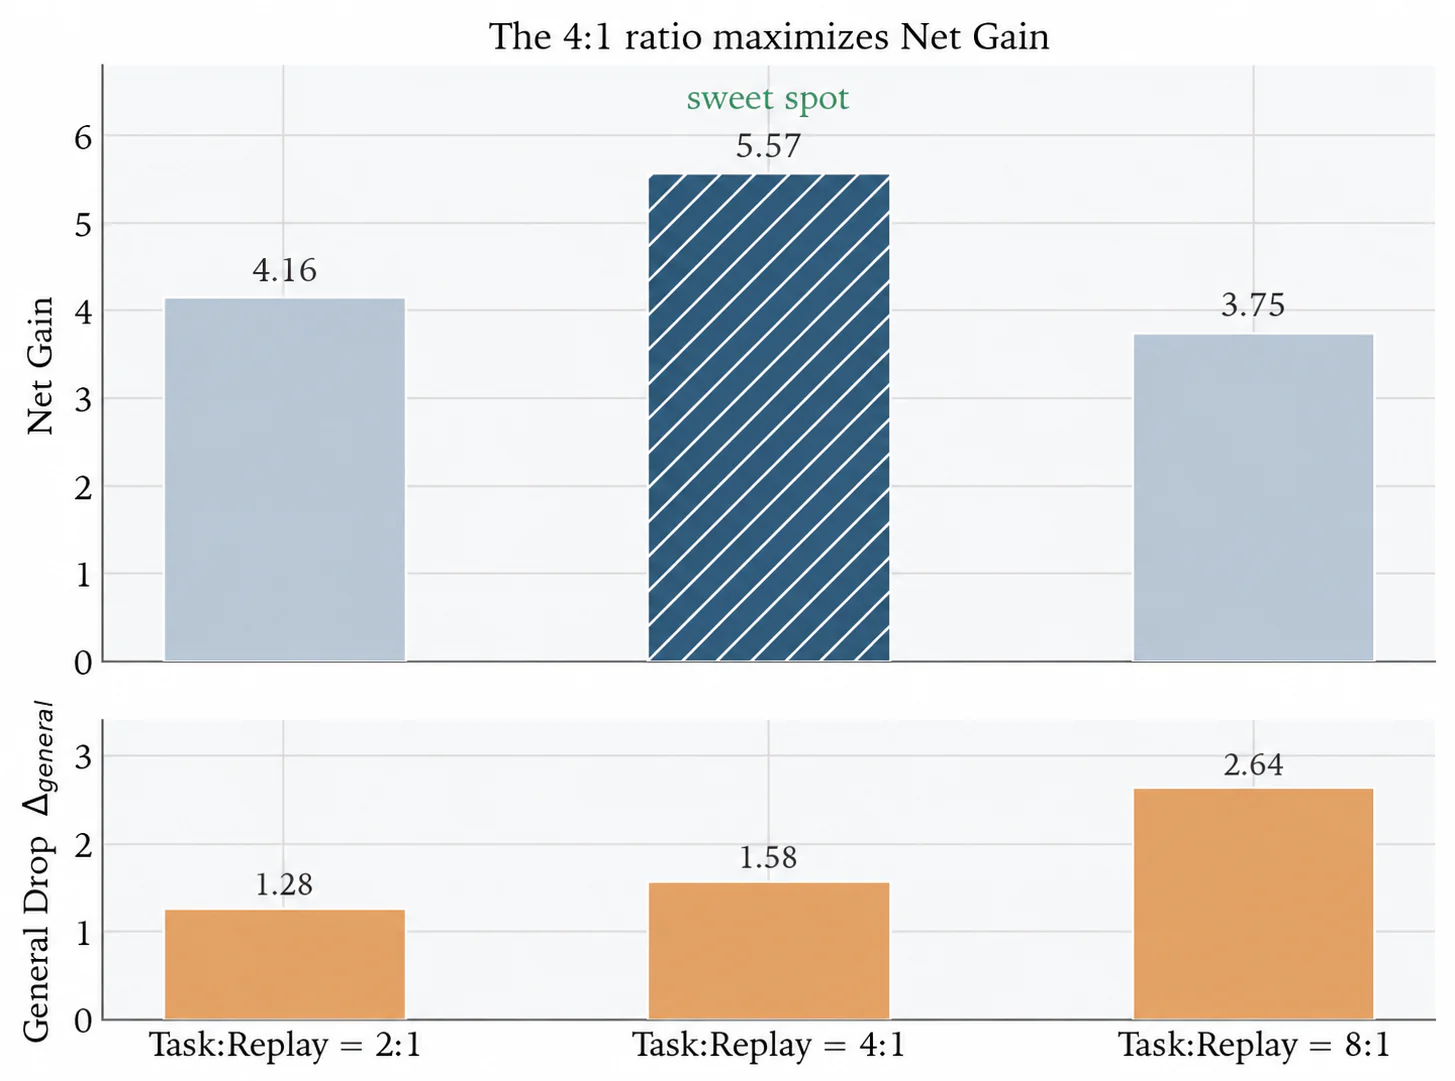
回放多少才够?固定计数数据、扫描 Task:Replay 比例,净收益在 4:1 时最高(图 6)。到 2:1 时,多出来的回放数据开始稀释任务学习;到 8:1 时,回放太少,不足以稳住模型,遗忘又回升。4:1 以最小的任务代价拿到了大部分抗遗忘收益,因此其余实验都默认使用这个比例。
提示词来源影响不大
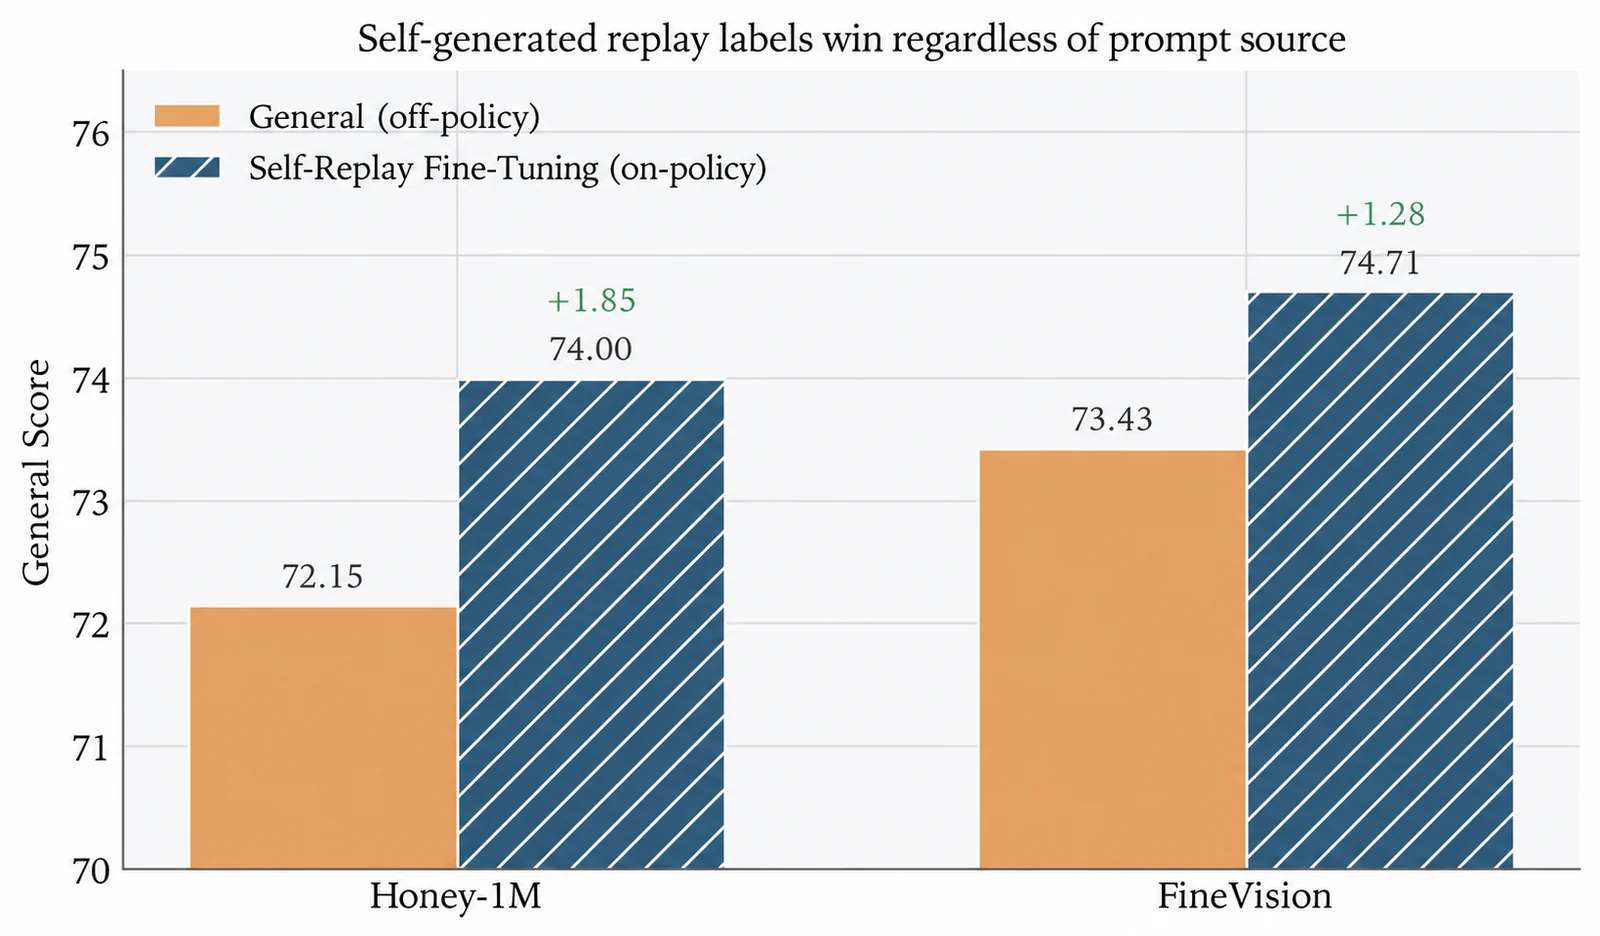
收益会不会只是来自一个恰好有利的提示词集合?为了验证,我们在 Honey-1M 和 FineVision 两个通用语料之间切换提示词来源,再次比较自生成回放标签与通用标签。两种来源下,自生成回放标签都以相近的幅度胜出,通用得分分别高出 1.85 和 1.28(图 7)。收益跟随的是标签分布,而不是提示词的出处,这与「模型自身的标签是关键因素」的假设一致。
不止于计数任务
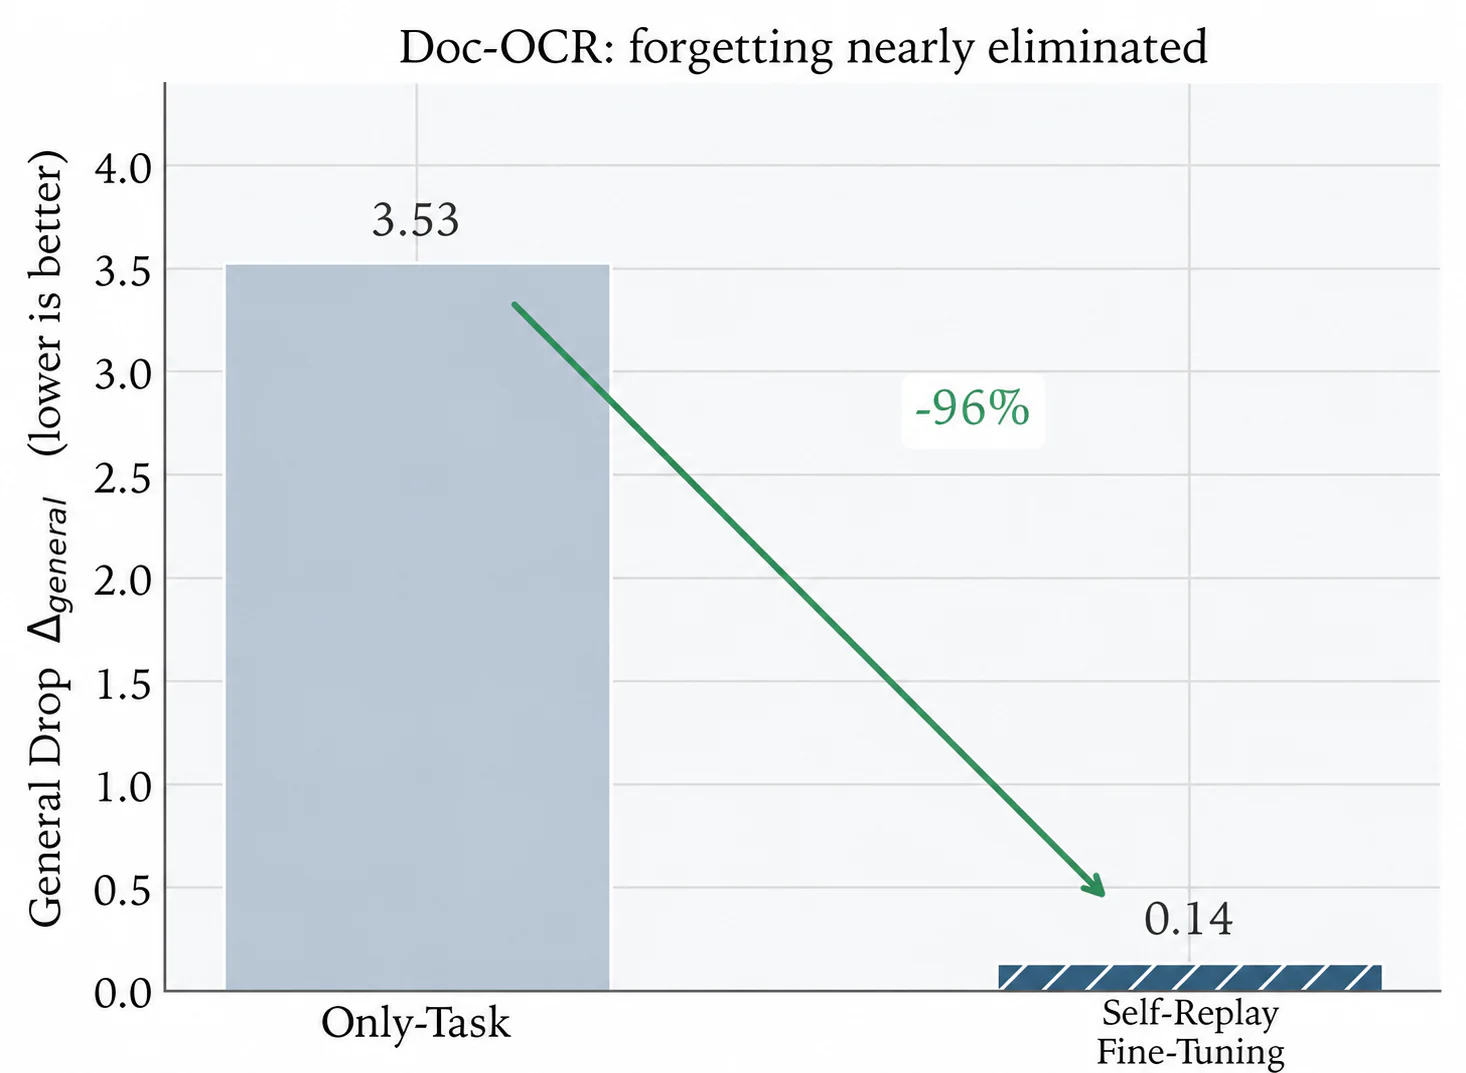
上面的消融实验找出了计数任务中起作用的因素。接下来我们想知道,同样的做法能否迁移到另一类任务。我们在 MiniCPM-V-4.5 上把它用于文档 OCR(Doc-OCR),这是一个偏重感知、与计数差别很大的任务。普通 SFT 让通用能力损失 3.53 分;自回放微调把损失降到 0.14,任务表现还略优于只用任务数据的 Only-Task(图 8)。这套做法并不是专门为计数任务调出来的。
生产环境压力测试
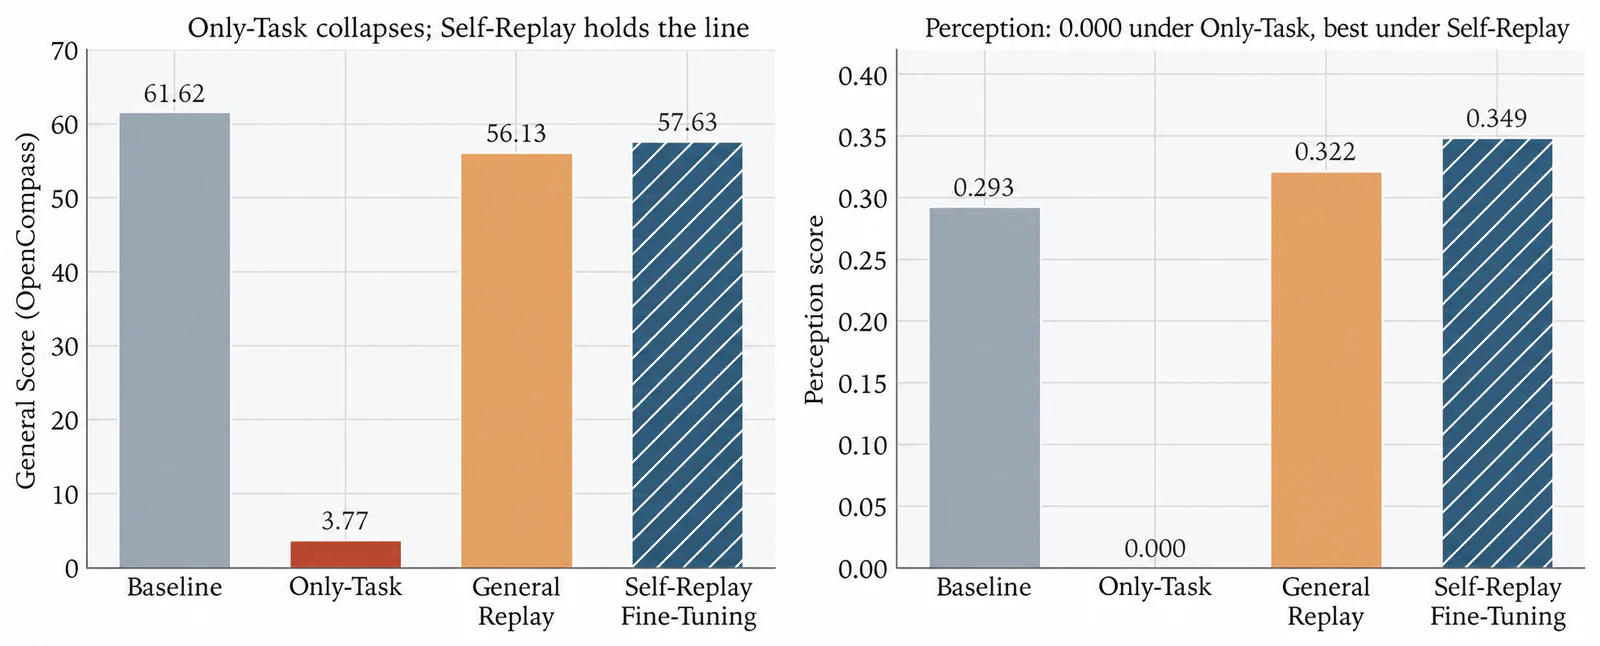
评测基准是一回事,真实部署是另一回事。我们在生产环境中运行了自回放微调,跟踪下游任务、一项感知评测和 OpenCompass 的表现。这里普通 SFT 不只是退化,而是直接崩溃:通用得分从 61.6 掉到 3.8,感知能力降为零(图 9)。两种回放策略都把模型救了回来,其中自回放微调在两方面都最好:感知得分最高,通用能力下降最小,任务准确率与其他方法持平(都在 0.94 左右)。
讨论
自回放微调为什么可能有效?
回放原始检查点生成的回答,可能让模型在学习新任务时,有自己过去行为的样例可以重温。标签来源的消融实验支持这一解释:在提示词和样本数固定、任务准确率相当的情况下,自生成回放标签把通用能力下降降到 1.58,外部标签则是 5.58(图 5)。这说明回放回答的选择是影响能力保留的重要因素,此外,回答在质量和内容上可能存在的差异也有影响。
模型重温这些回答的频率同样重要。Task:Replay 为 2:1 时,通用能力下降最低,但牺牲了更多任务增益;8:1 时,遗忘回升。在测试的比例范围内,4:1 的净收益最高(图 6)。这表明,要在学习新任务的同时保住原有能力,需要平衡回放与任务监督:提高回放占比能加强复习,但也会改变训练对新任务的专注程度。
更换提示词语料后,这一优势依然存在。在 Honey-1M 和 FineVision 上,自生成回放标签都优于外部标签,通用得分分别提高 1.85 和 1.28 分(图 7)。两种来源下的提升方向一致,说明收益不太可能只是某个语料的偶然产物,也进一步支持了回放回答的作用。至于提示词需要覆盖多广,目前还没有结论。
Doc-OCR 的结果把这一图景扩展到了计数任务之外。在 MiniCPM-V-4.5 上,自回放微调把通用能力下降从 3.53 降到 0.14,同时略微提升了 Doc-OCR 的任务指标(图 8),说明在另一组模型与任务的组合上同样有能力保留的收益。这些观察与「行为锚点」的解释,以及近期关于同策略数据的研究证据一致[9][9][9] Chen, H., Razin, N., Narasimhan, K., & Chen, D. (2025). Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting. arXiv preprint arXiv:2510.18874.。不过,它们衡量的是能力保留的结果,并不能直接证明背后的机制;更广泛的任务迁移仍需进一步评估。
局限与未来方向
自回放微调使用标准 SFT,不新增目标函数,也不修改模型,但把工作量转移到了离线的采样、筛选和整理上。提示词覆盖面与回答质量仍是实际的制约:回放集里没有覆盖到的能力,就得不到显式的复习。覆盖面合适时,同一个回放集或许可以在多个任务间复用,但两个语料的对比并不能说明覆盖到什么程度才够。
主要结果覆盖四个模型上的计数任务,另外在一个模型上做了 Doc-OCR 验证,并进行了一次生产环境压力测试。更广泛的任务迁移尚待验证;4:1 也只是本文比例扫描中的最佳设置,并非普适的最优值。
我们每次只评估一轮微调。在两轮之间用当前模型重新生成回放回答是一种可能的扩展,但刷新后的回放集也可能带上前几轮累积的能力损失。未来的工作应当测试较长的连续更新,并比较「刷新回放集」与「保留早期检查点的样本」这两种做法。
结论
自回放微调在数据层面缓解灾难性遗忘:模型自己写出回放数据,拒绝采样留下最好的回答,这些样本作为普通 SFT 样本混入任务数据。损失函数、模型架构和训练流程都不需要改动。
在四个模型、两个任务上,自回放微调把遗忘减少了 80%–99%,同时几乎完整保留了任务增益。在我们的对比中,它在评测的各种配置里取得了更优的任务增益与能力保留权衡。反复得到印证的结论很简单:与模型自身的回答分布保持一致,比数据量更重要。真正救回模型的,是回放那些本来就像它自己说出来的数据。
实践中只需:从模型采样、筛选、按约 4:1 混入,然后照常训练。微调总会把模型拉向新任务,而自回放微调给了模型一些属于它自己的东西,让它有所依凭。
附录
A. 相关工作简述
关于大语言模型(LLM)与多模态大模型(MLLM)微调中的灾难性遗忘,相关研究大致分为四类。
参数正则化(EWC、L2、KL 约束)[4][4]通过加惩罚项让权重保持在初始模型附近。它不需要额外数据,但在大规模下难以校准,估计 Fisher 信息之类的参数重要性代价也很高。
参数隔离(LoRA、适配器、冻结部分层)[5][5]限制可以变动的参数数量。训练成本低,但低秩更新可能限制多模态任务上的表现,在多任务场景下还会增加路由的复杂度。
数据回放[6][6]在新的训练中混入旧能力的数据,但原始训练数据可能涉密、拿不到,或不便长期保留;公开的替代数据通常是异策略的回答,与目标模型的行为不够贴合。后来的工作转向自生成数据:SSR 回放合成样本[10][10][10] Huang, J., et al. (2024). Mitigating Catastrophic Forgetting in Large Language Models with Self-Synthesized Rehearsal. Proceedings of ACL 2024.,DMT 分阶段进行混合[11][11][11] Dong, G., et al. (2024). How Abilities in Large Language Models are Affected by Supervised Fine-tuning Data Composition. Proceedings of ACL 2024.,SA-SFT 则强调用自生成数据抑制风格漂移[12][12][12] Sun, Y., et al. (2026). Talking to Yourself: Defying Forgetting in Large Language Models. arXiv preprint arXiv:2602.20162.。Lu(2025)也报告了一个密切相关的实验:在文档的中期训练中,混入固定的、自生成的背景回答[8][8]。这些工作的共同点是:回放数据的来源与标签风格,比单纯的数据量更重要。
同策略数据。从模型自身状态中采样的数据,能缩小训练与推理之间的差距,遗忘也更少[9, 13][9, 13][13] Shenfeld, I., Damani, M., Hübotter, J., & Agrawal, P. (2026). Self-Distillation Enables Continual Learning. arXiv preprint arXiv:2601.19897.。OPD 更进一步,在学生模型的 rollout 上提供 token 级的稠密教师监督[8][8],但把生成、打分与训练紧紧耦合在一起。
自回放微调介于离线回放与完全在线的方法之间:离线采样模型自己的回答,用拒绝采样筛选,再把它们当作普通 SFT 数据来训练。引言中的对比图总结了它在实践中关键的几个工程维度上与其他方法的差异。
B. 回放数据构造流程
本节逐一介绍五阶段流程的细节。每个阶段都是模块化的,可以换用不同的模型或验证器,而不影响其余部分。
阶段 1:构造种子数据
首先,我们构造一个广泛覆盖模型原有能力分布的提示词集合 ,来源主要包括:
- 通用指令:覆盖基础对话与问答场景的后训练提示词。
- 高频业务问题:真实场景中用户频繁发出的指令。
- 偏好与交互决策数据:用于优化回答偏好、行为选择和多步任务执行的数据。
- 专项能力子集:需要重点保住的垂直能力(如 OCR、VQA、文档解析、多轮对话)。
阶段 2:候选回答采样
对每个提示词 ,用待微调的模型 (或同系列中相近的模型)生成 个候选回答 ,为下一阶段准备候选池。我们调节采样温度与解码参数,在多样性和质量之间取得平衡;大批量采样并行运行,并支持断点续跑。
阶段 3:质量筛选与拒绝采样
我们对候选回答集合 做多维度的质量筛选,标准主要包括:
- 事实正确性:确保回答内容与客观事实或给定上下文一致。
- 格式合规:检查输出是否符合特定的结构要求(如 JSON 格式、特定的答案标签)。
- 长度与冗余控制:过滤过短、无意义的回答,以及过长、冗余的输出。
- 安全约束:剔除含有有害、偏见或越界内容的样本。
- 思维链质量:对含有
<think>过程的样本,检测明显的幻觉、逻辑断裂或循环输出。
当同一提示词有多个候选通过筛选时,我们采用 best-of- 策略,保留综合得分最高的回答,这在本质上就是一个拒绝采样过程[14][14][14] Bai, Y., et al. (2022). Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. arXiv preprint arXiv:2204.05862.。
阶段 4:整理回放数据集
经拒绝采样保留下来的高质量样本,要与原始提示词及对应的多模态输入一一对齐,并整理成标准的 SFT 训练格式,同时做以下清洗:
- 去重与近重复清洗:移除语义上高度重复的样本,避免对特定模式过拟合。
- 补全元数据:确保每条样本内容完整,并保持数据可追溯。
- 采样均衡:根据各能力子集的分布,对低频类别上采样、对高频类别下采样,保持分布均匀。
最终得到一份干净的训练集,可以直接进入 SFT 流程。
阶段 5:混合训练
最后,我们把构造好的自生成回放数据与目标任务数据 按预设比例 混合,组成训练集 ,执行标准 SFT。混合比例 (即 Task:Replay 比例)是控制任务适配与能力保留之间权衡的关键超参数,前文的消融实验已对它做了分析。
C. 实验设置
任务与数据
主实验围绕计数(Counting)任务(物体计数)展开,设置如下:
- 下游任务:计数(约 18 万条训练样本)
- 模型:MiniCPM-V 4.5、MiniCPM-o 4.5、GLM-4.1V、Qwen3-VL-4B-Instruct
- 对比设置:Only-Task、任务数据 + 通用数据回放、自回放微调
- 核心目标:衡量三种数据策略在任务增益与通用能力遗忘之间的权衡
所有实验使用相同的训练超参数,只改变数据混合策略与比例。
评测指标
所有实验都使用以下指标。记 和 分别为微调后与零样本时的指标值, 为 OpenCompass 综合得分[15][15][15] OpenCompass Contributors. (2023). OpenCompass: A Universal Evaluation Platform for Foundation Models. arXiv preprint arXiv:2308.01893.。
| 指标 | 定义 | 期望方向 |
|---|---|---|
| 任务指标:下游任务的核心性能指标(如计数准确率) | ||
| OpenCompass 通用能力综合得分,涵盖知识、推理和语言理解 | ||
| ,其中越高越好的指标取 ,越低越好的指标取 | ||
| ,即通用能力下降 | (正值表示退化) | |
| 净收益:衡量相对 Only-Task 净收益的综合指标 |
通用能力下降统一按「基线 OC 减去微调后 OC」计算,越接近 0 越好;负值表示微调后的通用评测得分反而超过了初始模型。
净收益(Net Gain)是我们引入的综合评测指标,把缓解遗忘的收益与任务表现的代价统一成一个标量,便于跨方法比较:
其中上标 OT 表示 Only-Task 基线。净收益大于 0,意味着该方法缓解的遗忘多于它牺牲的任务表现,因此越高越好。
训练细节
所有基线与消融实验都采用相同的训练设置。我们没有引入任何额外的损失项、正则约束或模型架构改动;所有模型都在相同的超参数配置下做全参数微调,区别只在训练数据的构成(即数据混合策略与比例)。
具体来说,模型使用 AdamW 优化器训练,学习率为 ,采用余弦学习率衰减,前 5% 的训练步数用于预热。训练在 8 张 NVIDIA A100(80GB)GPU 上进行,单卡 batch size 为 1,梯度累积步数为 16,全局 batch size 为 128。为降低显存开销,我们使用了 DeepSpeed ZeRO-3 优化。
注释与参考文献
注释
- † 模型:MiniCPM-V-4.5、MiniCPM-o-4.5、GLM-4.1V 与 Qwen3-VL-4B。
任务:计数(Counting)与文档 OCR(Doc-OCR)。↩ - ‡ 同策略与异策略:这里的「同策略」(on-policy)指标签的来源:自生成的回放回答从微调前的目标检查点一次性采样得到,在 SFT 过程中保持不变;「异策略」(off-policy)标签则来自外部模型或数据集。↩
- § 混合比例:Task:Replay = 4:1,即回放样本占混合训练集的 20%。↩
- ¶ 指标: 表示通用能力下降; 表示能力保留带来的收益超过了任务表现上的代价。↩
参考文献
- [1] McCloskey, M., & Cohen, N. J. (1989). Catastrophic interference in connectionist networks: The sequential learning problem. Psychology of Learning and Motivation, 24, 109–165.↩
- [2] Luo, Y., et al. (2023). An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning. arXiv preprint arXiv:2308.08747.↩
- [3] Li, H., et al. (2024). Revisiting Catastrophic Forgetting in Large Language Model Tuning. Findings of EMNLP 2024.↩
- [4] Kirkpatrick, J., et al. (2017). Overcoming catastrophic forgetting in neural networks. Proceedings of the National Academy of Sciences, 114(13), 3521–3526.↩
- [5] Hu, E. J., et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022.↩
- [6] Rolnick, D., et al. (2019). Experience replay for continual learning. Advances in Neural Information Processing Systems, 32.↩
- [7] Shao, Z., et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. arXiv preprint arXiv:2402.03300.↩
- [8] Lu, K. (2025). On-Policy Distillation. Thinking Machines Lab Technical Blog.↩
- [9] Chen, H., Razin, N., Narasimhan, K., & Chen, D. (2025). Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting. arXiv preprint arXiv:2510.18874.↩
- [10] Huang, J., et al. (2024). Mitigating Catastrophic Forgetting in Large Language Models with Self-Synthesized Rehearsal. Proceedings of ACL 2024.↩
- [11] Dong, G., et al. (2024). How Abilities in Large Language Models are Affected by Supervised Fine-tuning Data Composition. Proceedings of ACL 2024.↩
- [12] Sun, Y., et al. (2026). Talking to Yourself: Defying Forgetting in Large Language Models. arXiv preprint arXiv:2602.20162.↩
- [13] Shenfeld, I., Damani, M., Hübotter, J., & Agrawal, P. (2026). Self-Distillation Enables Continual Learning. arXiv preprint arXiv:2601.19897.↩
- [14] Bai, Y., et al. (2022). Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. arXiv preprint arXiv:2204.05862.↩
- [15] OpenCompass Contributors. (2023). OpenCompass: A Universal Evaluation Platform for Foundation Models. arXiv preprint arXiv:2308.01893.↩