6ixPulse 是一张给多伦多租房者用的智能体地图。它想解决的事很具体:选街区的时候,别靠感觉,别靠过时的盘点文章,也别靠朋友随口一句传闻。
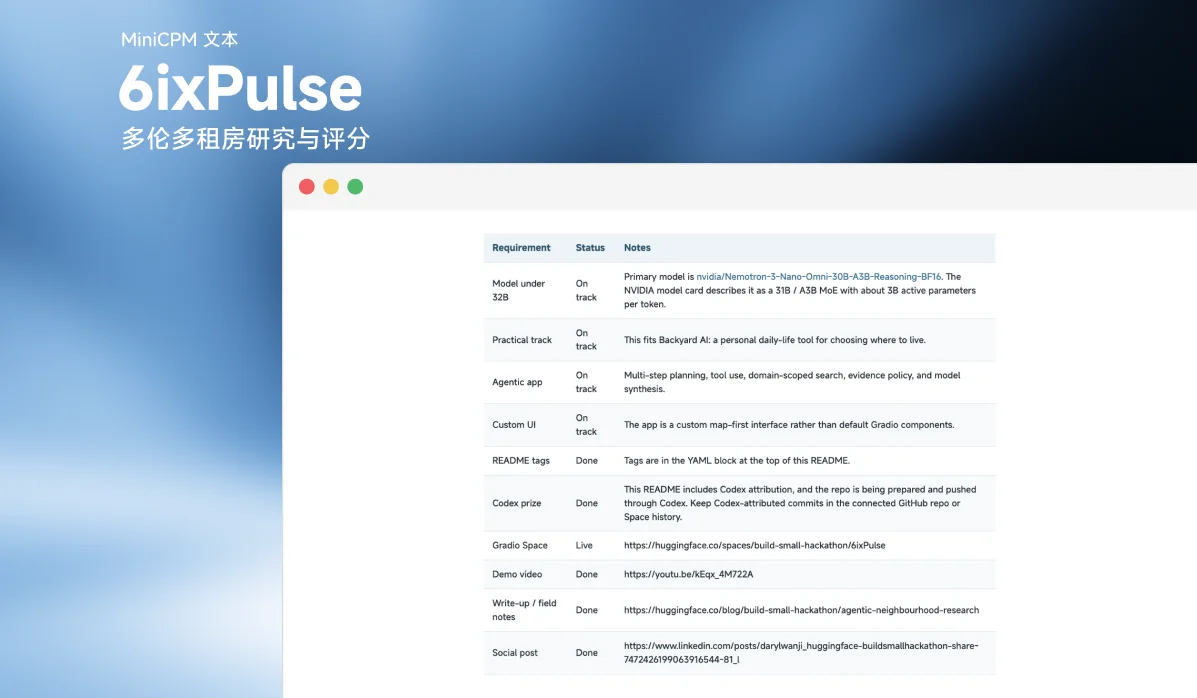
这是 Build Small Hackathon 的参赛作品,Backyard AI 赛道,定位是一个自用的日常工具:帮你决定住哪儿。
为什么做这个项目
作者当时正准备搬家。搬家之前有一大堆调研要做,而租金只是其中一项。通勤要多久、街上安不安全、街区氛围对不对、日常买东西方不方便,还有这个区到底是在变好,还是只是在变贵,都得看。
6ixPulse 把这套调研变成了一个以地图为中心的智能体流程。你可以直接这么问:
I want to move to Toronto, make $110000, work at Union Station, need safe streets,
cafes, and rent under $2600.
应用会先给多伦多的街区排序,地图跟着镜头飞向正在调研的区域,同时派出几个专职智能体分头去查:可负担性、通勤、安全、生活方式、发展潜力,最后一个负责汇总推荐。
功能亮点
- 先规划:动手之前,模型先给每个 City Agent 列清楚任务,以及要用哪些数据源。
- 自己找街区:候选区域由模型挑,坐标也由模型给。候选集合里没有任何硬编码,地图画出来的就是模型找到的结果。
- 八个维度都打分:可负担性、安全、通勤、公共交通、配套设施、生活方式、发展潜力,再加一个综合匹配度。每个候选区的每项分数,都来自一个真实、有名字、不需要 API key 的数据源。
- 每个 City Agent 只管自己那块:可负担性、通勤、安全、生活方式、发展这几个智能体,只基于自己维度的证据推理。推荐智能体放在最后跑,手里握着所有智能体的结论,还有全部数据源。
- 查不到来源就不显示:只要后端没法把某个租金、通勤、安全、发展的结论或分数对上来源证据,界面就不给它留位置。数据源一律写名字,不用“S1”这种代号。
- 真的 Mapbox GL JS 3D 地图:调研过程中,镜头会逐个放大到候选区域,再飞出去,飞向下一块。
- 结论可以听:点 Play,浏览器里直接跑 Kokoro-82M 念一段简短总结。不用 key,也不走后端。
- 所有模型都在 32B 以下:主脑是 NVIDIA Nemotron Nano Omni Reasoning(开着
enable_thinking),OpenBMB 的小模型跑在 llama.cpp 上做摘要,Kokoro-82M 负责发声。哪个服务不可用,就回退到 HF。
架构
前端 · React 19 + Vite
  租房需求输入(预算 · 通勤 · 安全 · 氛围)
  Mapbox GL JS + deck.gl(3D 地图 · 调研巡游)
  智能体卡片 · 八维评分 · 调研简报 · 对比 · 房源
        |
        v
Hugging Face Space · Docker
  gradio.Server(FastAPI):提供 React 界面 + /run_agent MCP 工具
  Node 智能体后端:POST /api/agent/run
        |
        v
智能体流水线(每一步都有 trace)
  1 规划:解析意图 + 为每个 City Agent 分配任务
  2 发现街区:模型挑选多伦多区域并给出坐标(无硬编码,坐标同步给地图)
  3 收集官方证据(Toronto Open Data、StatCan、Wikipedia)
  4 基于具名数据源为八个维度打分(Toronto Police、OSM、TTC/GO、CMHC)
  5 City Agent 扇出:各自调研自己的维度
  6 推荐智能体:权衡所有智能体结论及其全部来源
  7 证据策略:fail-closed,没有来源就没有结论
        |
        v
结果返回前端面板(Play 按钮 -> Kokoro-82M 朗读)

模型(均小于 32B)
  主模型:NVIDIA Nemotron Nano Omni Reasoning(temp 0.6 · enable_thinking · reasoning_budget),
          负责发现、扇出和推荐;回退:HF 上的 Qwen3-Coder
  辅助:OpenBMB MiniCPM(llama.cpp),为每个智能体的证据做摘要
  语音:Kokoro-82M 神经 TTS,浏览器内运行
技术栈
- 前端:React 19、TypeScript、Vite
- 地图:Mapbox GL JS、自定义 Mapbox 样式、deck.gl
- 界面:手写 CSS、lucide-react 图标,配色跟地图统一,走单色调
- 后端:Node HTTP 服务器
- Space 封装:基于 FastAPI 的
gradio.Server,Docker Space - 智能体编排:规划、发现、调研、打分、扇出、推荐,全程可追踪
- 数据:Toronto Open Data、Toronto Police、OpenStreetMap(Overpass)、CMHC、StatCan、Wikipedia,全都不用 key
- 模型(都在 32B 以下):
- 主智能体大脑:
nvidia/nemotron-3-nano-omni-30b-a3b-reasoning(build.nvidia.com) - 摘要助手:通过 llama.cpp 运行的 OpenBMB MiniCPM(
openbmb/MiniCPM4-*-GGUF) - 语音:浏览器内运行的
hexgrad/Kokoro-82M神经 TTS(transformers.js) - 回退:HF Router 上的
Qwen/Qwen3-Coder-30B-A3B-Instruct
- 主智能体大脑:
运行流程
- 用户在 Ask 6ixPulse 输入框里写下住房需求,前端调用
POST /api/agent/run。 - 规划:模型解析意图(预算、通勤上限、各项优先级权重),再给每个 City Agent 安排任务。
- 发现:模型给出符合条件的多伦多街区和坐标。候选列表没有硬编码,地图渲染的就是模型返回的结果。
- 收集证据:按区域去拉多伦多官方数据,包括 Toronto Police 犯罪率、建筑许可、TTC GTFS、StatCan,以及 Wikipedia 的坐标。
- 打分:每个候选区域对着具名数据源算完八个维度,再加权得出匹配度。
- 扇出:每个 City Agent 只基于自己那部分证据推理。推荐智能体最后跑,掌握所有结论和来源,并且开着推理模型的思考模式。
- 证据策略:结论如果对不上来源、也没有计算依据,就直接藏掉,界面上显示为“needs source”。
- 地图、智能体卡片、八维评分、调研简报和对比视图,都由同一份带来源引用的结构化结果驱动。
有据可查的展示策略
6ixPulse 在这一点上是故意的:失败即关闭。
本地的街区数据只用来启动流程,不当事实用。只要后端没法把某类信息对上来源证据或计算结果,应用就不展示租金区间、通勤评分、安全结论、发展结论,也不展示最终的智能体评分。
住房这件事,决策成本太高。一张看着漂亮、其实在硬撑自信的地图,不如一张老老实实说“这块还没查清楚”的地图。
数据来源与评分
界面上每个维度都由真实、无需 key 的数据源算出来,并且标出来源名字:
| 维度 | 数据源 |
|---|---|
| 安全 | Toronto Police Service 街区犯罪率(Toronto Open Data) |
| 通勤 | 经由 TTC + GO(Metrolinx)网络到 Union Station 的距离 |
| 公共交通 | 来自 OpenStreetMap 的 TTC 站点 |
| 配套设施 · 生活方式 · 发展潜力 | OpenStreetMap(Overpass):咖啡馆、餐厅、公园、杂货店、在建工地 |
| 可负担性 | CMHC 租赁市场数据 + 距市中心距离 / 密度模型 |
| 匹配度 | 以上各项加权合成,权重来自租房者自己写的优先级 |
| 坐标 | Wikipedia REST(把发现的区域标到地图上) |
这些都是官方公开 API,所以托管版 Space 不用爬虫,也不碰任何绕过手段。也可以打开需要 key 的网页搜索(Google CSE、SerpAPI、Brave、Tavily)补充上下文,但默认关闭,也不是必需的。
模型
两层,都在 32B 参数以下:
# Main agentic brain: NVIDIA Nemotron Nano Omni Reasoning (build.nvidia.com).
# Used for discovery, the per-agent findings, and the final recommendation (with thinking).
AGENT_MODEL_PROVIDER=auto              # tries Nemotron first, then HF
NVIDIA_API_KEY=your_nvapi_key
NVIDIA_MODEL=nvidia/nemotron-3-nano-omni-30b-a3b-reasoning
NVIDIA_BASE_URL=https://integrate.api.nvidia.com/v1
NVIDIA_ENABLE_THINKING=1              # temperature 0.6, top_p 0.95, reasoning_budget

# Summarisation assistant: small OpenBMB model through the llama.cpp runtime.
LLAMACPP_ENABLED=1
LLAMACPP_MODEL=openbmb/MiniCPM4-0.5B  # or MiniCPM4-8B-GGUF for stronger summaries
AGENT_SUMMARIZER_PROVIDER=llamacpp

# Fallback when no key/runtime is available, so the app always responds.
HF_TOKEN=your_hugging_face_token
HF_MODEL=Qwen/Qwen3-Coder-30B-A3B-Instruct
- 摘要助手:OpenBMB 的 MiniCPM4-0.5B,跑在 llama.cpp 上,给每个智能体的证据做摘要。想要更强的摘要效果,换成 MiniCPM4-8B-GGUF 就行。
- 推理模型:用 Nemotron 推荐的配置(跟
ChatNVIDIA一致):temperature=0.6、top_p=0.95、chat_template_kwargs={"enable_thinking": true}和reasoning_budget。它的<think推理内容和 JSON 答案分开捕获。思考模式只在决策环节开(发现、推荐、综合),各智能体的扇出在托管 API 上并行跑,所以一次完整运行还在响应时间预算之内。 - 语音:Play 按钮经
transformers.js调hexgrad/Kokoro-82M,全程在浏览器里跑(ONNX/WASM)。模型懒加载,约 80 MB,第一次点 Play 才下载并缓存。加载期间或跑不起来的时候,回退到浏览器自带的语音合成。不用 key,不走后端,只有 82M 参数。
Gradio Space
项目用 gradio.Server 部署成 Docker Gradio Space。这个入口本来就是给 React 这类自定义前端准备的,同时还能用上 Gradio 的 API 引擎、队列、MCP 支持和 Hugging Face Spaces 托管。入口文件是 app.py,它负责:
- 在
127.0.0.1:8787起 Node 智能体后端 - 从
dist/提供构建好的 React 应用 - 从 Space secrets 注入运行时的 Mapbox 配置
- 把前端发往
/api/agent/run的请求转给后端 - 暴露一个叫
/run_agent的 Gradio API 端点,同时作为 MCP 工具
必需的 Space secrets:
VITE_MAPBOX_TOKEN=your_mapbox_token
NVIDIA_API_KEY=your_nvidia_api_key
推荐的 Space 变量(Docker 镜像里已经设好):
AGENT_MODEL_PROVIDER=auto
NVIDIA_MODEL=nvidia/nemotron-3-nano-omni-30b-a3b-reasoning
NVIDIA_BASE_URL=https://integrate.api.nvidia.com/v1
NVIDIA_ENABLE_THINKING=1
AGENT_DISCOVER=1
AGENT_FANOUT=1
SEARCH_PROVIDER=disabled        # official-data-only; no scraping on the hosted Space
OFFICIAL_DATA_ENABLED=1
想在本地按 Space 的方式跑,启动后打开 http://127.0.0.1:7860/:
npm install
npm run build
python -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
python app.py
本地开发
npm install
cp .env.example .env
npm run dev:full
打开 http://127.0.0.1:5173/。跑之前先把 Mapbox token 配上:
VITE_MAPBOX_TOKEN=your_token_here
VITE_MAPBOX_STYLE_URL=mapbox://styles/ownpath/cmqe4wg8h005001s4bjx9461m
也可以前后端分开起,再各自做一次健康检查:
npm run dev:api
npm run dev

curl http://127.0.0.1:8787/api/agent/health
curl http://127.0.0.1:8787/api/agent/search/health
项目结构
app.py                         Gradio Server wrapper for the Space runtime
Dockerfile                     Docker Space image with Node + Python
src/App.tsx                    app shell, agent panels, scores, listings
src/components/MapCanvas.tsx   Mapbox/deck.gl map + research tour
src/lib/agentApi.ts            frontend API client types
src/lib/tts.ts                 Kokoro-82M in-browser narration
server/index.mjs               agent API server; orchestrates the pipeline
server/discover.mjs            model-driven neighbourhood discovery (+ coordinates)
server/score-tools.mjs         8-dimension scoring from named no-key sources
server/agent-fanout.mjs        per-agent City Agents + Recommendation agent
server/model-chat.mjs          provider routing: main brain vs. summariser
server/agent-core.mjs          plan, trace, and the fail-closed evidence policy
server/research-tools.mjs      Toronto Open Data + crime rates + coordinates
server/nvidia-client.mjs       NVIDIA Nemotron (reasoning) client
server/llamacpp-client.mjs     llama.cpp / OpenBMB client
server/hf-client.mjs           Hugging Face Router fallback client
scripts/dev-full.mjs           starts frontend and backend together
scripts/llama-server.sh        launches a local OpenBMB GGUF via llama.cpp
开发说明
实现、调试、验证和仓库整理这几件事上,项目借了 OpenAI Codex 的力。产品方向、最终决策和提交审核,由作者本人负责。
相关链接
- Hugging Face Space:build-small-hackathon/6ixPulse
- 演示视频:YouTube
- 构建笔记:HF 博客文章
- 社交帖子:LinkedIn