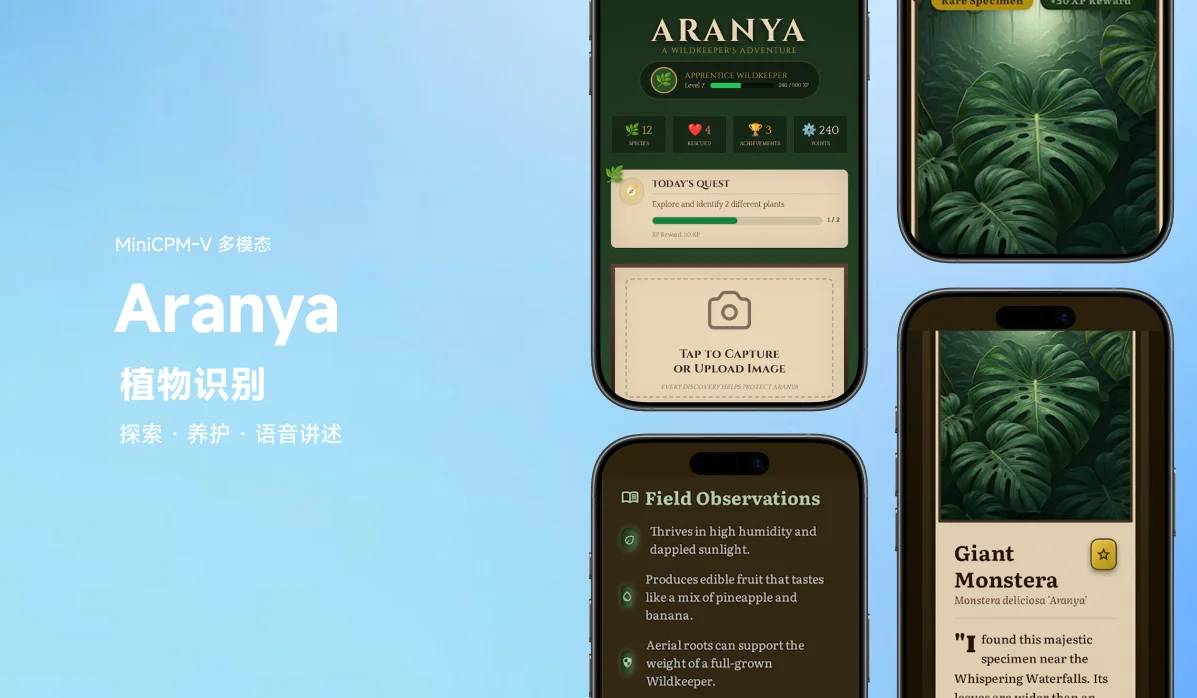
Aranya 是 Build Small Hackathon 上的一个植物探险应用。它基于两个微调过的 MiniCPM-V 4.6(各约 1.3B 参数):拍一张照片,就能识别植物或者诊断健康问题,再用语音把结果讲给你听。
背景:植物养护是一场探险
有个数据挺扎人:平均每位植物主人至少养死过 7 盆。原因大多不是不上心,而是拿不准。水浇多了、品种认错了、病害早期的征兆看漏了,都可能要命。光美国就有 8,600 万户人家在窗台上养植物,大多数人只能边养边猜。
作者想验证的问题很直接:一个 1.3B 的视觉语言模型,在社区知识上微调之后,能不能真的把植物识别和健康诊断做到有用?又能不能把这件事做得不像在“做作业”?答案是能,但有前提。
市面上的植物养护应用大多很“临床”:扫一片叶子,出来一段文字,然后关掉。留不住人的问题不在信息,在参与感。于是作者搬出了“Wildkeeper”(荒野守护者)这个设定:每次把手机对准一株植物,你不是在“扫描”,而是在“发现”它。围绕这个设定,体验上做了几件事:
- 语音讲述:植物的故事用 TTS 听,不用读
- 发现日志:物种计数、救助计数,攒成你自己的植物记录
- 讲故事标签页:民间传说、“植物超能力”(药用 / 生态用途)、趣味知识、养护建议
- 社区排行榜:探险路上有同伴,确实更有意思
数据:从社区知识中得到 31 万条训练对话
Aranya 的本事不来自某个大预训练模型,而来自一个在真实植物讨论上微调过的专家模型。
来源与规模
作者从在线植物养护社区收集了约 80.6 万条带图帖子。一条帖子通常有植物照片、主人对问题的描述,还有社区回复,不少回复来自有经验的种植者,诊断写得很细。原始社区数据信噪比很低,得一步一步清洗。
分类层
- 阶段 1:基于规则的分类。用带社区先验的关键词打分,把帖子分成五类:病害 / 胁迫、物种识别、展示、一般养护问题、其他。
- 阶段 2:机器学习精修。在高置信度的规则标签上训练 TF-IDF + Logistic Regression 模型,把模糊的帖子重新过一遍;只有概率高于 0.60 的预测才会被重新标注。
最后留下 23.9 万条病害 / 胁迫帖子和 30.4 万条物种识别帖子。
用 Gemini Batch API 合成训练数据
社区原帖又乱又散,一条帖子里好几个人说话,没有结构,得先提炼成干净的 user / assistant 训练对。作者在 Vertex AI 的 Batch Prediction API 上跑 Gemini 2.5 Flash Lite,让大模型把社区知识蒸馏成小模型能用的训练数据。这算合成数据,但底子是真实样例。给模型的关键指令只有一条:回答必须引用图片里看得见的东西,别照搬教科书。
两个批任务并行跑:
- 病害诊断:28.8 万条请求
- 植物识别:25 万条请求
每个批文件 5 万条请求,temperature 压到 0.4 来保证一致性。Batch API 打五折,这个规模才跑得起。最后得到 22.8 万条病害训练记录和 10.5 万条识别训练记录,接受率 92%,其余因为不相关或者格式错误被筛掉。
完整流水线:
- 社区植物帖子(约 80.6 万)
- 分类(规则 + ML)→ 23.9 万病害帖 + 30.4 万识别帖
- Gemini Batch API(Vertex AI)→ 31 万+ 多模态训练对话
- 在 Modal(L40S)上用 ms-swift 做 LoRA → 两个微调 adapter
- 合并 + GGUF 量化 → F16 + Q8_0 权重发布到 Hugging Face Hub
微调:在 MiniCPM-V 4.6 上做 LoRA
为什么选 MiniCPM-V 4.6
作者要的视觉语言模型得满足几条:参数远低于黑客松 32B 的上限,原生支持多模态输入(图像 + 文本进,文本出),许可证宽松,而且小体量下效果够好、值得一调。MiniCPM-V 4.6 全中:1.32B 参数,一张消费级 GPU 就装得下;视觉塔、语言模型加 aligner 这套架构也扎实,视觉语言任务上的表现超出了它的体量。
LoRA 配置
训练用 ms-swift v4.2.3,LoRA 后端是 PEFT,全程跑在 Modal 的 L40S GPU 上。
| 参数 | 值 |
|---|---|
| LoRA Rank | 16 |
| LoRA Alpha | 32(缩放比 2x) |
| Dropout | 0.05 |
| 目标模块 | 全部 linear 层 |
| 视觉塔 | 解冻(应用 LoRA) |
| Aligner | 冻结 |
| 可训练参数 | 约 20.3M(占模型 1.54%) |
这里作者做了一个跟多数人不一样的选择:视觉塔也加 LoRA。微调时把视觉编码器冻住是常规操作,但植物照片和 MiniCPM-V 预训练见过的网络图片差得太远。社区帖子里多是光线差、糊了、手机怼着病叶拍的特写。视觉上的域偏移够明显,所以视觉塔也一起适配;只冻结 aligner,保住已经学到的视觉-语言对齐,让视觉编码器和语言模型各自专精。
训练过程
| 项目 | 植物病害 | 植物识别 |
|---|---|---|
| 数据量 | 约 21 万条 | 约 10 万条 |
| Epoch | 1 | 2 |
| 步数 | 1,641 | 1,576 |
| 学习率 | 2e-6 | 2e-6 |
| 学习率策略 | cosine,3% warmup | cosine,3% warmup |
| 有效 batch | 128(8 × 16 梯度累积) | 128 |
| 耗时 | 26.7 小时 | 22.6 小时 |
| 最终 train loss | 0.79 | 1.54 |
| 最终 eval loss | 1.40 | 1.31 |
| 最终 token 准确率 | 63.1% | 66.7% |
2e-6 是刻意压低的。1.3B 的模型配 20 万+ 样本,数据量已经够了,学习率没必要激进,也不想过早冲过好的 loss 区间。
评测结果
两个任务各留 300 个测试样本,拿基础版 MiniCPM-V 4.6 和微调后的模型对比:
| 指标 | 病害:基础 → 微调 | 识别:基础 → 微调 |
|---|---|---|
| BLEU | 2.52 → 3.87(+53.9%) | 1.69 → 2.30(+36.3%) |
| ROUGE-1 | 0.298 → 0.357(+19.6%) | 0.240 → 0.237 |
| ROUGE-2 | 0.063 → 0.089(+40.8%) | 0.053 → 0.064(+21.3%) |
| ROUGE-L | 0.153 → 0.163(+6.7%) | 0.144 → 0.140 |
| MoverScore | 0.531 → 0.539 | 0.519 → 0.520 |
病害模型的提升更全面,因为病害诊断要用到基础模型见得少的专门词,比如“root rot”“fungal infection”“overwatering damage”。识别模型主要在 BLEU 和 ROUGE-2(短语级精度)上涨,ROUGE-1 基本持平:它更会把识别结果组对成多词短语,而单词表本身变化不大。
合并与量化
训练完,在 Modal 上把 LoRA adapter 合回基础权重:
swift export \
  --model openbmb/MiniCPM-V-4.6 \
  --adapter checkpoint-1641 \
  --merge_lora true \
  --output_dir merged-checkpoint-1641
再用 llama.cpp 的转换工具导出 GGUF:
- F16:全精度,给 ZeroGPU 用(显存不是瓶颈)
- Q8_0:8-bit 量化,用于本地部署
- Q4_K_M:激进量化,留给资源极其受限的场景
- mmproj:视觉投影器,单独导出
发布的模型:ankurkaul17/minicpm-v-4.6-pdd-gguf(病害 / 健康)、ankurkaul17/minicpm-v-4.6-pid-gguf(识别)。
应用:把一切串起来
架构
Aranya 跑在 Hugging Face 上,形式是 Gradio Space,但看起来一点都不像 Gradio 应用。作者把 gr.Server 当无界面的 FastAPI 宿主用,部署、ZeroGPU 生命周期和 OAuth 都交给它,前端则完全自己写(原生 HTML/CSS/JS)。
- 浏览器上传图片、选好模式,向
POST /aranya/run发请求 - 服务端先处理图片(EXIF 转正、中心裁剪、缩放到 1024px),转成 base64 data URI,连同文本提示一起送进去
- 推理走 llama-cpp-python 的
MTMDChatHandler,跑 MiniCPM-V GGUF,GPU 由 ZeroGPU 按需给 - Pocket TTS(约 100M 参数)在 CPU 上流式合成语音
- 文本和音频以 NDJSON 流返回浏览器
流式管线
LLM 一个一个往外吐 token,TTS 这边却要拿到句子长度的片段才合成得自然,前端还得让文字出现和音频播放对上。作者的做法是让几个并行的生产者汇进同一条 NDJSON 流:
- LLM 把文本增量写进缓冲区
- “可朗读分段器”从缓冲区里切出自然的短语边界(最少 32 字符、最多 350 字符,在 TTS 延迟和韵律之间找平衡)
- 每个片段交给 Pocket TTS 生成 PCM 音频
- 文本增量和音频块都作为 NDJSON 事件发给客户端
- 前端按每字符 80ms 的速度逐字显示,等音频播放追上来,再用 Web Audio API 把显示速度跟音频对齐
这一套在 asyncio 里像耍马戏:队列、生产者、消费者、背压,一样不少。落到体验上倒是顺的,你听到的那句话,正好就在屏幕上出现。
还有个很坑的 bug:llama-cpp-python 的多模态处理有个怪癖,混合模型一重置状态就会把图像嵌入清掉。作者只能 monkey-patch Llama.generate(),在整个生成循环里保住多模态上下文。文档里查不到这个,是花了好几小时排查“模型为什么看不见图片”才摸出来的。
离线运行
核心推理不碰任何外部 API:识别模型、诊断模型和 TTS 引擎都在 Space 里跑。唯一的外部调用在后面那些内容上(趣味知识、神话之类),走 DuckDuckGo 搜索,再让基础版 MiniCPM-V 当工具模型。前端资源也做了本地化,图片以 base64 内联,只有 Markdown 渲染用的 marked.js 来自 CDN。
SQLite 存储
发现、救助和排行榜记录都存在开启 WAL 模式的 SQLite 里。流式生成期间可以并发读,也方便自动备份和损坏恢复。Hugging Face Spaces 的 /data 持久卷在冷启动后有时状态不对,作者为此加了残留 WAL sidecar 清理和自动恢复。
讲故事:让植物养护有点意思
传统植物养护应用把“把信息给你”当成产品本身。可人记不住这么给出来的信息,人记得住故事。Aranya 把每次交互都放进叙事里:识别一株植物,你拿到的不是一张数据表,而是一段语音解释,讲模型看到了什么、怎么得出结论、这株植物为什么有意思。
识别之后,四个讲故事标签页接着往下带(都由工具模型结合网络搜索按需生成):
- Did You Know?:让你重新看待这株植物的惊人事实
- Keep It Happy:把养护讲成一段关系(“你的龟背竹喜欢湿度,因为……”)
- Stories & Legends:跨文明的神话、民间传说与文化意义
- Plant Superpowers:药用、生态作用和烹饪用途
游戏化做得很克制:你是一名 Wildkeeper,每次扫描要么算一次“Discovery”(识别),要么算一次“Rescue”(健康诊断)。数字会涨,排行榜上能看到自己的位置,但没有刷经验值,也没有人为设的关卡。
作者觉得这块设计空间被低估了。他引了一句话:“A slightly worse model wrapped in a compelling narrative will outperform a better model behind a clinical interface.” 至少对消费级应用来说,这话成立。
局限性
- 小模型有上限:MiniCPM-V 4.6 是紧凑模型,碰上罕见病害、模糊的症状或者长得像的物种,可能就吃力了
- 训练数据有偏差:在社区帖子上微调,准确度会随物种的流行程度和图片质量浮动
- 冷启动慢:Spaces 上的 ZeroGPU 和模型加载会让首次请求等上一会儿
- 音质:语音效果取决于克隆样本,遇到生僻的植物名,Pocket TTS 可能念出瑕疵
- 流式边界情况:回答太长或太短时,文字和音频可能对不上
写在最后
感谢 Hugging Face、OpenAI、Modal 与 OpenBMB 提供的算力、额度与模型支持。
- 在线体验:Hugging Face Space
- 演示视频:YouTube
- 原文博客:Aranya: Teaching a Small Model to See Plants and Tell Their Stories
- 代码:allthatido/sounth_pddm
- 作者:Ankur Kaul