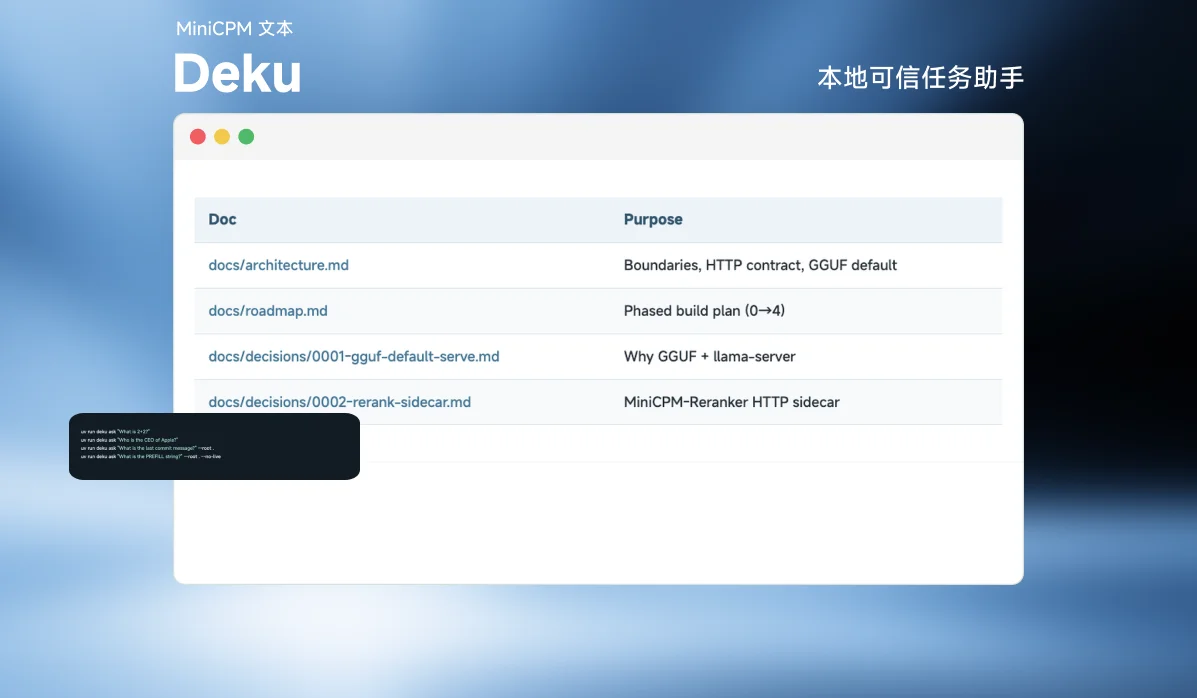
deku 是一个给 MiniCPM5-1B 写的本地任务 harness,只接小型事实类任务:网页事实查询、URL 摘要、仓库检索、git / diff 查询,以及简单的多步任务。请求超出它的能力范围时,它会明确拒答,并说明理由。核心思路是:规划和工具选择都写在代码里,模型只负责补一段简短、有依据的内容。
状态:第 2 阶段的 Agent 核心已经合入(
deku ask、路由 / 拒答 / 工具)。能力测试要在默认 GGUF 路径上实测,不要照搬只在 MLX 上得到的分数。
设计概览
| 层级 | 职责 |
|---|---|
| Agent / harness | 路由、拒答、工具调用、简单多跳编排、整合答案 |
| LLM 客户端 | 只使用 OpenAI 兼容 HTTP 接口(/v1/chat/completions) |
| 默认服务 | 官方 GGUF + llama-server |
harness 不管 HTTP API 是怎么实现的(llama.cpp、oMLX 或者其他 OpenAI 兼容服务都行),但语义是按 MiniCPM5-1B 调的:以英文为主,不做自由形式的长推理,不写代码。
默认后端:
- 权重:
openbmb/MiniCPM5-1B-GGUF - 推荐量化:
MiniCPM5-1B-Q4_K_M.gguf(约 657 MB) - 服务:原版 llama.cpp 的
llama-server,加--jinja参数(与 OpenBMB 的 llama.cpp 部署指南 一致)
想换成别的 OpenAI 兼容 MiniCPM5-1B 服务,用环境变量指定就行;MLX 只是给 Apple Silicon 开发者的可选路径,不是默认方案。
工作原理
处理流程:
- 用户提问:进入路由 / 拒答判断;
- 需要工具时,调用 web / url / dir / git / diff / 多跳 等工具;
- 工具结果整理成有依据的证据;
- MiniCPM 做简短补全,只压缩或抽取有依据的短片段;
- 输出答案或拒答。
工具选择和证据构建由 harness 完成,MiniCPM 不写多步计划。
目标能力
- 公开的简短事实(
web_search) - 总结给定 URL 或本地 README(
url_read/dir_search+ 分层摘要) - 仓库常量 / 概览(
dir_search) - 最近一次提交、blame 类问题(
git_search);已暂存 / 未暂存的 diff(diff_search) - 简单多步任务:按规则构建计划,能在多跳之间绑定代词,最后用编号列表或段落整合答案
- 带理由拒答:数学、写代码、闲聊、开放式长文 / 证明
快速开始
需要 mise(用来固定 Python 和 uv 版本),以及 PATH 里可用的 llama-server。第一次启动服务会下载一次权重(约 657 MB)。
Bash
mise trust && mise install    # python 3.12 + uv
mise run sync                 # uv sync → .venv + editable install
brew install llama.cpp        # 提供 llama-server
mise run serve                # 下载 Q4_K_M 并启动 llama-server --jinja
服务起来后就能提问(拒答和一部分词法路径可以离线工作):
Bash
uv run deku ask "Who is the CEO of Apple?"
uv run deku ask "What is the last commit message?" --root .
常用环境变量:
| 变量 | 作用 | 默认值 |
|---|---|---|
DEKU_URL | API 地址(不含 /v1) | http://127.0.0.1:8080 |
DEKU_MODEL | 发送给服务的模型 ID | MiniCPM5-1B |
DEKU_MODEL_DIR | GGUF 缓存目录 | ~/.cache/deku/models |
DEKU_RERANK_URL | MiniCPM-Reranker 侧车服务地址 | 未设置时使用词法排序 |
DEKU_AUDIENCE | 默认拒答措辞(human / agent) | human |
单元测试不需要模型和 GPU(mise run test);mise run capability-smoke 会在真实的 GGUF 服务上跑 refuse / web / url / hop / git / dir 等冒烟测试。
局限
- 按 MiniCPM5-1B 和英文调校(中文能应付一部分),日文输入会被拒答(
non_english)。 - 倾向于短回答;长文和开放式推理会被明确拒答,并说明原因。
- 不是通用编程 Agent;写代码和数学题会被拒答,并说明原因。
- 默认抽取路径走 chat completions(GGUF +
llama-server --jinja);在这套技术栈上实测过,预填充式的/v1/completions会退化。 - 实时网页 / URL 的质量取决于搜索摘要和网络;证据不够时它宁可不答,也不编。
- 能力结论必须在 GGUF 上重新测,不能照搬只在 MLX 上的分数。
非目标
- 通用编程 Agent / SWE-bench 运行器
- 由模型自己写多步“思维链”规划
- 把日文当作支持的输入语言
- 打包 MLX 转换工具链或大型研究评测矩阵
链接
- GitHub:penta2himajin/deku