过去很长一段时间,Agent 工程的主流叙事大多围绕 code agent、云端强模型、大上下文和复杂工具调用展开。
这些方向当然重要。强模型能做复杂推理,能写代码,能拆长任务,也能在多工具之间做规划。
但我最近更关心另一个方向:如果 Agent 不运行在云端大服务器上,而是运行在智能家居、工业设备、企业内网流程、涉密系统这类垂直场景里,Harness 应该怎么设计?
这些场景里,问题会变得不一样。
我们不一定需要一个开放式强推理模型,也不一定需要很长的自由对话。很多时候,真正需要的是一个本地、低延迟、可控、可回放的执行系统。
而且端侧设备往往有很硬的资源限制。很多设备可能只有 2GB 或 4GB RAM。这个时候,Agent Harness 的重点就不再只是“如何让模型完成更复杂的任务”,而是变成:
- 如何让 1B 小模型稳定输出结构化 JSON?
- 如何避免复读和死循环?
- 如何保证字段稳定?
- 如何控制上下文和输出长度?
- 如何在低内存下不崩溃?
- 如何防止错误指令直接进入设备执行层?
- 如何让失败可以回放和评测?
这就是我现在做 EdgeHome Harness 的原因。
项目是什么
EdgeHome Harness 是一个面向 1B 端侧小模型的 Rust Agent Harness 项目。
它的产品形态是智能家居本地控制中台,但核心目标不是替代米家 App、小米音箱或 Home Assistant,而是验证一件事:
在低资源边缘设备上,如何把一个容易输出不稳、容易复读、容易死循环的小模型,约束进一条真实可执行、可回放、可评测的本地控制链路。
我当前使用的模型是:
openbmb/minicpm5:latest
模型包大小:688MB
在 Ollama 路线下,MiniCPM5-1B q4 模型加载后的运行时预算大约在 1.0GB 到 1.25GB 之间。首次加载、首次请求、KV cache、推理 buffer、page cache 都会带来波动,峰值可能更高。
所以在 2GB RAM 设备上,预算并不宽裕:
MiniCPM5 / Ollama runtime: 1.0GB - 1.25GB
Rust Harness: 25MB - 64MB
SQLite / trace / executor: 32MB - 64MB
系统和基础服务: 350MB - 450MB
请求波动和缓存: 100MB - 150MB
必须保留 MemAvailable: 250MB - 350MB
也就是说,2GB 可以跑,但必须加很多限制。
无桌面系统 短上下文 短输出 单并发 低 temperature 限制重试 限制 trace buffer 长期记忆不常驻内存 低内存时关闭长期记忆注入 必要时降级到 rule-only
当然,实际部署和演示,我更推荐 4GB RAM。2GB 更适合作为 low_memory profile 的极限验证目标。
为什么用 Rust
这个项目选择 Rust,不是为了炫技,而是因为端侧 Harness 本身就是一个资源预算问题。
如果模型运行时已经占用 1.0GB 到 1.25GB,那么 Harness 自己就不能再成为第二个大内存服务。
当前设计里,Rust Harness 的目标 RSS 是 25MB 到 64MB,硬上限 96MB。它应该是一个小占比控制层,而不是一个重型 Web 后端。
Rust 在这里的价值主要是:
- 低运行时开销
- 可控内存
- 静态二进制
- 强类型边界
- 长期常驻服务
- 本地 SDK / runtime 集成
如果用 TS 或 Python,也不是不能做。但在 2GB RAM 这种极限预算下,Node.js 或 Python runtime 通常会多吃几十到几百 MB。对服务器来说这不算什么,但对 2GB 板子来说,这些内存正好是模型波动、KV cache、trace buffer 和 MemAvailable 的安全余量。
所以这个项目用 Rust 的核心理由不是语法,而是部署边界。
模型只生成候选 JSON
EdgeHome Harness 里,模型不会直接控制设备。
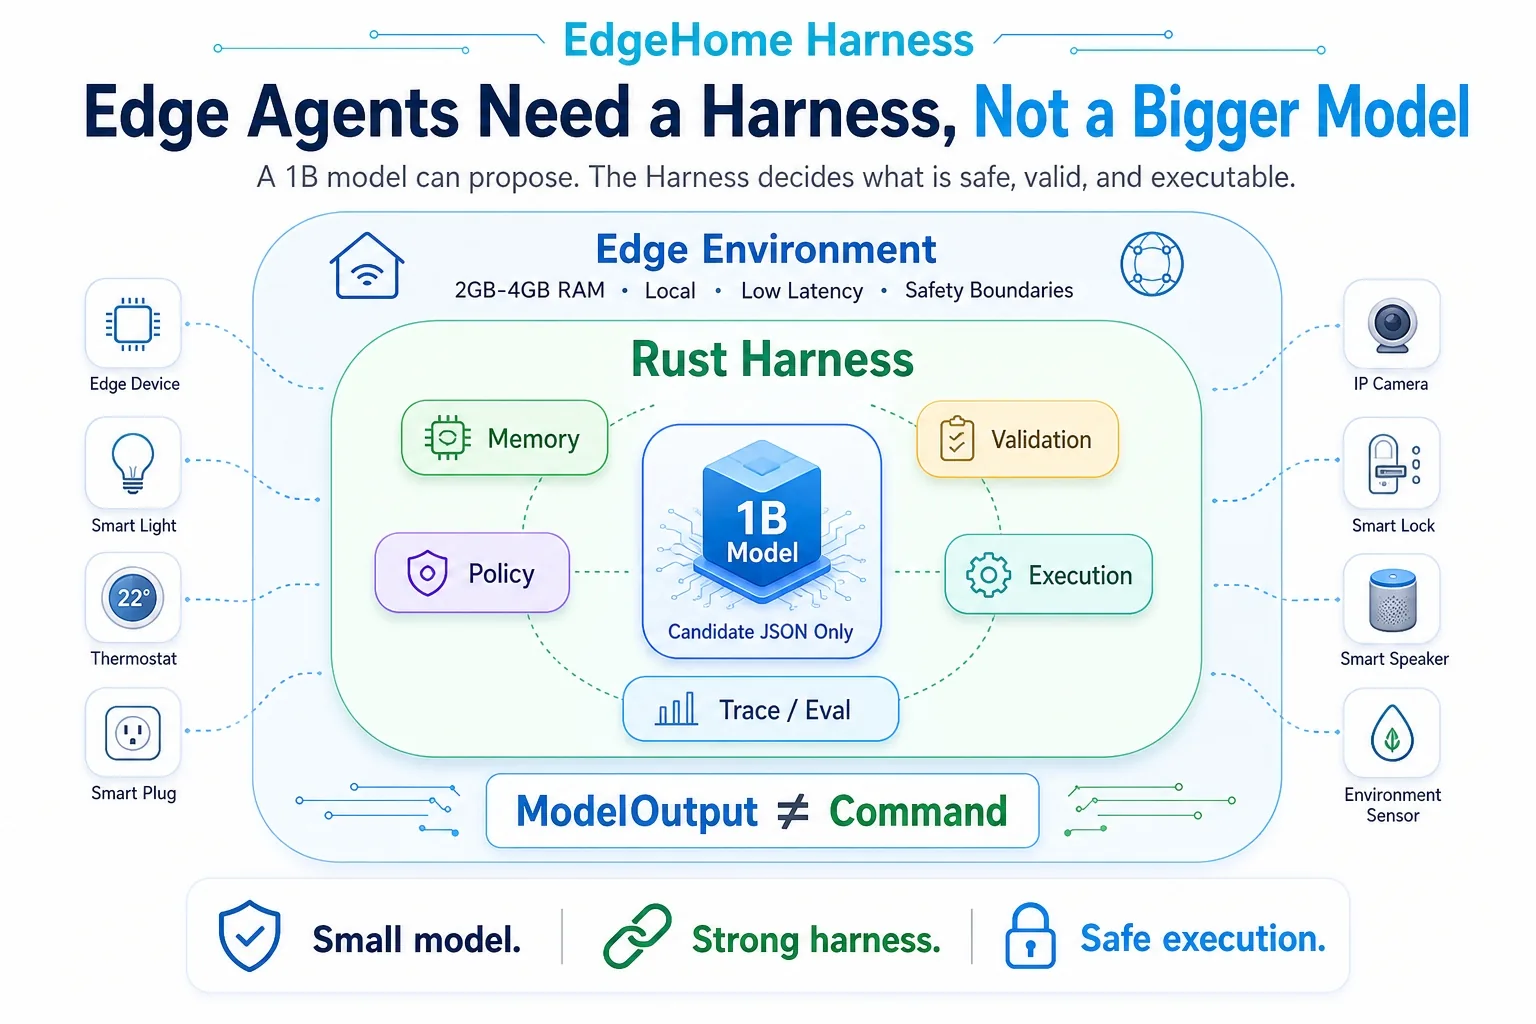
MiniCPM5-1B 只负责生成候选 JSON。真正能不能执行,要由 Rust Harness 判断。
Ollama structured outputs 可以让模型更容易输出合法 JSON,但这还不够。因为 JSON 合法,不代表业务合法。
模型可能输出:
{
  "intent": "turn_on",
  "room": "bedroom",
  "device": "air_conditioner"
}
但 Harness 还要继续判断:
- 这个 room 是否存在?
- 这个 device 是否存在?
- 这个 action 是否被支持?
- 参数是否越界?
- 是否需要确认?
- 是否允许自动执行?
- 是否触发低内存降级?
- 是否需要 fallback?
所以这个项目的核心原则是:
ModelOutput != Command
模型输出永远只是候选结构。真正能进入执行层的,只能是 Harness 校验后的 ExecutionPlan。
当前主链路
EdgeHome Harness 当前已经形成了一条完整主链路:
用户中文指令
-> Input Guard
-> Rule Parser
-> Runtime Memory
-> Context Compiler
-> MiniCPM5-1B / Ollama Candidate JSON
-> Output Governor
-> JSON Parser
-> Schema Validator
-> Semantic Normalizer
-> Device Registry
-> Policy Gate
-> Execution Planner
-> Executor Router
-> Trace Recorder
-> Eval / Replay
这条链路里,模型只是候选生成器。
真正的业务真相、设备边界、记忆、策略、执行和观测,都由 Rust 侧管理。
Runtime Memory:记忆不能交给模型自己管
端侧小模型不能靠长对话历史来维持记忆。
原因很简单:上下文越长,内存压力越大;信息越杂,小模型越容易混乱。
所以 EdgeHome Harness 的记忆系统不是把完整聊天历史塞给模型,而是由 Rust 管理结构化短时状态,例如:
last_target
last_action
last_value
device alias
room alias
user preference
这样系统才能处理一些真实智能家居场景:
再暗一点 把刚才那个关掉 恢复刚才的设置 切换成除湿模式
长期偏好则放在 SQLite 里,不常驻模型上下文。每次请求前,Harness 只把和当前输入相关的极短摘要注入 prompt。
这不是为了让模型“更会聊天”,而是为了让小模型在低内存下还能处理必要的指代。
Output Governor:专门治理小模型失控
1B 小模型和云端强模型不一样。
它在短指令、分类、槽位抽取上可能很有价值,但一旦放开输出,就容易出现:
- 复读
- 跑题
- 解释过多
- JSON 外包裹自然语言
- 字段漂移
- 输出过长
- 死循环
所以 Harness 必须有 Output Governor。
它负责限制:
- 最大输出长度
- 重试次数
- 重复片段
- 超时时间
- JSON 清洗
- fallback 路径
这是小模型 Harness 和传统大模型 Harness 的一个重要差异。
很多大模型 Harness 默认模型能力足够强,重点放在规划和工具调用。小模型 Harness 必须默认模型会犯错,所以要提前设计失败路径。
Device Registry 和 Policy Gate:安全边界不能交给模型
模型不应该知道真实设备 token,也不应该直接决定动作是否执行。
EdgeHome Harness 通过 Device Registry 和 Policy Gate 做确定性判断。
Device Registry 负责:
- 房间是否存在
- 设备是否存在
- 别名如何映射
- 设备支持哪些 capability
- 参数范围是否合法
Policy Gate 负责:
- 哪些动作允许自动执行
- 哪些动作只能 dry-run
- 哪些动作需要确认
- 哪些动作直接拒绝
- 低内存或离线状态下是否降级
这样小模型即使输出了错误 JSON,也不会直接变成真实设备动作。
Trace / Replay / Eval:Harness 不能靠感觉调
普通 prompt demo 只关心这一次模型有没有答对。
Harness 工程要关心的是:
这次为什么对
为什么错
错在哪一层
能不能复现
下个版本有没有退化
低内存情况下能不能降级
所以 EdgeHome Harness 会记录 Trace。
每一次请求都应该能看到:
输入是什么
模型输出是什么
Harness 如何清洗
schema 是否通过
设备如何解析
策略为什么允许或拒绝
最终执行计划是什么
失败原因是什么
这些 Trace 可以用于 Replay,也可以进入 Eval。
Eval 的目标不是只评测模型聪不聪明,而是评测 Harness 有没有稳定治理小模型:
schema_valid_rate
intent_accuracy
slot_accuracy
dead_loop_rate
retry_rate
fallback_rate
trace_coverage
low_memory_degrade_count
这也是这个项目和普通 JSON demo 的区别。
Evidence 的位置
一开始我考虑过把证据门控放进在线执行链路里。但后来发现,智能家居场景和企业审批场景不一样。
报销、工单、合同审核这种场景可以慢,但不能错。它们适合强证据、强门控。
智能家居控制不同。用户说“打开空调”,系统应该尽快响应。普通开关灯动作不应该像审批流一样慢。
所以现在的设计是:
Memory for runtime.
Evidence for debugging.
Eval for progress.
Policy for deterministic hard constraints.
LLM for candidate JSON only.
Evidence 不再 gate 每一次普通用户动作,而是用于失败分析、trace replay、eval 解释和 release gate。
这个取舍很重要。它让系统既有工程可追溯性,又不牺牲在线响应。
当前边界
这个项目现在不是完整商业网关。
它也不宣称替代米家 App、小米音箱或 Home Assistant。
当前默认执行器是 MockExecutor,Home Assistant 是 demo backend。未来可以继续扩展 MQTT、Matter、MIoT、miIO 或其他本地设备协议,但 Harness 主体不和某一个设备生态绑定死。
更准确地说,当前项目是:
一个可复现的 Rust 小模型 Harness 工程原型
一个智能家居本地控制场景下的端侧 Agent 实验
一个验证 1B 小模型如何进入可控执行链路的系统
一个面向低资源设备的 Memory / Policy / Trace / Eval 工程样例
最后
我做这个项目,不是为了证明 1B 小模型可以替代大模型。
我想证明的是另一件事:
在垂直场景里,小模型不需要无所不能。
只要 Harness 设计正确,小模型可以只负责候选生成;
业务真相、记忆、策略、执行和观测交给确定性系统。
这可能是端侧 Agent 更现实的一条路线。
不是把云端大模型硬塞进小设备里,而是重新设计模型职责和工程边界,让 1B 小模型在严格约束下发挥价值。
这就是我现在做的小模型 Harness。