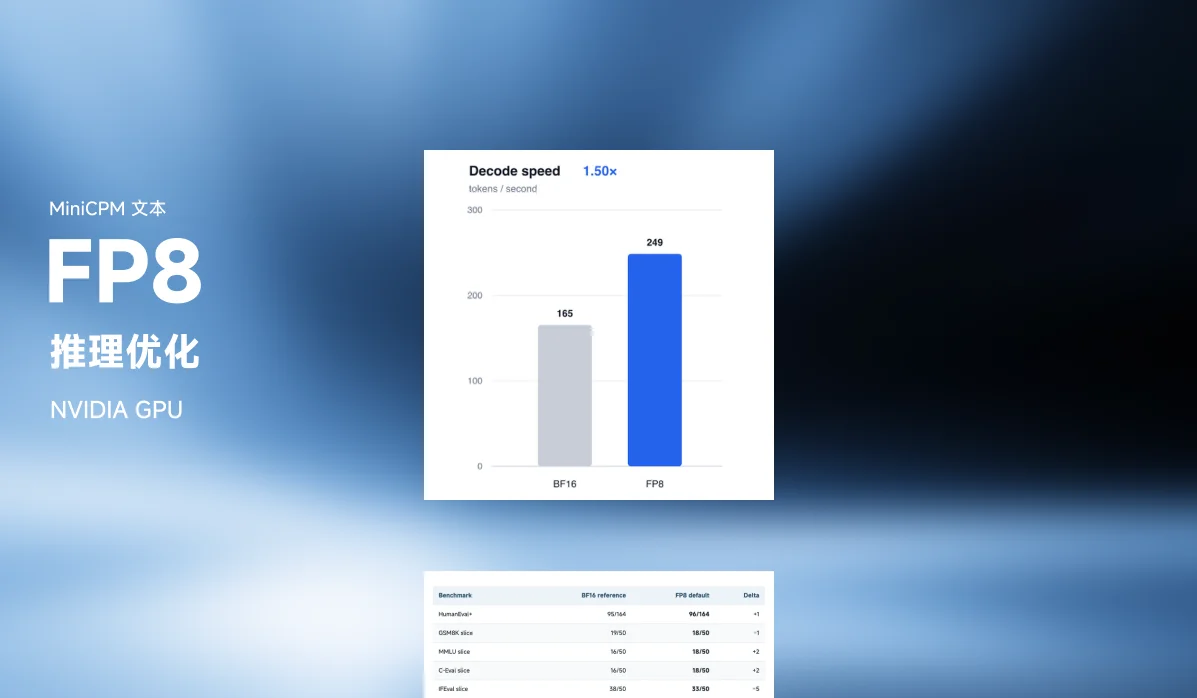
这个项目给 MiniCPM5-1B 在 NVIDIA Ampere 及更新架构的 GPU 上准备了一套优化过的默认配置,面向单个活跃请求、显存够用的部署场景。
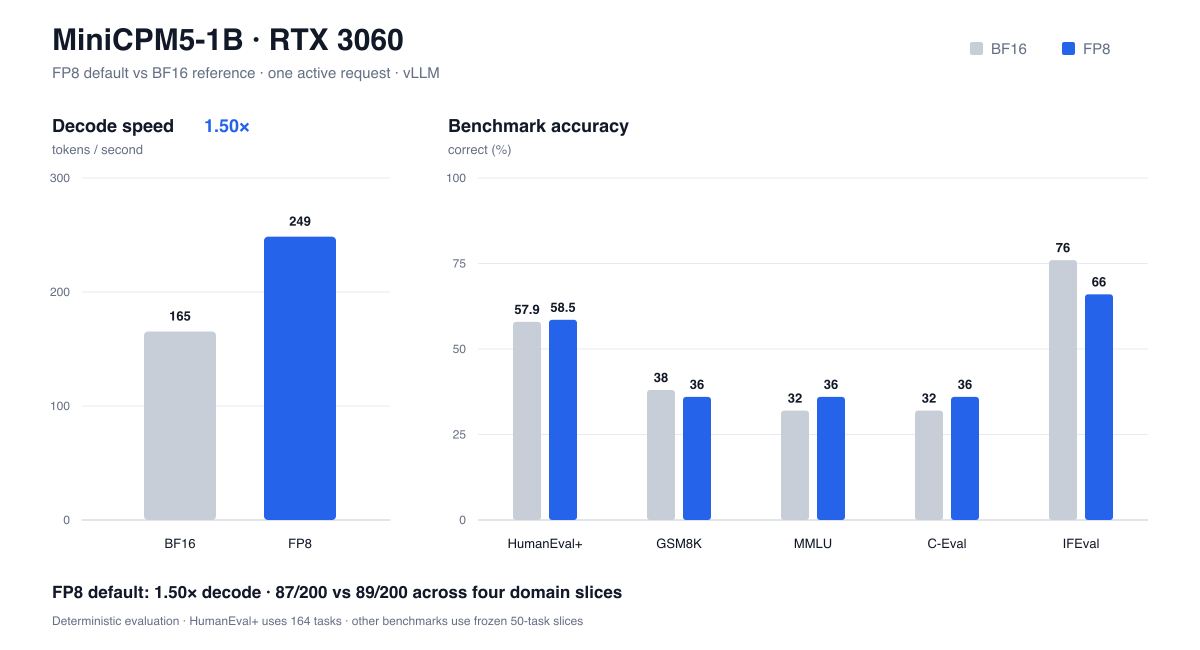
RTX 3060 实测:解码速度 248.52 tok/s,是同条件 BF16 vLLM 基线的 1.503 倍。
基准测试
速度
| 指标 | BF16 基线 | FP8 默认配置 | 变化 |
|---|---|---|---|
| 解码吞吐(中位数) | 165.39 tok/s | 248.52 tok/s | +50.3% |
| 端到端吞吐(中位数) | 152.42 tok/s | 221.42 tok/s | +45.3% |
| 首 token 延迟 TTFT(中位数) | 38.60 ms | 35.11 ms | −9.0% |
速度测试用了 6 个提示词,每个提示词 1 次预热、5 次计时,batch size 和并发数都是 1。
质量
| 基准 | BF16 基线 | FP8 默认配置 | 差值 |
|---|---|---|---|
| HumanEval+ | 95/164 | 96/164 | +1 |
| GSM8K 切片 | 19/50 | 18/50 | −1 |
| MMLU 切片 | 16/50 | 18/50 | +2 |
| C-Eval 切片 | 16/50 | 18/50 | +2 |
| IFEval 切片 | 38/50 | 33/50 | −5 |
| 四个切片合计 | 89/200 | 87/200 | −2 |
质量测试是确定性运行的。FP8 会改变输出:和 BF16 相比,HumanEval+ 上有 8 题由对变错、9 题由错变对;四个切片合计 12 题变差、10 题变好。逐题对比放在仓库的 results/ 目录里。
优化内容
默认配置由下面几项组合而成:
- vLLM 编译执行与 CUDA graph 回放;
- 在线逐块(per-block)FP8 量化,配合 Marlin 线性层 kernel;
- Triton attention,在 RTX 3060 上实测解码最快的后端;
- batch 为 1、最多一个活跃序列的调度器;
- 针对单请求场景关闭前缀缓存。
测出来的加速来自组合配置整体,仓库没有声称每一项单独贡献了多少百分比。
快速开始
实测环境:Linux、RTX 3060 12 GB、vLLM 0.27.1、PyTorch 2.13.0+cu130,模型版本 4e9de7a0778dc1c362e983e6858f0e77542cbdca。
在 GPU 机器上直接下载官方权重:
hf download openbmb/MiniCPM5-1B \
  --revision 4e9de7a0778dc1c362e983e6858f0e77542cbdca \
  --local-dir /workspace/models/MiniCPM5-1B
安装并启动。FP8 会被自动选中,不用额外加参数:
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements-gpu.txt

export MINICPM5_MODEL_PATH=/workspace/models/MiniCPM5-1B
./serve --host 127.0.0.1 --port 8000
加上 --dry-run,只打印最终的 vLLM 启动命令,不真正启动服务。启动脚本会检查所选 NVIDIA GPU 的计算能力是否不低于 8.0,并且从不自动下载权重。RTX 3060 被标为“已实测”,其他符合要求的架构标为“兼容但未测试”。能不能启动,还要看可用显存和装的是哪个版本的 vLLM。
GPU 兼容性
| 硬件 | 默认配置 |
|---|---|
| NVIDIA Ampere 及更新(SM80+) | 架构兼容,需自行测速 |
| RTX 3060 12 GB | 支持且已在此实测 |
| NVIDIA Turing(SM75) | 本 BF16 配置不支持 |
| AMD、Intel、Apple GPU 或 CPU | 本项目不支持 |
vLLM 在更老的 NVIDIA 硬件上可以用 Marlin FP8 仅权重量化 kernel,但本方案同时依赖 BF16,所以实际最低要求是 SM80+。Turing 得另外测 FP16 配置。
发布内容
- 默认的 NVIDIA SM80+ FP8 服务配置和一键启动脚本;
- 冻结的基准规格与文档哈希清单;
- 完整的逐题配对对比记录;
- 可复现的图表生成脚本和可在 CPU 上运行的测试集。
OpenBMB 的官方权重没有改动,也不重新分发。仓库里的 BF16 配置只用来复现基准,不是第二个面向终端用户的发布配置。完整测试协议见仓库的 docs/BENCHMARKS.md。
适用范围与说明
- 这套配置面向 NVIDIA SM80+ GPU 发布。实测加速只直接适用于固定的模型版本、软件版本、单请求负载和测试用的 RTX 3060;换一块 GPU 可能选中不同的 vLLM kernel,需要单独测速。
- 四个 50 题的领域切片只是发布前的筛查,不是对官方榜单的完整复现。
- 这是独立研究,不是 OpenBMB 官方发布。
链接
- GitHub:vukrosic/minicpm5-nvidia-fp8