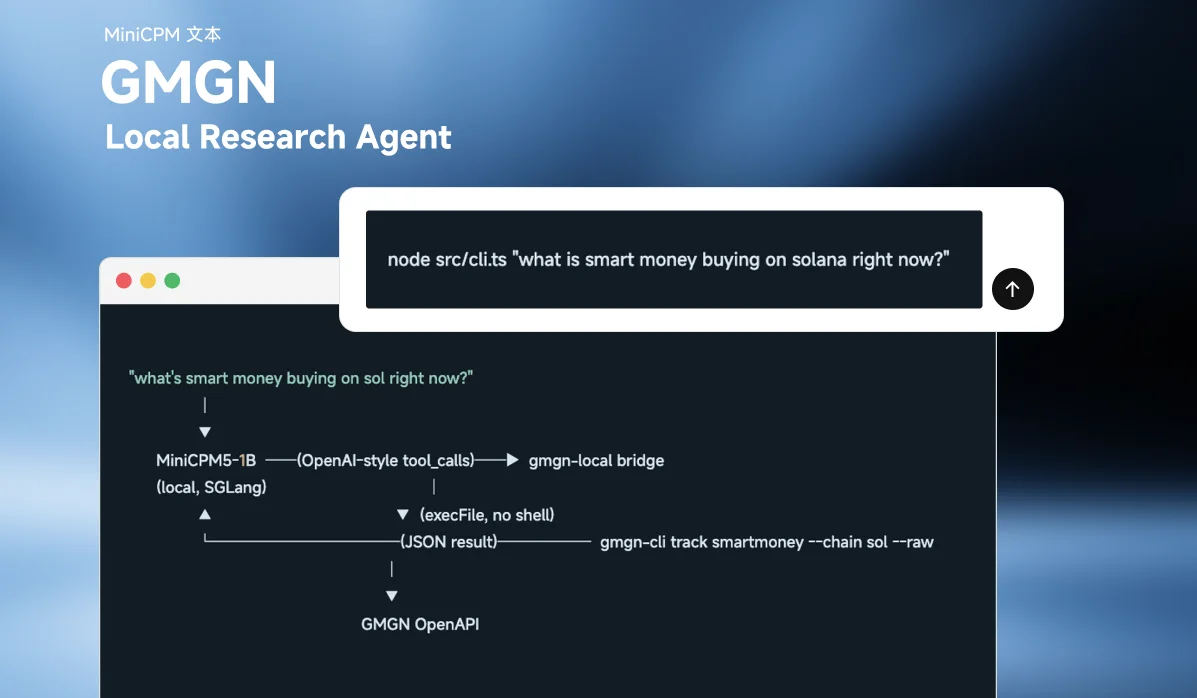
gmgn-minicpm 把 GMGN 的加密货币研究搬到你自己的机器上:一个 1B 模型充当只读 Agent,不调用云端 LLM,没有 API 账单,断网也能跑。多数人接 GMGN 会选 Claude 或 GPT,这个项目换成了 MiniCPM5-1B,约 1B 参数,原生支持工具调用,跑在端侧。项目本身是一层很薄的 TypeScript 桥接,零运行时依赖,只做三件事:把模型吐出的 tool_calls 转成安全的 gmgn-cli 命令,执行,再把 JSON 结果交回模型。
Plain Text
  "what's smart money buying on sol right now?"
                 │
                 ▼
        MiniCPM5-1B  ──(OpenAI-style tool_calls)──►  gmgn-local bridge
        (local, SGLang)                                   │
                 ▲                                        ▼  (execFile, no shell)
                 └────────────(JSON result)──────  gmgn-cli track smartmoney --chain sol --raw
                                                          │
                                                          ▼
                                                     GMGN OpenAPI
为什么做这个
- 没有 API 账单:模型跑在自己的硬件上,只需付 GMGN 的数据配额。
- 低延迟,可离线:不用等云端往返,适合长时间挂着的监控程序。
- 小巧,好审计:零运行时依赖,原生 Node TypeScript,每个工具都是白名单里的一条子命令。
安全设计
这一版是 v1,只读。接入的全是市场、代币、钱包相关的研究工具。会动资金的命令(swap、multi-swap、order、cooking)没有注册,桥接层也会硬拦。作者的理由很简单:不能让一个在自动循环里跑的 1B 模型持有转账能力。将来即使支持 swap,也要先过人工确认。
本应用不构成投资建议:它只读数据,决策还是你自己的事。
工作原理
src/tools.ts:只读工具注册表。每一项是一个 OpenAI 风格的函数 schema,以及它对应的gmgn-cli子命令;snake_case 参数会转成--kebab-case。src/bridge.ts:校验工具调用,检查必填参数,丢掉模型编出来的参数,拦下涉及资金的命令,最后拼出 argv 数组。src/gmgnCli.ts:用execFile跑gmgn-cli,传 argv 数组,不经过 shell,参数没法注入;加上--raw,再解析 JSON。src/agent.ts:模型循环。发消息和工具,执行返回的tool_calls,回传结果,直到模型给出最终答案(迭代上限由GMGN_LOCAL_MAX_ITERS控制)。
工具(v1)
token:info · security · pool · holders · tradersmarket:kline · trending · trenches · signal · hot-searchesportfolio:info · holdings · activity · stats · token-balance · created-tokenstrack:follow-tokens · follow-wallet · kol · smartmoney
让 1B 模型稳定运行的经验
1B 模型不是前沿大模型,仓库里不少设计都是围绕这个前提做的:
- 限制生成长度(
GMGN_LOCAL_MAX_TOKENS,默认 1024)。小模型出错时容易陷进循环,不停输出工具调用 JSON,直到撑满上下文,llama.cpp 直接返回 500。限制 token 数能避开这个坑。 - 截断工具结果(
GMGN_LOCAL_MAX_TOOL_RESULT_CHARS,默认 4000)。一次trending就有约 7 KB,几次不限长的结果就能挤爆 8k 上下文。建议用-c 32768启动服务,留出余量。 - 在桥接层校验枚举值。模型偶尔会编出
"5"这样的chain值,bridge.ts会以must be one of: sol, bsc, base, eth拒掉,模型有机会自己改,错误参数不会被送进命令行。
这些粗糙的地方,正是后面的 LoRA 微调想解决的。
快速开始
环境要求:
- Node.js ≥ 24。原生类型剥离可以直接跑 TypeScript 源码,不用构建。
- 装好并配置
gmgn-cli:npm install -g gmgn-cli,然后运行gmgn-cli config。 - 一个本地服务,为 MiniCPM5-1B 提供 OpenAI 兼容的
/v1/chat/completions,并且支持工具调用:
已验证环境:Apple M4 Pro / 48 GB,MiniCPM5-1B F16 GGUF 跑在
llama-server上,Metal 加速约 90–100 tok/s。从模型到 gmgn-cli 再到回答的整条链路,已经在真实 GMGN 数据上跑通。
Bash
git clone https://github.com/dvictor357/gmgn-minicpm
cd gmgn-minicpm
cp .env.example .env

# 1. 启动模型服务(首次运行会自动从 HF 下载 F16 GGUF)
bash scripts/serve-llamacpp.sh          # NVIDIA 用户:scripts/serve-sglang.sh

# 2. 提问
node src/cli.ts "what is smart money buying on solana right now?"

# 或进入交互式 REPL
node src/cli.ts
加上 --verbose 可以打印模型发起的每一次工具调用;node src/cli.ts --list-tools 能在不启动模型的情况下查看可用工具。
路线图
- LoRA 数据集生成器:
npm run dataset基于真实 GMGN 数据构建(query → tool_call → gold answer)数据集,金标准答案以确定性方式生成。 - LoRA 微调并融合为 GGUF(在 Apple Silicon 上使用 MLX-LM),提升复合路由、参数选择和简洁判断的可靠性。
- 受控的 swap:在强制人工确认或规则引擎之后加入动用资金的工具,绝不由模型直接决定。
- 7×24 监控模式:盯住 trending / signals 并发提醒。
链接
- GitHub:dvictor357/gmgn-minicpm