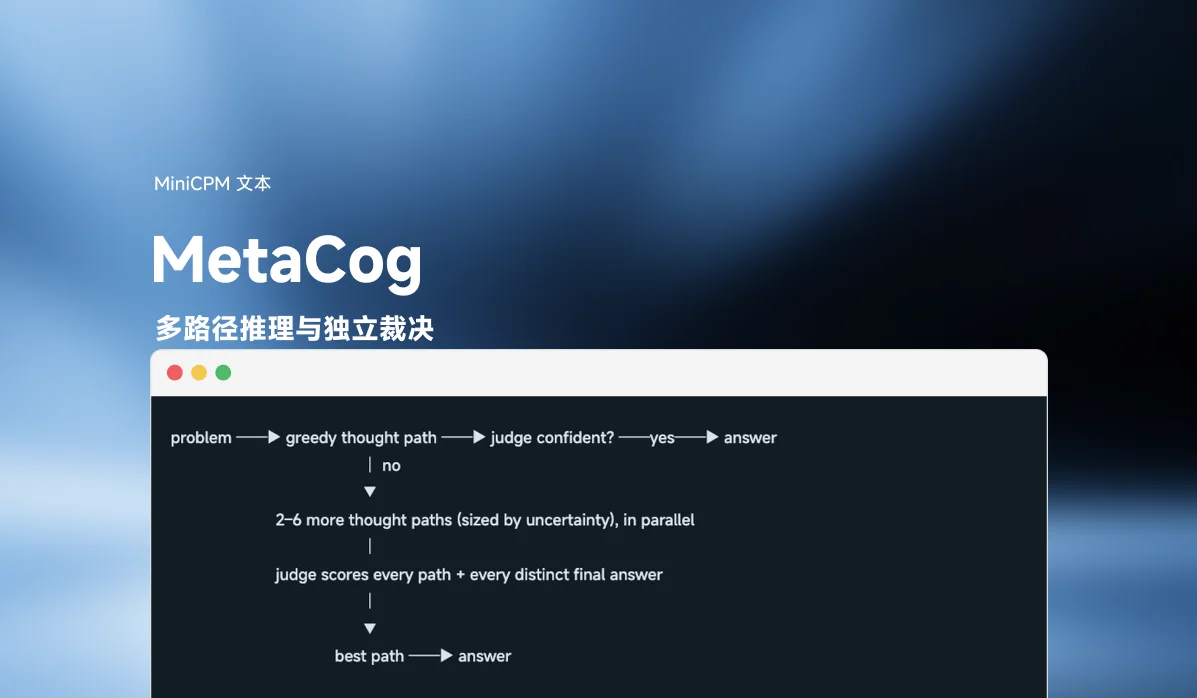
MetaCog 给任意语言模型(本地或 API)套一层推理时的元认知(metacognition)循环:thinker 先写一个答案,再由一个独立的 judge 打分。judge 有把握就直接返回;没把握就让模型并行写更多思考路径,judge 给每条路径、每个不同的最终答案分别打分,最后返回得分最高的那个。整个过程不用训练,也不动任何权重。
项目的快速上手示例把 openbmb/MiniCPM5-2B 当作 thinker,也支持任意 OpenAI 兼容服务或进程内的 Hugging Face checkpoint。
问题 ──▶ 贪心思考路径 ──▶ 裁判有把握? ──是──▶ 答案
                                │ 否
                                ▼
            按不确定度再并行生成 2–6 条思考路径
                                │
            裁判为每条路径 + 每个不同的最终答案打分
                                │
                                ▼
                        最佳路径 ──▶ 答案
实测结果
在三个托管 thinker 上跑了 180 组 GPQA Diamond + AIME 配对样本:thinker 单独作答准确率 76.7%,MetaCog 达到 86.7%。相比上一版 MetaCog 默认配置,修正 11 题、丢掉 2 题,p = 0.02,耗时 0.89×,thinker token 1.39×。四个基准共 856 组样本汇总,早期配置把准确率从 75.0% 提到 79.4%。
想找现成的 Agent,可以看作者的另一个项目 Heuristic:一个内置 MetaCog 的异步 coding agent 框架,fork 自 Unreal Agent。
工作原理
Config() 的默认值就是实测过的 v0.3 流水线(mode="adaptive"):
- 贪心路径:thinker 先答一次。
- 停止检查:judge 打分,分数 ≥
stop_confidence(0.95)就直接返回。实测中,Jev 分数 ≥ 0.95 的答案 229 次里有 226 次正确。 - 分支:否则用
u = 1 − score决定再采样几条思考路径,数量为round(n_min + u·(n_max − n_min))(默认 2..6),全部并行生成。 - 裁判:每条完整路径独立打分(问“这是否正确?”,每条路径一次调用);每个不同的最终答案也会单独打分(只给
Final answer: X,不带推理),按answer_prior(0.5)的权重计入。 - 选择:综合分最高的胜出,只有已经跑完的路径才能赢。
运行模式
| 模式 | 行为 | 适用场景 |
|---|---|---|
adaptive | 同上;可选草稿层和多轮树搜索 | 默认 |
best_of_n | 采样 n_paths 个完整答案,由裁判挑一个 | 最便宜,任何对话接口都能用 |
stepwise | 每次采样 n_paths 段 step_tokens 长的续写,裁判挑完再继续扩展 | 引导更紧;需要前缀续写能力 |
race | 所有路径同时流式生成,裁判给部分文本打分,第一个达到 race_confidence(0.8)的流胜出,其余中途取消 | 延迟最低;需要流式 thinker 和服务端并行 |
race 是低延迟变体:每条路径并发流式输出,裁判大约每隔 race_score_chars 个新字符给部分文本重新打一次分。第一个越过阈值的流获胜,其余立即取消。所以总耗时差不多等于一次生成,而不是两轮串行,失败的路径也能尽早停止消耗 token。两个流得到相同答案时,比赛同样会提前结束。这要求 thinker 服务能并行处理 N 个流(例如 llama-server --parallel N)。
还有几个可选开关,都实测过,但没有一个明显强过默认配置:triage 先让裁判评估题目难度,难的直接跳过贪心阶段;sketch_tokens 先生成便宜提纲再扩展;max_rounds 控制多轮分支;diversity_hints 给每条路径不同的解题思路;escalate_thinker 在仍不确定时换更强的模型写一条;strategy="choice" 用一次比较式打分。
裁判
原则只有一条:裁判不能是 thinker 本身。实测里自我评分比不用裁判还差。
| 裁判 | 类 | 依赖 |
|---|---|---|
| Jev(TypeSafe 托管),默认,实测最好 | SystemOneJudge.jev() | TYPESAFE_API_KEY |
| Reflex(MIT,4B,本地) | SystemOneJudge.reflex(...) | 本地部署 Qwen3.5-4B,约 8 GB 显存 |
| 本地 logprob 裁判(任意开源模型,不用 Key) | LogitJudge | 一个 .gguf 文件,或返回 top_logprobs 的服务 |
| 自定义 | 任何实现了 score(problem, candidates) -> Verdict 的对象 | — |
LogitJudge 从冻结开源模型的下一个 token logits 里直接读 P(yes),每条路径一次前向计算,不生成任何文本。在 127 个保存的候选池上,它挑对 68 个,Jev 挑对 72 个(p = 0.50,统计上算持平,略弱一点)。CPU 上很慢,每个池约 2 分钟,建议上 GPU。
快速上手
from metacog import MetaCog, Config, OpenAICompatThinker, SystemOneJudge

thinker = OpenAICompatThinker("http://localhost:8000", model="openbmb/MiniCPM5-2B")
judge = SystemOneJudge.jev()  # 托管裁判;读取 $TYPESAFE_API_KEY

mc = MetaCog(thinker, judge, Config())  # 默认即实测的 v0.3 流水线
result = mc.run("How many positive integers below 1000 have digits summing to 9?")

print(result.answer)
thinker 可以是任意 OpenAI 兼容服务(vLLM、llama.cpp、Ollama、LM Studio、OpenAI、OpenRouter 等),也可以用 TransformersThinker("openbmb/MiniCPM5-2B") 在进程内加载 Hugging Face checkpoint,或者自己实现一个 generate(...) 方法。OpenAICompatThinker 对不完善的服务端比较宽容:会忽略 n、错误的 finish_reason、HTTP 200 错误体和断开的连接。
另外带了一个 metacog-eval 评测工具(比如 HumanEval)。它会运行模型生成的代码,建议放在容器里跑,报告结果时把覆盖率上限和准确率一起给出。
链接
- GitHub:ItIsCuthNotCup/MetaCog
- 相关项目:Heuristic