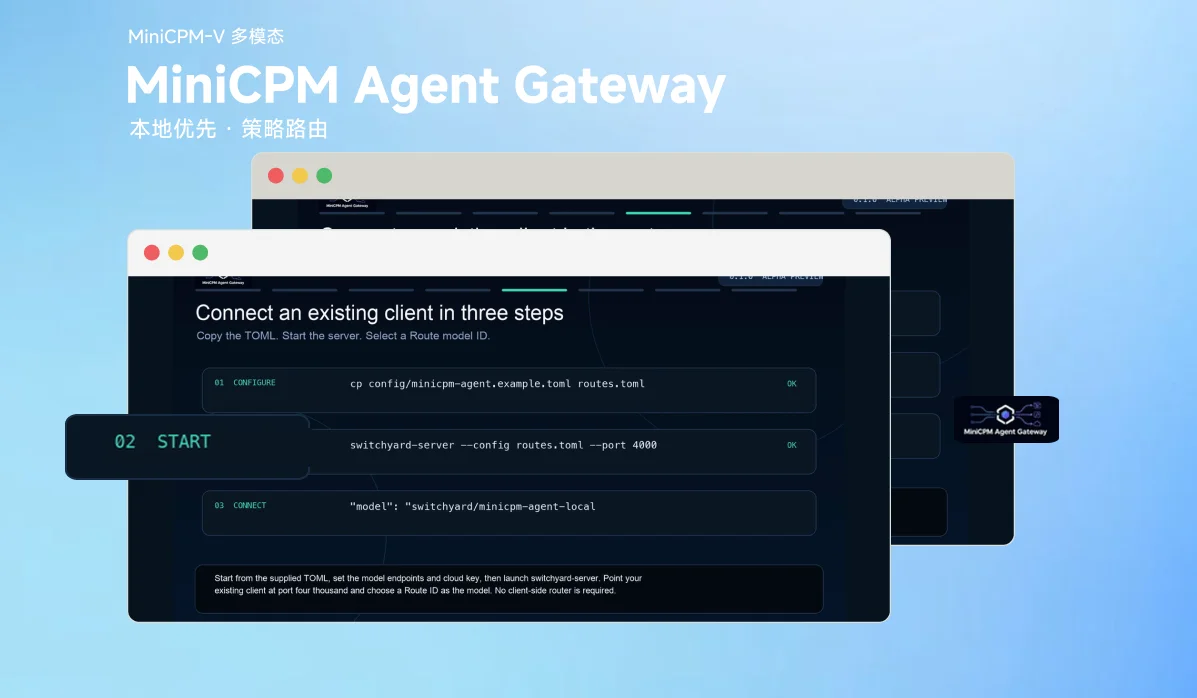
MiniCPM Agent Gateway 是一个 Agent 路由系统,建在 NVIDIA-NeMo/Switchyard 之上,原则只有两条:质量优先,本地优先。高频、边界清楚的工作交给本地 MiniCPM 模型;困难任务,或者本地失败但经过校验的情况,只有当前 Route 的数据策略允许上云时,才会转给外部强模型。
OpenAI Chat、OpenAI Responses 和 Anthropic Messages 三类客户端,都能继续用各自的原生协议接入。网关引擎继承自 Switchyard,负责协议转换、路由、按健康状态执行、日志和指标。MiniCPM 路由层在这上面又加了四样东西:确定性的能力门控、不越界的云端接管、带校验的控制输出,以及可选的本地 Runtime Supervisor。
核心能力
- MiniCPM 优先:MiniCPM5-1B 管分类、简单文本与工具调用、上下文压缩;MiniCPM-V 4.6 管图像、OCR、文档、有序视频帧和视觉工具。
- 云端接管受策略控制:每条 Agent Route 只能声明
local_only、cloud_allowed、cloud_redacted三者之一。可靠性回退不会顺手放宽这个权限。 - 不牺牲质量:困难或拿不准的任务默认交给配置好的外部强模型。本地控制输出格式不对,会在被使用之前就拒掉。
- 流式输出有边界:普通文本照常流式返回;分类、工具调用、结构化输出和摘要先缓冲再校验。两个模型的输出不会拼进同一个流。
- 可选的本地监管:
switchyard-runtime能校验已批准的模型文件,让 MiniCPM5 常驻,按需加载 MiniCPM-V,空闲超时后再把视觉模型卸掉。 - 协议和遥测都能接:客户端可以用 OpenAI 或 Anthropic API,网关会导出请求、错误、延迟、token 和路由等指标。
成熟度
MiniCPM Agent Gateway 0.1.0 目前是 alpha 质量的 Developer Preview。MiniCPM 路由路径已经过了离线门控、六平台构建矩阵,以及在 Apple Silicon 上用 LM Studio 的实机评测。纯 CPU 和 NVIDIA 运行时路径已经写完,也有确定性测试覆盖,但还得到对应硬件上跑一遍同等验证,才算“完全验证的部署”。眼下不建议用在无人值守的生产环境。
实测结果
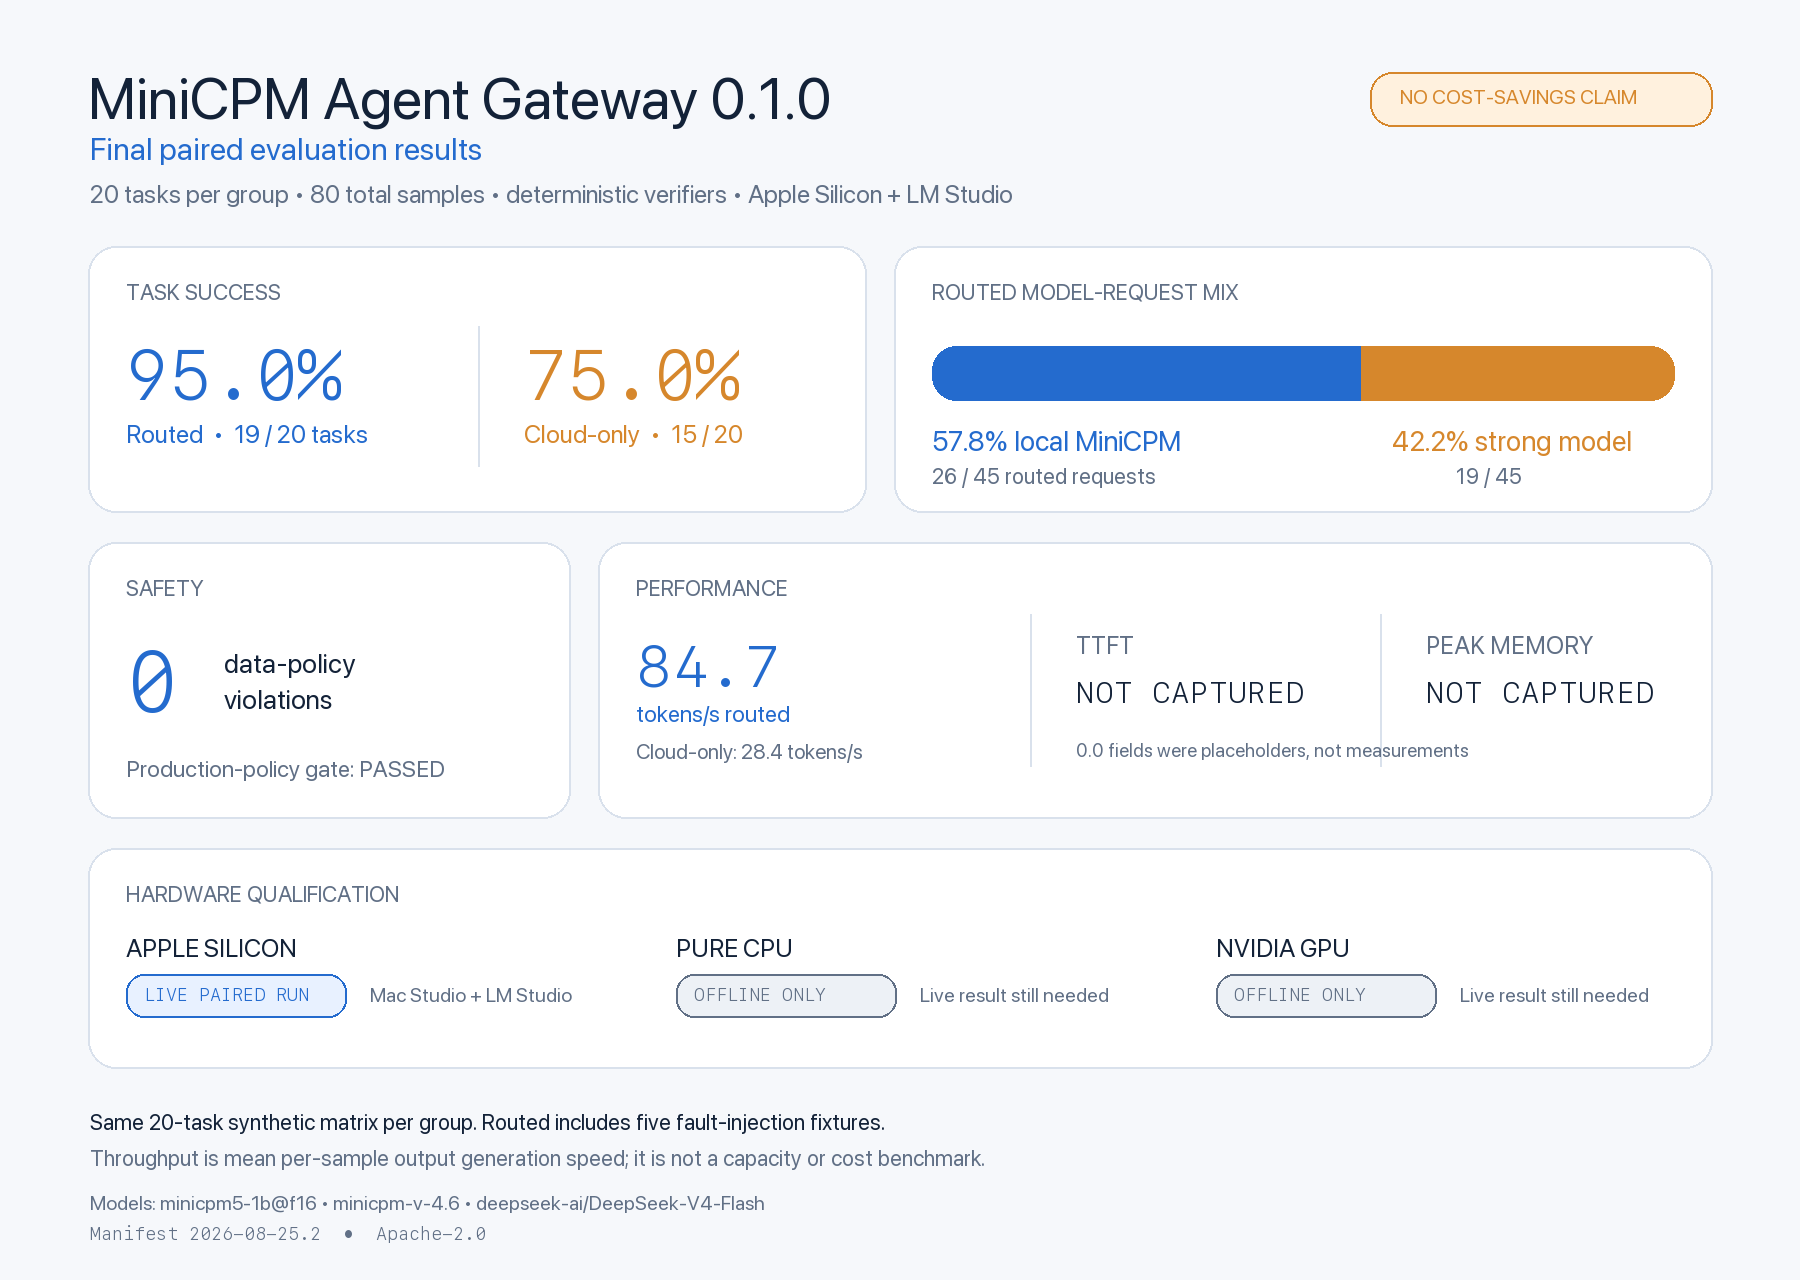
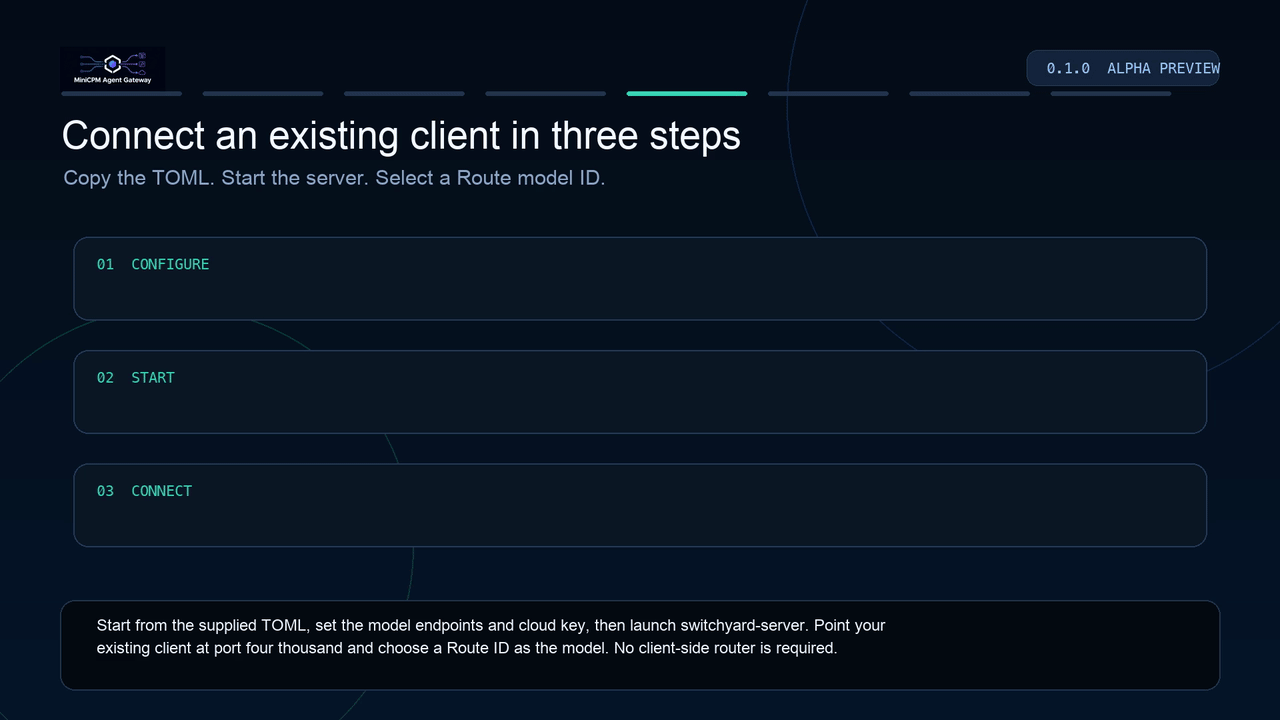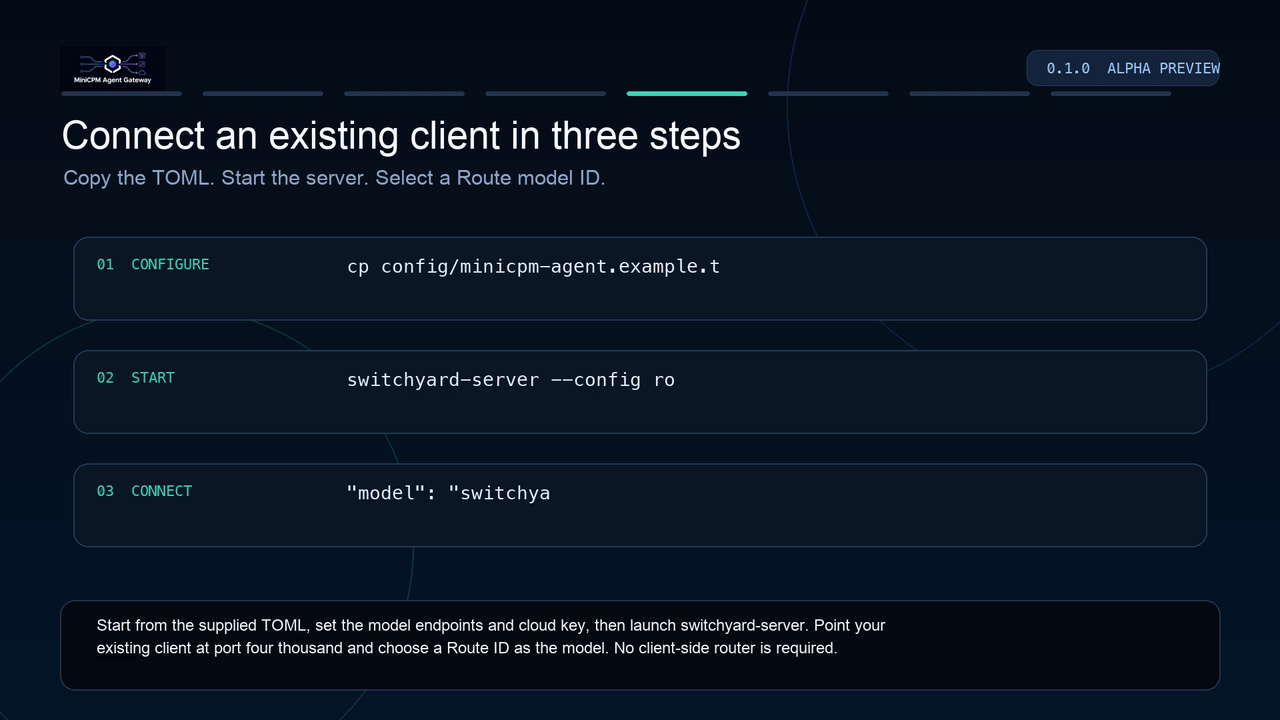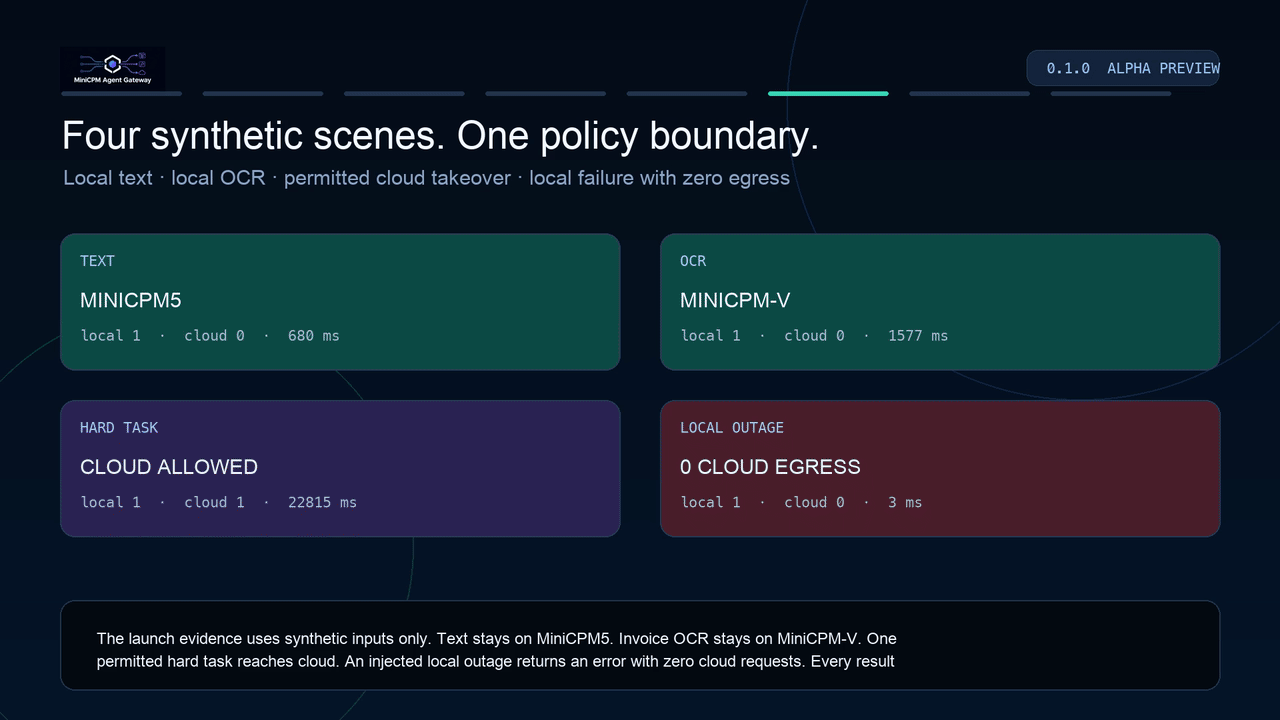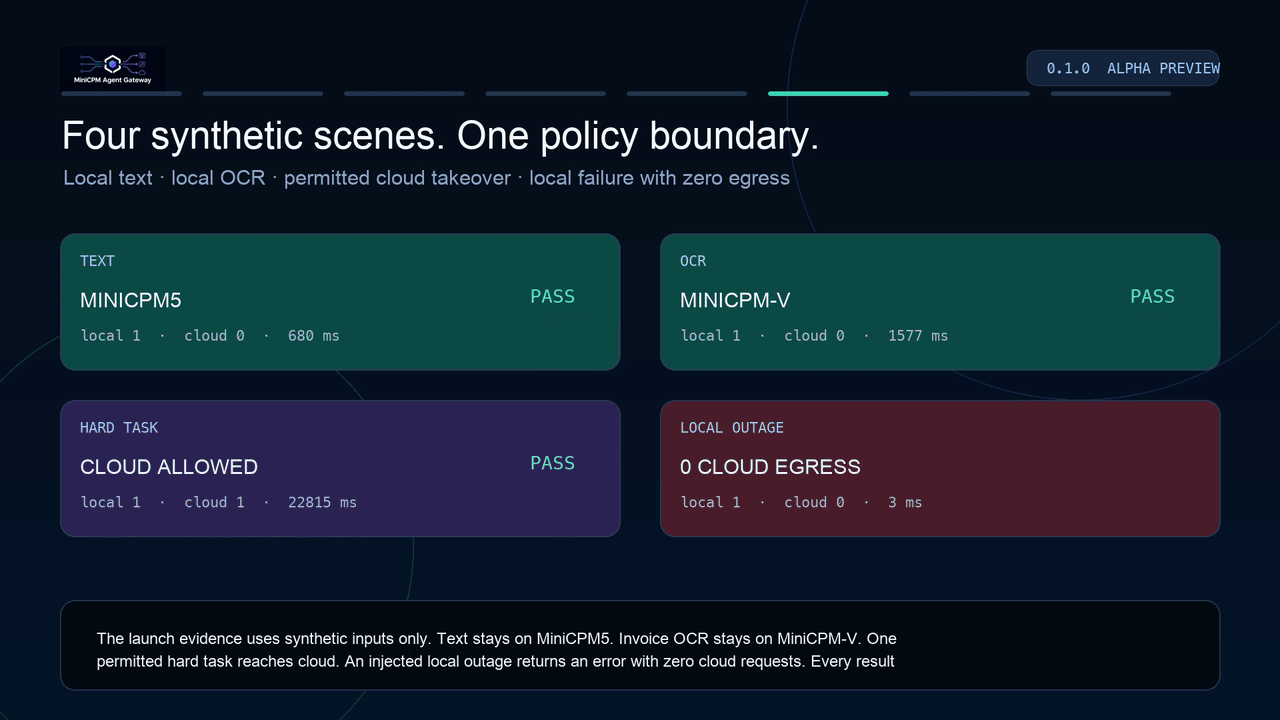
最后一轮 80 样本配对评测里,路由后的任务成功率是 95%,纯云端基线是 75%;57.8% 的路由后模型请求由 MiniCPM 处理,数据策略违规为零。这一版没有采集 TTFT 和峰值内存,所以不对成本节省做任何声明。
架构
请求路由与云端接管
网关先做确定性的策略和能力判断,再让模型去分类任务复杂度。本地控制输出必须过校验,任何通往云端的路径都要跨过 Route 的数据策略边界。一个请求的处理流程是这样:
- 客户端(OpenAI Chat / Responses / Anthropic Messages)的请求进到
switchyard-server,在这里完成协议转换和 Route 选择。 - 过 Route 数据策略门(
local_only/cloud_allowed/cloud_redacted),再提取请求需求:模态、工具、schema、上下文。 - 确定性能力门(profile、健康状态、容量)做分流。多模态请求直接交给 MiniCPM-V 4.6 Q8;文本请求先由 MiniCPM5-1B 分类,简单任务交给 MiniCPM5-1B F16,困难或拿不准的进入云端接管判断。
- 本地输出分两种:普通文本直接流式返回;受控输出(分类、工具、schema、摘要)先缓冲校验,通过了才返回。如果还没产生任何可见输出就校验失败,转云端接管判断。
- 云端接管判断按策略走:
local_only返回符合策略的本地错误;cloud_allowed交给外部强模型;cloud_redacted先做确定性脱敏和重新校验,通过才上云,否则直接失败返回错误(fail closed)。 - 如果失败发生在可见文本已经流出去之后,网关会给这个任务签发一张云端租约(task-scoped cloud lease),只对下一轮有效。下一个请求再走一遍云端接管判断。
可见文本已经流出去之后再失败,这个响应会以一个流错误结束。任务租约只影响下一个请求:它不会重放有副作用的工具调用,也不会把云端文本接到不完整的本地回答后面。如果原始上下文也超出云端 profile 的限制,强模型会先做一次带校验的云端压缩,再作答。
本地部署与运行时监管
每个本地目标有两种接法:自己管的 OpenAI 兼容运行时(比如 LM Studio),或者可选的、由 Supervisor 管理的 llama.cpp 路径。Supervisor 不管 LM Studio、vLLM 或 SGLang 的进程。
- 自己管运行时:网关连 LM Studio 或兼容端点,由它加载 MiniCPM5-1B F16 和 MiniCPM-V 4.6 Q8。
- Supervisor 管 llama.cpp:
switchyard-runtime负责硬件检测、已批准清单和健康检查,再通过带认证的本地回环代理,接上一个常驻的 MiniCPM5 sidecar 和一个按需加载、空闲时卸载的 MiniCPM-V sidecar。 - 外部强模型在工作站信任边界之外,只有 Route 策略允许时才会被调用。
模型分工
| 角色 | 批准的模型 | Profile | 驻留方式 | 主要工作 |
|---|---|---|---|---|
| 文本与控制 | MiniCPM5-1B | F16,131,072 token 上下文,4,096 token 控制预算 | 常驻 | 分类、简单文本与工具调用、上下文压缩 |
| 多模态 | MiniCPM-V 4.6 | Q8,配置 131,072 token 上下文 | 受监管时懒加载 | 图像、OCR、文档、有序视频帧、视觉工具 |
| 困难工作 | 运维选定的强模型 | 取决于提供商 | 云端 | 困难或不确定的任务、策略允许的接管与压缩 |
MiniCPM-o 4.5、MiniCPM4.1-8B 和 MiniCPM5 Q4 不在 0.1 版本范围内。审核过的 LM Studio 配置要求显式写 minicpm5-1b@f16 这个模型 ID。测试环境里,短一点的 minicpm5-1b 别名会解析到一个没批准的 Q8 文件。
快速开始
GitHub Release 里有 Python 集成 wheel 和源码包。独立的原生服务端目前要从仓库用 Cargo 安装。
1. 安装原生服务端
先装 Rust 和 Cargo,然后运行:
git clone https://github.com/pzc163/MiniCPM-Agent-Gateway.git
cd MiniCPM-Agent-Gateway
cargo install --locked --path crates/switchyard-server
switchyard-server --help
2. 配置 MiniCPM Agent Route
建议直接拿审核过的配置改,不要手动拼能力 profile:
cp config/minicpm-agent.example.toml minicpm-agent.toml
# 先修改本地/云端 URL 和精确的模型 ID。
export MINICPM_AGENT_CLOUD_API_KEY="your-provider-key"  # pragma: allowlist secret
switchyard-server --config minicpm-agent.toml --dry-run
switchyard-server --config minicpm-agent.toml --host 127.0.0.1 --port 4000
如果用的是自己管的 LM Studio 端点,要配服务根 URL 和实测过的精确模型 ID:
[llm_clients.local_lmstudio]
format = "openai_chat"
base_url = "http://<lm-studio-host>:1234/v1"
use_legacy_max_tokens = true
max_retries = 0

[targets.minicpm5]
id = "minicpm5-1b@f16"
llm_client = "local_lmstudio"

[targets.minicpm_v46]
id = "minicpm-v-4.6"
llm_client = "local_lmstudio"
端点不需要认证的话,本地不用配 api_key_env。外部强模型的密钥走环境变量,别写成明文。然后另开一个终端验一下网关:
curl --fail http://127.0.0.1:4000/health
3. 通过策略 Route 发送请求
客户端通过 Route 的模型 ID 来选择数据边界:
{
  "model": "switchyard/minicpm-agent-cloud",
  "messages": [{"role": "user", "content": "Classify this task and complete it."}]
}
同一个服务端同时接受 OpenAI Chat Completions、OpenAI Responses 和 Anthropic Messages 请求。
作为库使用
switchyard-libsy 可以把继承来的路由引擎嵌进 Rust 应用。它只负责决定用哪个目标,模型调用交给宿主程序;如果想让库自己发出转换后的 HTTP 调用,配上 switchyard-llm-client。
[dependencies]
switchyard-libsy = { git = "https://github.com/pzc163/MiniCPM-Agent-Gateway.git", tag = "gateway-v0.1.0" }
switchyard-protocol = { git = "https://github.com/pzc163/MiniCPM-Agent-Gateway.git", tag = "gateway-v0.1.0" }
Route 数据策略
每条 capability_router Route 必须声明、而且只能声明一种策略。本地失败、队列压力、校验错误都不会覆盖它。
| 策略 | 云端行为 | 推荐场景 |
|---|---|---|
local_only | 请求内容永不上云;不支持或失败的工作返回本地错误 | 敏感附件、媒体、文档或物理隔离环境 |
cloud_allowed | 困难任务或安全回退时,原始请求可以发给强模型 | 以回答质量为优先的非敏感任务 |
cloud_redacted | 上云前做确定性文本脱敏和重新校验;不确定时 fail closed | 含有已知、可测试的密钥模式的文本 |
cloud_redacted 不做图像区域脱敏。敏感的图片、视频和文档只能用 local_only。
失败与流式语义
- 第一个可见流式事件之前出的本地失败,只要策略允许,可以把当前请求转给云端。
- 可见文本一旦发出去,失败就直接结束这个流。下一轮可以用任务级云端租约;网关不会把两个模型的输出拼在一起。
- 分类、上下文压缩、工具调用和用户可见的结构化输出,都会完整缓冲并校验,然后才使用或交付。
- 被
finish_reason=length截断的分类器输出,会给一次紧凑的恢复尝试;其他被截断的受控输出直接 fail closed。 - 请求如果同时超出云端上下文 profile,云端目标会先压缩并校验上下文,再生成最终回答。
其他路由策略
MiniCPM Agent Gateway 保留了 Switchyard 那套与提供商无关的路由算法,给需要不同路由行为的部署用。
| 策略 | 适用场景 | Route type |
|---|---|---|
| LLM Classifier | 根据请求内容选择弱模型或强模型档位 | llm_classifier |
| Stage Router | 根据对话信号路由每一轮,不额外调用模型 | stage_router |
| Escalation Router | 先让评审模型看弱档位的回答,再决定要不要升级 | llm_classifier,mode = "escalation" |
| Random | 为 A/B 测试或基线设置固定流量比例 | random |
链接
- GitHub:pzc163/MiniCPM-Agent-Gateway
- 发布版本:gateway-v0.1.0
- 上游项目:NVIDIA-NeMo/Switchyard
作者 pzc163。项目采用 Apache 2.0 许可证,保留了 NVIDIA 上游的版权与 NOTICE。