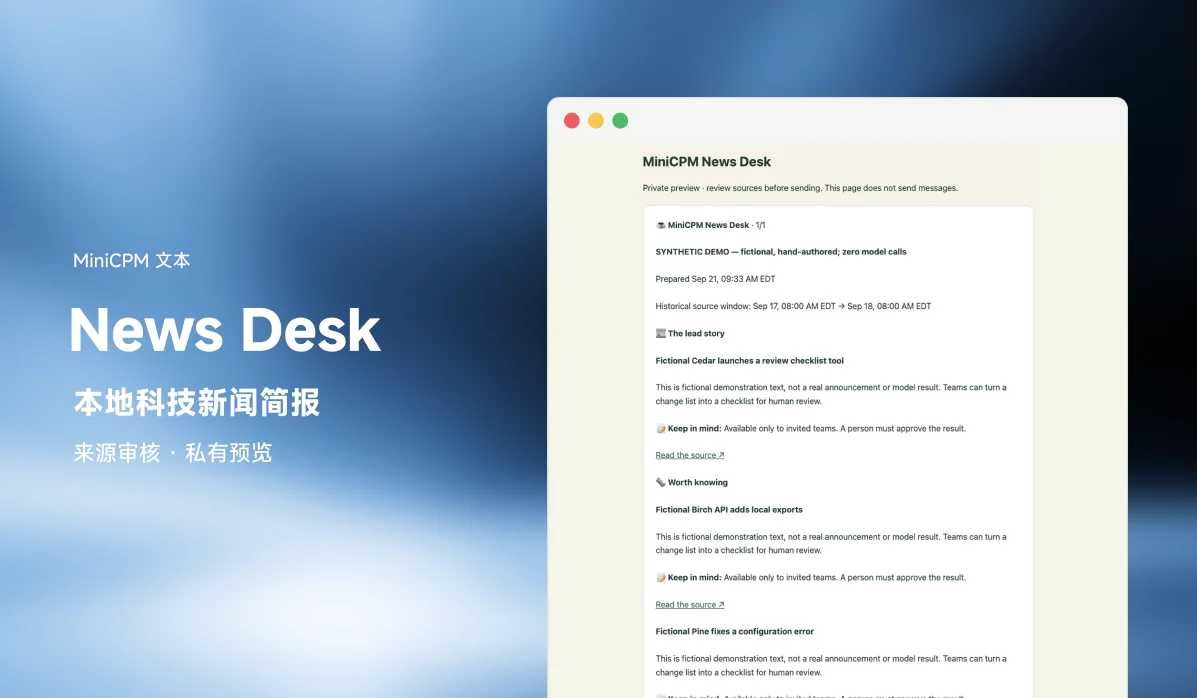
MiniCPM News Desk 是一个本地优先的新闻阅读器,由 MiniCPM5-2B 和一段普通 Python 代码驱动。它帮人审阅各家官方公告:每条内容都带能追回原文的段落,访问权限、定价、配置条件这类关键限制会直接摆出来。
仓库里给了一套公开的参考工作流:从固定来源抓 RSS、本地构建和预览、手动触发 Telegram 发送,还有恢复命令。本地模型和 Telegram 机器人得自己准备;项目不会安装定时任务,不会下载权重,也不会自动发任何消息。
作者自己最早那套部署跑在一台 Intel Core i5-9400F、16 GB 内存的 Linux 台式机上,MiniCPM 推理全靠 CPU。私有的采集器每小时查一次官方来源,每天通过 Telegram 推送一次前 24 小时的汇总。仓库开源的是可复用的简报逻辑,不是作者私有的采集器、Telegram 账号或机器配置。公开工作流用独立的状态和一份只有两个订阅源的注册表,私有采集器那边是 28 个来源。
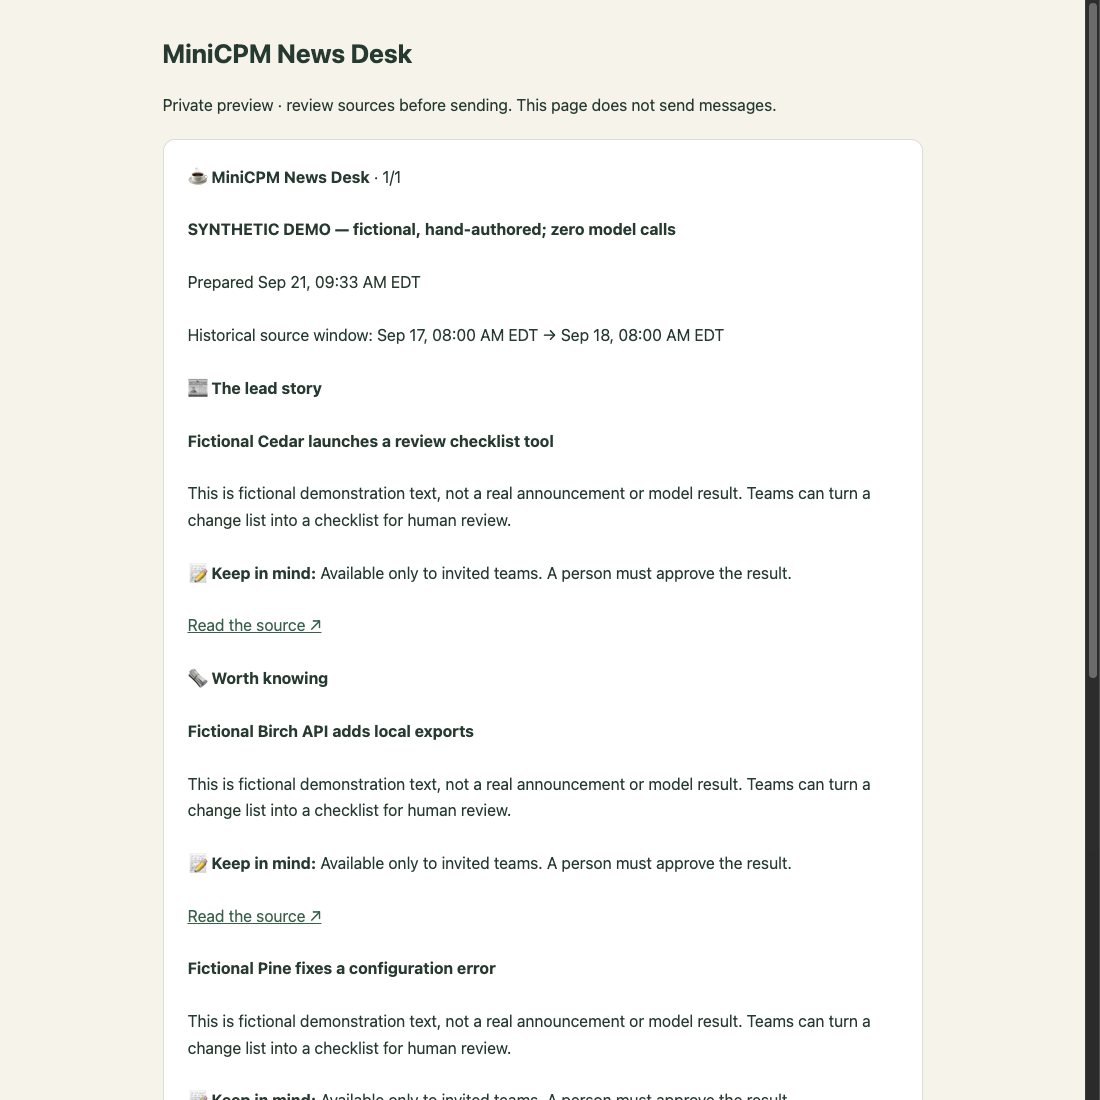
这张图是虚构的版式示例,不是模型真实输出的结果。
每天一份汇总,不做每小时推送
想做的是轻松的早间阅读:一条头条、几条值得知道的更新、几条简短快讯,全都链到原始来源。
- 大约在美东时间早上 8 点推送,覆盖的正好是前 24 小时。
- 采集全天独立跑,但不会每小时弹一条 MiniCPM 消息,也没有突发新闻提醒。
- 有发布日期就用来源的日期,没有就标发现时间。旧文章不会被当成新新闻重发,列表改动按“更新”算。
- 最多 9 条:1 条头条,最多 3 条详细报道。剩下入选的条目如果没有经过验证的摘要,就只给来源链接。
- 规范化 URL 会去重;同一来源、同一天、标题相同的事件也会去重。排序是确定性的编辑规则,不做大范围语义聚类。
- 实质性条件会保留。字数只是软目标,不会为了凑字数截断;长内容按段落拆成带编号的多条消息。
- 排不进的部分存到本地归档,只要还在 24 小时窗口内,之后还能补进来,并标出省略了几条。
工作原理
MiniCPM 只做一件事:从原文里挑出精确段落,不自由生成新闻稿。确定性的编辑层负责把相关限定条件留在简报里,把导航、无关的字段定义和背景细节挪到私有的辅助报告;没识别出来的条件照样留着。抽取到的完整原文,以及每条内容为什么放在这里,都记在报告里。
- 导入一份发现快照,或者显式抓取一篇受支持的文章。
- 保留原文的精确文本、身份标识、日期、哈希和偏移量。
- 用确定性规则留下跟条件有关的段落。
- 可选:请本地 MiniCPM 服务从候选里挑最多两个高亮段落的 ID。
- 把 ID 还原成精确引文,再对着原文审报告。
模型不能改写观点、换目标地址、调用工具或发消息,但它还是可能挑中无关段落、漏掉有用的段落,规则也可能漏条件。引用原文不等于对这些说法做了独立核实。
如果模型返回了合法但空的选择,报告会以 SOURCE-ONLY FALLBACK 的形式整篇显示原文。这是没排序的原文,不是 AI 摘要,也不算模型成功。不完整或非法的响应,以及被拦下的来源,仍然 fail closed。
抓文章是显式的网络操作,目前有 xAI /news/、OpenAI /index/ 和 GitHub /changelog/ 三个正文适配器。抓 OpenAI 时,两台测试主机都返回过 HTTP 403 或验证页面;项目没做任何绕过,被拦或不受支持的来源会保留成明确标注的链接。
本地模型选择
你得自己起一个已经跑起来、带认证、监听在数字回环地址上的服务。评测时用的配置是:MiniCPM5-2B-Q4_K_M、llama.cpp b10809/5266f24da、思考模式、8192 上下文、4096 输出 token,请求里设 reasoning_budget_tokens=512。通用的 OpenAI 兼容服务不一定支持这个控制参数。预检会看模型别名、上下文和模板,但不会对外部服务的运行时或权重做密码学校验。
每次调用只生成一次,外层超时 480 秒,不重试,也不回退到托管模型。API Key 通过 MINICPM_API_KEY 环境变量传入,别写进配置文件,也别提交到 Git。
当前验证结果
- 0.8.1:修了确定性来源保留的问题,270 个离线测试全部通过。另外在一个较早冻结的 0.8.1 检查点上做了 40 次调用的对比:1024 推理 token 在已知案例上覆盖比 512 好,但只跟一个探索性的确定性对照器打平,离质量目标还差;512 设置下有一条合成的指令型段落被选中。人工审阅仍然必要,发布设置还是 512。
- 0.8.0:加了公开参考工作流,修了技术字符丢失、许可信息漏检,以及准备阶段的一次误拦截;257 个离线测试通过,两次真实的本地选择和一次真实的 Telegram 推送验证了候选版本。
- 历史 0.7.5 私有测试:两条本地模型生成的简报和七条纯来源快讯,经两条确认送达的 Telegram 消息发出。
- 更早的选择器证据:110 个离线测试;一次修复后语义检查 7/8 通过,之后离线保存响应的处理 8/8 通过;另一次全新的 Linux CLI 冒烟测试 3/3 通过。这些是分开的测量,不能合成一个准确率。
本地测试的 API 费用是零,但硬件、电费和审阅时间都有成本。项目没有做跟云端的成本对比,也不做通用的可靠性承诺。
快速体验
不用模型也不用联网,就能看看虚构的每日版式(只用 Python 3.14 标准库):
git clone https://github.com/fenner888/minicpm-news-desk.git
cd minicpm-news-desk
python3.14 -m newsdesk.digest demo --out outputs/daily-demo-1
接上本地 MiniCPM,做真实的段落选择:
python3.14 -m newsdesk select --article outputs/article-1/article.json \
  --config config.local.json --allow-local-inference --out outputs/selection-1
有意为之的限制
- 所有输出都得人来审一遍意思。抽取式的措辞可能重复上下文,也可能把原文生硬的过渡一并带过来。
- 各项上限:原文 7,000 字符、120 个块、每块 2,000 字符;受保护文本 5,500 字符 / 30 块;候选池 4,000 / 25;选中文本合计 1,800 字符。超限时条目会被拦下,不会被悄悄截断。
- 英文标题和示例的启发式规则可能漏掉上下文。已知的类指令模式会拦下条目,但这不等于全面的注入检测。
- 没匹配到价格段落,不代表免费、不限量,也不代表还没公布。
- 项目没有账号体系、公开 API、UI 仪表盘,也不内置消息凭据。要不要装定时任务、要不要无人值守,由你自己决定。
链接
- GitHub:fenner888/minicpm-news-desk