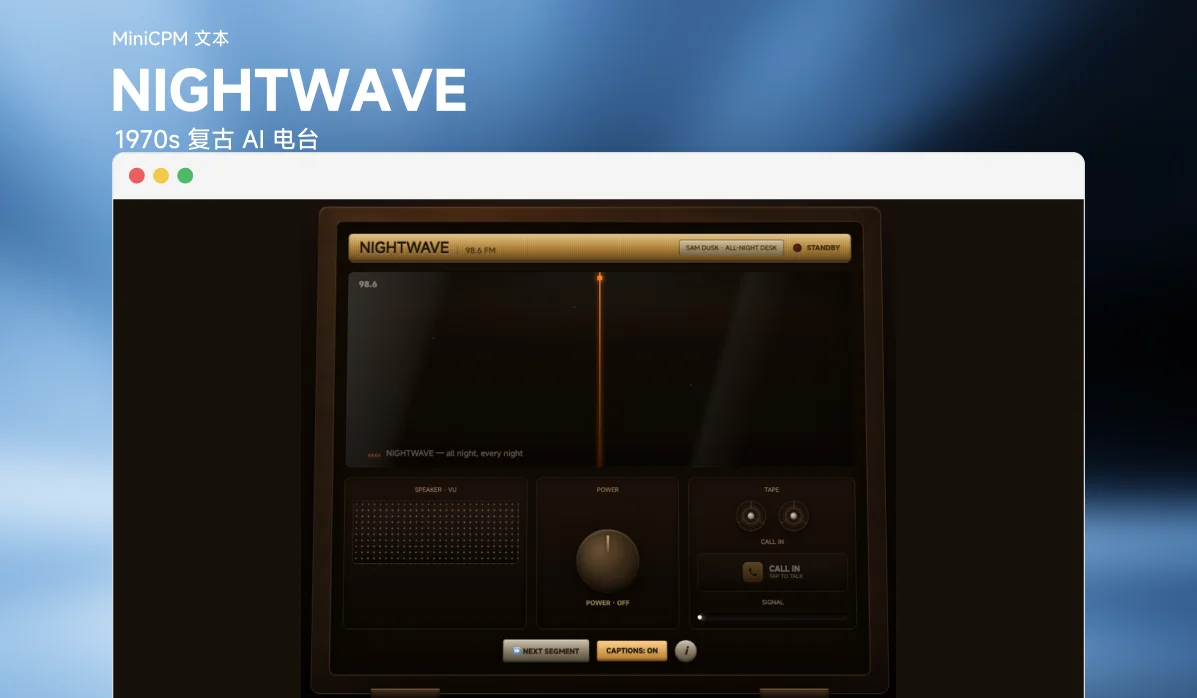
NIGHTWAVE 是一台 1970 年代的深夜电台,暖乎乎的,手工搭的,旋钮真能拧,台也真能收到。主持节目的 DJ 是一个 10 亿参数的模型。
把旋钮转到 98.6,一位深夜主持人就开始陪你熬过后半夜。他的声音来自 Kokoro 的 am_michael 音色。他会放一些根本不存在的歌手的唱片,念听众的点歌留言,播报地图上找不到的小镇天气,对着黑夜自言自语,还会当场接你的电话。每张唱片都是浏览器里实时生成的,没有采样,也没有版权问题。拿起听筒,或者直接按空格键,就能跟他说话。
作者自己的说法是:这是唯一一个可以闭着眼睛评审的参赛作品。NIGHTWAVE 参加了 Build Small Hackathon(Thousand-Token Wood 赛道)。
- 演示视频:YouTube
- 构建笔记:HF 博客文章
- 社交帖子:X 帖子串 · X 帖子
- 公开 trace 数据集:build-small-hackathon/nightwave-traces
核心特性
- 现场 AI DJ:MiniCPM5-1B(约 1.08B 参数,可微调)负责写串词,电台呼号、深夜随想、虚构天气、点歌留言、歌曲介绍,每段插播都是现写的。有听众来电时,他会围着对方说的真实内容即兴回应。这一点装不出来,也说明模型确实在线、确实在干活。
- 浏览器里生成音乐:一个小的 Web Audio 引擎为每首曲目渲染一段约 60 秒的 lo-fi / 氛围器乐,调式、音阶、速度、音色各不相同。曲目来自一个精选的虚构唱片库,每条包含标题、艺人和氛围。全程没有受版权保护的音频;也留了一个有文档说明的位置,可以放你自己的 CC0 mp3。
- 像真的广播信号:Kokoro 的声音要过一遍 AM 带通滤波(300 Hz–3.4 kHz)、轻度压缩、磁带饱和、板式混响,底下一直铺着黑胶噼啪声,听起来就像从电波里传出来的。DJ 还会压着每首歌的前奏说话。
- 不冷场:当前唱片还在放,下一段串词就已经在生成了;来电有延迟,先用预先缓存的“拖延”台词顶上;万一某次模型调用失败,还有预制片段让节目继续。
- 一台能上手操作的收音机:拟物化的木纹琥珀色机箱,有可拖动的调谐旋钮、随音频跳动的 VU 表、ON-AIR 电子管、转动的磁带盘、正在播放铭牌,还有一键通话的听筒(空格 = 说话,Esc = 挂断)。支持减少动态效果设置,也带字幕。
架构
Plain Text
 Browser (this HF Space, free CPU)              Modal (one GPU app, scale-to-zero)
 ----------------------------------             ----------------------------------
  Show loop (state machine):                     @modal.asgi_app (gpu=T4)
   break (DJ segments) -> song -> repeat          /asr   faster-whisper small -> text
  Generative music engine (Web Audio)             /brain MiniCPM5-1B GGUF     -> {text,mood,arc_cue}
  Broadcast audio chain + crackle bed             /speak Kokoro am_michael    -> {audio,words,times}
  Now-playing plate · sonic logo · VU
        |  fetch (same-origin /api/* ONLY)
        |  GET  /api/songs                     server-side proxy (FastAPI):
        |  POST /api/segment {kind, ctx}         builds host-persona prompts (arc.py)
        |  POST /api/call    {audio_b64}         calls /brain then /speak; sanitizes text
        v                                        holds MODAL_URL + proxy token in Secrets
   Space server (FastAPI + Gradio)               browser NEVER sees Modal creds
- 收音机界面是一个自包含的 HTML/CSS/JS 文档,挂在
/根路径下。放在顶层,麦克风和自动播放才能正常工作。另外在/gradio挂了一个极简的 Gradio Blocks,这样它才算一个真正的 Gradio 应用。 - DJ 始终是同一个人设:温暖、风趣(
arc.py: build_host_prompt)。节目结构由应用掌控,模型只负责把当前这一段说出来。 - 片段类型有
station_id、thought、weather、dedication、song_intro。随想和歌曲介绍由大模型写,其余来自content.py的模板,最后都通过/speak朗读。
技术栈
| 层 | 选型 |
|---|---|
| 大脑 | openbmb/MiniCPM5-1B GGUF(Q4_K_M),通过 llama.cpp 运行 |
| 语音识别 | faster-whisper small(CPU,int8) |
| 语音合成 | Kokoro-82M,音色 am_michael,带词级时间戳 |
| 音乐 | 浏览器内 Web Audio 生成式引擎(无模型、无采样) |
| 算力 | 一台 Modal T4,min_containers=0,可缩容到零 |
| 前端 | 自包含的拟物化收音机(HTML/CSS/JS),真实的 Web Audio 处理链 |
| 编排 | 免费 CPU 的 Hugging Face Gradio Space(Docker SDK,FastAPI + gr.Blocks) |
配置(Space Secrets)
| Secret | 含义 |
|---|---|
MODAL_URL | 已部署的 Modal asgi_app 基础 URL。 |
MODAL_KEY | Modal 代理认证 key,放在 Modal-Key 请求头里发送。 |
MODAL_SECRET | Modal 代理认证 secret,放在 Modal-Secret 请求头里发送。 |
NIGHTWAVE_MOCK | 设为 1,或者不设置 MODAL_URL,界面会用预制数据和静音 WAV 跑起来,不需要 Modal 后端。 |
NIGHTWAVE_TRACE | 设为 1 时,把只有内容的节目 trace(片段 + 来电,不含音频和个人信息)写进 traces/session.jsonl,用于公开 trace 数据集。 |
API(同源,浏览器只调这些)
GET /api/songs→ 精选歌曲库(驱动音乐引擎和正在播放铭牌)。POST /api/segment {kind, ctx}→{text, mood, arc_cue, audio_b64, words, wtimes},一段 DJ 片段。POST /api/call {audio_b64}→ DJ 的现场回答(以及来电者的转写文本)。POST /api/seek/GET /api/stalls→ 拍摄用的跳转,以及预缓存的延迟填充片段。
本地开发
Bash
pip install -r requirements.txt
NIGHTWAVE_MOCK=1 python devserver.py   # full radio + /api/* in mock mode, no Modal
# open http://localhost:7860
pytest tests/                          # arc / content / brain-contract unit tests
在 HF Spaces 上,容器跑 uvicorn app:app,在 / 挂着收音机界面和同源的 /api/* 代理,并在 /gradio 挂载 Gradio。
位置与隐私
如果你允许浏览器获取位置,NIGHTWAVE 只会把坐标发给 Space,用来查你所在地的天气、时间和城市(走 Open-Meteo 和 BigDataCloud),好让 DJ 聊聊你头顶真实的夜空。坐标不会被存储,也不会写进日志,可选的 trace 里最多出现解析出的城市名。要是拒绝授权,电台就给你播报那些不存在的小镇的天气。
相关链接
- Hugging Face Space:build-small-hackathon/nightwave
- 演示视频:YouTube
- 构建笔记:HF 博客文章