
一、写在前面
LaTeX是数学的数字化语言,是将数学想法录入数字世界的桥梁,收益无穷,但似乎有一定门槛。
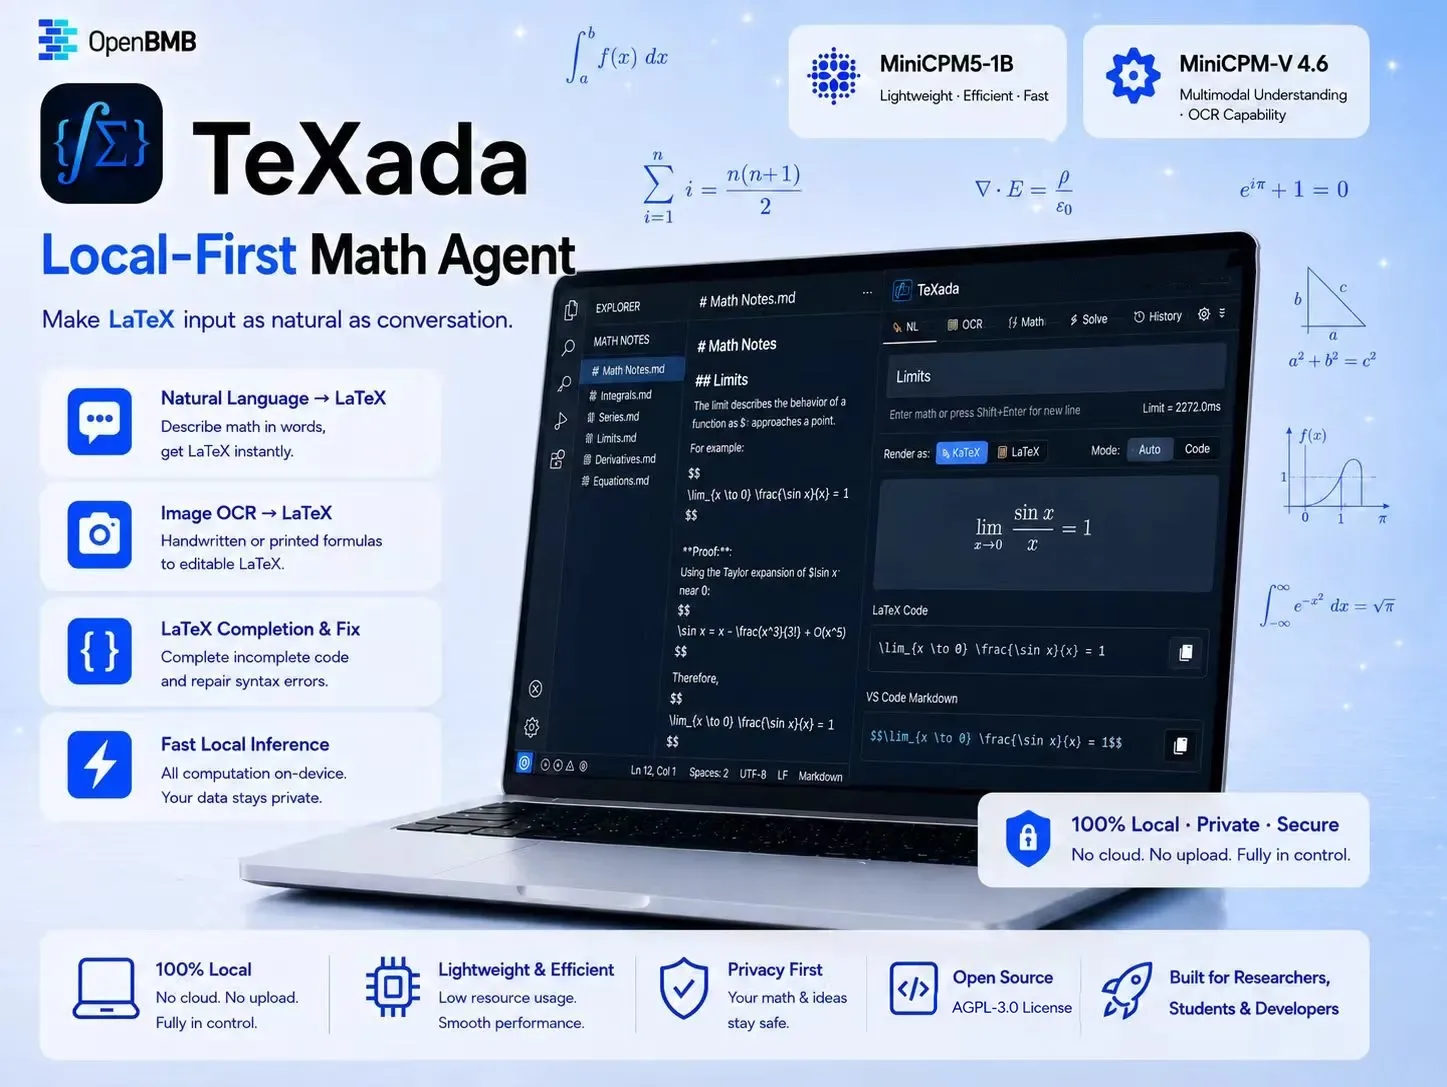
我用 MiniCPM5-1B + MiniCPM-V 4.6 两个模型造了一个真正可安装、可日常使用的桌面应用。
TeXada,是一个端侧结构化数学公式输入Agent。
这个 Agent 实现了:
- 把自然语言(如:求 k 从 1 到 n 的 k 平方)转成经过编译校验的 LaTeX;
- 把手写公式或截图 OCR 转成 LaTeX;
- 把错误的 LaTeX 修复、用KaTeX渲染出来并可以复制,所见即所得。
整个过程跑在自己的电脑上,Ollama 加载两个 MiniCPM 模型,不联网也能用,FastAPI 后端以 sidecar 形式随 Tauri 桌面应用打包,小巧轻便。目前发布到 v0.3.8,提供 macOS(Apple Silicon / Intel)DMG 和 Windows x64 安装包,AGPL-3.0 开源。
这篇文章回答两个问题:如此的小模型,组合起来到底能做出什么真实效果,以及,在把它做成 Agent 的过程中,我产生过哪些思考。
二、应用场景与实际效果
2.1 TeXada 是什么
一句话:不做套壳聊天机器人,做一个调用确定工具的数学输入法工具 Agent。
我并没有使用复杂的各种流行 Agent 框架,而是根据 TeX 的特点和需求调用工具,主循环是:
输入(自然语言 / 图片 / 残缺 LaTeX)
↓
MiniCPM5-1B Planner(规划下一步用哪个工具)
↓
TeX 工具执行(parse / compile / repair / diff / render / export)
↓
Observation(真实执行结果,回给 Planner)
↓
通过编译校验的结构化公式
两个模型各司其职,且只有这两个推理入口:
| 角色 | 模型 | 负责 | 明确不负责 |
|---|---|---|---|
| Planner / 文本 | hf.co/openbmb/MiniCPM5-1B-GGUF:Q4_K_M(Ollama) | 规划、工具选择、NL 候选、复杂补全 | 直接修复非法 LaTeX、模拟工具结果 |
| Vision / OCR | openbmb/minicpm-v4.6:latest | 从图片提出 LaTeX 候选 | 最终校验、语义 Diff、渲染 |
两个模型加起来不到 2.5B 参数,在16GB甚至8GB内存的笔记本电脑上就能运行,负责处理不确定的自然语言。
剩下的一切:解析、校验、修复、比较、渲染、导出,都使用基于规则的确定性工具。
2.2 三条真实产品路径
自然语言 → 结构化公式
输入 :probability density function
输出通过编译校验的:
f_X(x)\ge 0,\quad \int_{-\infty}^{\infty}f_X(x)\,dx=1
输入:求 k 从 1 到 n 的 k 平方输出
输出:
\sum_{k=1}^{n} k^2
手写公式 OCR:
用 MiniCPM-V 4.6 识别手写的定积分,得到候选,再由共享的 Agent 运行时编译、渲染后才标记为有效。视觉模型只提候选,不拥有独立的规划循环,失败定位因此很清晰:识别问题归 OCR,工具选择问题归 Planner,语法问题归校验器。
残缺 LaTeX 修复:
输入:缺右括号的高斯概率密度
输出:
f(x)=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^2}{2\sigma^2
repair_tex 用确定性规则补全分组、复验、渲染。
这里我比较自豪的一点,在于一种分而治之的边界感思想,即这个工具只做补个括号这种可复现的语法修复,不会替用户发明一个缺失的分母,那是语义问题。
2.3 实测数据
本地 Ollama + 默认模型的实测(端侧延迟随设备浮动,此处主要说明的是路径间的差异):
| 场景 | 结果 |
|---|---|
| 高置信度 NL 热路径 | 约 5~25 ms,0 token(走确定性候选,但照样过编译/渲染工具) |
| 带标点/同义词的 NL 界面用例 | 约 142 ms |
| 补全 x+\alp | 输出 x+\alpha,1 步 / 2 次工具调用 / 0 token |
| 手写积分图 OCR | 识别正确,端到端约 3.6~10.1 s |
0 token 但仍有完整工具轨迹,是这套架构里我个人最满意的设计。
Agent 化不等于每个输入都必须烧一次推理,但任何候选都必须过同一套编译和渲染门禁。
快速路径是加速器,并不意味着低质量的生成。
2.4 产品形态
桌面上它是常驻工具:全局快捷键唤起、显示在桌面端顶部快捷复制(写论文不用切窗口)、历史与运行日志可翻查、每次请求有唯一 run ID 和完整 Agent trace、全部数据可导出备份。
仓库里附带三段真实录屏(NL / OCR / 修复各一),没有 coding agent 或者 chatbot 形态的终端窗口,它更像一个极简的自然语言到 LaTeX 的输入法。
三、Agent 经验与可沉淀方法
当然,我也踩过一些坑,走过一些弯路,也相信一些经验能够复用、沉淀,在执行门槛降低的前提下,我愿意把自己宝贵的思考路径共享给大家。
3.1 小模型不是缩小版的大模型——运行时必须硬
MiniCPM5-1B 在开放循环里的典型失败模式,我全都遇到过:
- 工具调用的 XML/JSON 格式畸形;
- 反复调用同一个工具;
- 收到错误 Observation 后无视并继续原计划;
- 多轮之后忘记用户最初要的算符(把 \sum 悄悄写成 \int);
- 每轮都往公式里多加一层反斜杠转义;
- 迟迟不给 final answer,或用自然语言解释代替裸 LaTeX。
所以,不能只是套壳写一个 prompt 然后相信模型自我约束。
TeXada 的硬核 Agent 运行时约束应运而生:
- Planner 默认最多 3 步(可配 1~8);
- 每次工具调用计算规范化指纹,重复调用立即熔断;
- 连续两次工具错误熔断;
- 推理请求和 API 请求都有超时;
- 最终 runtime guard 兜底:
哪怕 Planner 彻底失败,运行时仍会强制 compile → 必要时 repair → render,
用户永远拿到一个"可编译或明确失败"的结果,而不是半截字符串。
每一步的停止原因都是结构化枚举(render_confirmed / repeated_tool_call / tool_error_limit / max_steps_or_empty_final……),可统计、可回归测试。
3.2 铁律:LLM 决策,工具执行,编译器验证
1B 模型可以决定下一步,但 任何正确性判断都不能完全依赖它而毫无门禁。模型完全可能输出一段看起来非常可信、实则括号不配对或算符降级的公式。
TeXada 把六个工具做成窄 schema 的单一职责单元:
parse_tex ·
compile_tex ·
repair_tex ·
semantic_diff ·
render_math ·
export
其中 repair_tex 不是模型端点,是本地确定性规则。
Planner 识别需要修复,但真正的修复动作无模型、可单测、可复现。
题外话,我曾经想为这个需求,设计一个TeX2TeX的修复模型。也许我会继续探索,但暂时只保留了双模型及规则。
3.3 深度绑定 MiniCPM5 的原生协议
这是最MiniCPM的一条经验。TeXada 同时兼容两种工具调用形态:
- SGLang(--tool-call-parser minicpm5)返回的 OpenAI 风格 tool_calls;
- Ollama/GGUF 路径下 MiniCPM5 原生的 XML function calling。
两者在 agent / protocol.py 里归一化为同一个 PlannerTurn 结构,下游完全无感。另一个实战细节:MiniCPM5 有时把答案放进 reasoning 字段而 content 为空,模型封装层必须从两个字段都能提取 LaTeX,否则会拿到空输出误判成失败。
3.4 防语法正确但答错题:算符漂移 Guard
小模型最阴险的失败不是崩溃,而是流畅地答错:公式完全合法,但用户要的是求和、它给的是积分。分而治之重要,但语义错误修复也同样重要。为此,TeXada 有一级 Level 0 Guard:
- 期望算符的存在性 / 降级检查(该有 \sum 就不能变 \int);
- 失败的锚点喂回有界的 Planner 重试循环;
- 所有 Planner 轮次仍漂移时,对特定窄模式允许最后一次确定性模板恢复。
配套的 Level 1 是语义 Diff:把公式归一化为数学语义单元,用角色感知的加权树对齐比较 before/after。它明确不把自然语言伪装成参考 AST——只有两个真实公式版本都存在时才算结构差异。这个 Diff 输出编辑脚本、加权代价和 [0,1] 相似度,天然可以充当后续评估或训练的 reward 信号。
3.5 最痛的一课:确定性工具也必须有预算
v0.3.8 之前我一直默认确定性模块天然可靠。
实测推翻了它,三个普通用户输入就能触发的故障:
- 3151 字符的合法 \frac 嵌套链击穿 V8/KaTeX、容错解析器和递归序列化器;
- O(m·n) 的语义 Diff在 1200 节点时跑约 65 秒,2000 节点直接 SIGBUS;
- 工具调用本身没有执行上限。
这些输入从哪来?模型生成的。确定性只保证可复现,不保证计算有界。
v0.3.8 的修复(ADR-010):
- 任何 V8/KaTeX 调用前的嵌套深度预检(上限 100),解析/序列化/diff 各自再加深度预算与 RecursionError 兜底;
- 语义 Diff 超过 1 万对子节点配对预算时显式降级为线性对齐,报告 degraded: true,不卡死请求;
- 所有 TeX 工具移到 worker 线程,带 10 秒墙钟超时;
- V8 上下文失败自愈(最多重建 3 次)。
沉淀: 所有处理模型生成输入的确定性工具,都必须有显式的时间、空间和结构预算;超限就返回显式降级结果。
3.6 可观察性是 Agent 的另一半
每次请求(成功和失败)都有唯一 run_id,并存储在日志文件中,支持导出,日志记录模型、延迟、token、工具调用序列、停止原因、完整 trace。
比如,HTTP 请求成功和公式有效是 两个独立状态——失败请求照样进运行日志,但绝不伪造成功历史。
这套 Request Ledger 让我能从真实日志里统计 stop reason 分布、把高频失败 case 转成确定性规则或测试 fixture,形成"使用 → 观察 → 固化"的闭环。
没有一蹴而就的 harness,只有 bad case 的经验沉淀。
3.7 经验总结
- 给小模型的自由度设硬边界:步数上限、重复调用指纹熔断、连续错误熔断、超时、最终 runtime guard 兜底,缺一不可;
- 正确性判断交给编译器/校验器,不交给模型自信;
- 兼容模型的原生工具调用协议(MiniCPM5 的 XML 格式),与服务端归一化的 tool_calls 统一到一个内部结构;记得处理 reasoning 字段回退;
- 零 token 快速路径可以省推理,但不能绕验证;
- 为语义错误等假性成功设专项 Guard(算符存在性/降级检查),而不只防语法错误;
- 把输入输出结构化成语义单元,让每步结果可比较、可解释、可当 reward;
- 确定性工具也要有资源预算——模型生成的输入是不可信输入;
- 每个请求留日志,请求成功与结果有效分开记。
四、结语:没有完美的人工智能,harness 建立在生态上
回头看这半年的版本迭代,TeXada 中:
MiniCPM5-1B 的角色很精确:它只需要会挑一个小工具、读懂执行结果、决定是否再来一步有界尝试——这恰好是 1B 模型踮脚够得着、又真有价值的位置。
MiniCPM-V 4.6,则以 1.3B 之身把手写公式变成可编辑结构,则是整个 OCR 路径的入场券。
正如我第一次看到面壁的愿景时,被那句让大模型飞入千家万户所打动。TeXada 想通过实验性Agent证明的是这句话的下半句:飞入千家万户的模型不需要很大,但需要有人认真替它们设计边界。
开源地址与共建邀请
项目以 AGPL-3.0-or-later 完全开源,欢迎取用,更欢迎回来:https://github.com/CacinieP/TeXada-the-Math-Agent
尤其想邀请大家提两类 issue(仓库备好了 bug / feature 双语模板,贡献指南在 .github/CONTRIBUTING.md):
- good case —— 让 TeXada 一次跑通、结果漂亮的输入。它们会被沉淀为回归测试和示例,把已经做对的部分守护住;
- bad case —— 让模型漂移、修复越界、运行时熔断或工具降级的输入。
这些才是真正的燃料。3.3 节的协议归一化、3.5 节那三条故障路径、3.7 节清单里的每一条最初都是某个具体的 bad case。每一个新 bad case 都会沿同一条流水线被消化:复现 → 定位归属层(OCR / Planner / 校验器 / Diff)→ 变成确定性规则、Guard 锚点或回归 fixture → 进入下一次发布。
没有完美的人工智能,只有不断因 case 丰富的 harness 体系。 小模型 Agent 的可靠性从来不是模型自带的,而是来自对于不确定性的管理,即 harness:步数预算、算符锚点、语义 Diff、资源上限。 这层 harness 的进化速度,取决于它见过多少真实输入;而真实输入的规模,取决于有多少人愿意把使用中遇到的 case 带回来。
所以,非常感谢朋友们看到这里,也欢迎 issues 和 star,欢迎 fork,更欢迎带着你的 good case 和 bad case 来。
也欢迎把第 3.7 节那张清单搬进你自己的端侧 Agent 项目 —— 如果它帮你少踩了一个坑,回来告诉我们是哪一个坑,它就会变成清单的下一条。
关于本项目中更多的决策细节 changelog 与思考,可以异步 github 的 docs 文件夹~
非常感谢您的观看~欢迎关注、评论、留言,您的支持是我进步和分享的动力~