Viva Mais AI 是给巴西旅行社 Viva Mais 做的本地优先 WhatsApp 助手。老板靠 WhatsApp 卖机票,大量的活却在后面:反复手打行程、核对谁付了款、追着要证件、深夜还得回消息。Viva Mais AI 把一份原始的 WhatsApp 聊天导出变成 CRM 仪表盘,全程只跑本地小模型,客户数据不出本机。
项目是 Hugging Face × Gradio Build Small Hackathon 的参赛作品(Backyard AI 赛道)。
演示
- 演示视频:final-demo.mp4
- X 上的讲解视频:@amphetamarina
- 项目博客:Viva Mais AI build-small-hackathon blog post
工作原理
用户上传 WhatsApp 的原始对话导出(一个包含媒体文件的 zip)。每张图片、每个 PDF 都会被识别成一种有类型的“单据”:报价、预订、登机牌、付款凭证、发票、住宿、身份证件。识别不了的会明确标成“未分类”,转写内容完整保留;语音消息交给 whisper 转写。基于这些单据,应用拼出一个 CRM 风格的仪表盘:客户身份、预订、付款、销售漏斗阶段,以及下一步该做什么。
手边没有导出文件也没关系。内置的合成演示会加载一段虚构的小型 WhatsApp 对话,在编造的数据上跑完整条流水线:一份报价、一个预订、一笔付款、一张登机牌。
技术栈
- 模型:MiniCPM-V 4.6 负责转写并分类每张图片;在巴西葡萄牙语 WhatsApp 对话上微调的 MiniCPM5-1B 负责抽取结构化字段、回答仪表盘里的问题;在 Common Voice 葡萄牙语上微调的 whisper-small 转写语音;PDF 文本由 pypdf 读取。结构化抽取用 DSPy 在进程内模型上编排。所有模型都在进程内跑,不调用外部 API。巴西葡萄牙语的提示词、术语表和演示都保留正确的重音符号(orçamento、sessão、cartão),因为微调数据用的是带重音的文本,不是去掉重音的 ASCII 近似写法。
- RAG(NVIDIA Nemotron):仪表盘问答靠混合检索。nvidia/llama-nemotron-embed-vl-1b-v2 在上传流水线末尾给语料做多模态嵌入:每张收据或机票的图片和 OCR 文本合成一个向量,客户信息卡、滑动窗口内的对话也一并嵌入;提问时再嵌入问题。语义 top-k 片段会和确定性的领域匹配合在一起(问题里提到的客户、乘客、预订代码、交易 ID,总会带出它的全部事实)。这样 1B 回答模型只需要读一小块精确上下文,不用吞下整段对话。
- 运行时:启动时自动检测。在 ZeroGPU 上,所有推理都走
@spaces.GPU函数里的 torch;在真实 CUDA GPU 上,视觉走 transformers,问答走全量卸载到 GPU 的 llama.cpp;在 CPU 上,全部用 llama.cpp GGUF Q4 和 faster-whisper int8。Modal 只用来做数据整理、评测和 LoRA 微调,部署后的 Space 不依赖它。 - 前端:完全不用 Gradio 自带组件。界面是手写的超媒体应用:
gr.Server保留 Gradio 的队列、流式和 ZeroGPU 能力,普通 FastAPI 路由返回服务端渲染的 HTML,由 HTMX + hyperscript 驱动(本地打包,没有构建步骤,不挂 CDN)。设计照着旅行社柜台来:单据渲染成带撕角存根和 CSS 条形码的登机牌卡片,KPI 是翻牌式出发显示屏,销售漏斗是一条有飞机在飞的航线,对话是像素级还原的 WhatsApp 回放,模型调用记录做成了塔台雷达终端,机器人牛角鱼吉祥物用纯 CSS 精灵动画对流水线做出反应。每个流式 tick 都是一段 HTML 片段,其中的hx-swap-oob片段一次更新五个区域;浏览器通过 Gradio JS 客户端驱动 ZeroGPU 的续跑循环。据作者所知,这是第一个跑在gr.Server上的 HTMX 前端。 - 架构:Clean Architecture(domain、application、adapters、frameworks)。
- 工具链:本地开发和 CI 用 uv + ruff + mypy;Space 从
requirements.txt装依赖。
微调模型
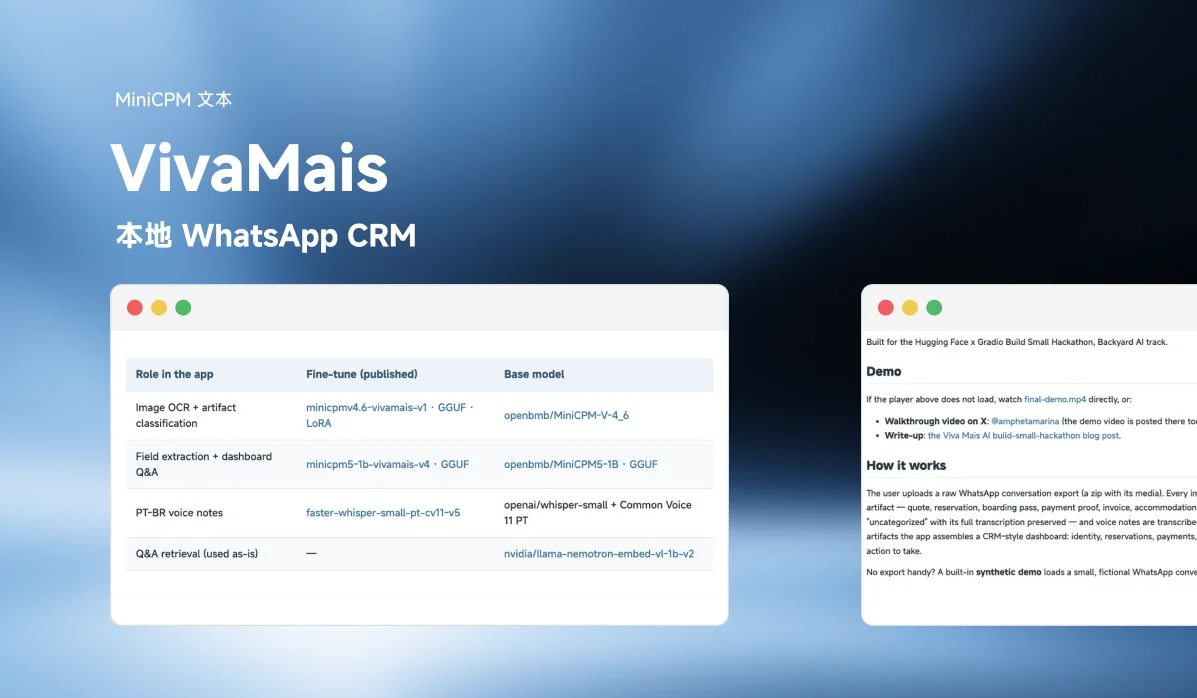
模型都在进程内跑,远低于黑客松的规模上限,最大的只有 1.3B。每个微调模型都带模型卡发布,基座都是 OpenBMB 模型。
| 在应用中的角色 | 微调模型(已发布) | 基座模型 |
|---|---|---|
| 图片 OCR + 单据分类 | minicpmv4.6-vivamais-v1 · GGUF · LoRA | openbmb/MiniCPM-V-4_6 |
| 字段抽取 + 仪表盘问答 | minicpm5-1b-vivamais-v4 · GGUF | openbmb/MiniCPM5-1B · GGUF |
| 巴西葡萄牙语语音消息 | faster-whisper-small-pt-cv11-v5 | openai/whisper-small + Common Voice 11 PT |
| 问答检索(直接使用) | — | nvidia/llama-nemotron-embed-vl-1b-v2 |
公开发布的脱敏训练数据:
- marinarosa/vivamais-synthetic-ptbr:合成的、重音正确的巴西葡萄牙语单据语料(不含客户个人信息)。
- marinarosa/minicpm5-vivamais-text-sft-v4:文本 SFT 混合数据。
在 Modal 上训练
所有微调、数据整理和评测都在作者自己账户的 Modal GPU 上完成,和部署的 Space 完全隔离。训练循环由 OpenAI Codex(GPT-5.5,x-high reasoning) 指挥。这是整个构建里最漫长、最琐碎、最不能出错的一段,每次运行都写进带日期的日志(finetune/*/reports/*_runlog.md),Field Notes 的复盘因此有据可查。
- 视觉(MiniCPM-V 4.6,LoRA rank 64,A10G):以合成数据为主(约 2.2k 份重音正确的渲染单据),再加师生蒸馏。教师模型 prefeitura-rio/Rio-2.5-Open-VL(巴西葡萄牙语 VLM)在 A10G 上打标签,Qwen2.5-VL-32B 作为评审在 A100-80GB 上按重音保真度和 schema 合理性筛样本,然后才训练。对重音敏感的评测框架和 Q4_K_M GGUF 导出也都在 Modal 流水线里跑。和基座模型比,留出集上的单据类型准确率 0.006 → 0.58,巴西格式字段准确率 0.81 → 0.88。
- 文本(MiniCPM5-1B,QLoRA,A100):训练数据是公开语料(GigaVerbo)混上合成的 WhatsApp 问答,语种为巴西葡萄牙语,用 Unsloth 训练,然后合并、导出 GGUF、评分。准备、训练、合并、评测各是共享数据卷上的一个 Modal 步骤,步骤之间设隐私和泄漏检查。
- 语音(whisper-small):在 Common Voice 11 葡萄牙语上微调,导出成 Space 加载的 faster-whisper / CTranslate2 格式。
隐私上不让步:教师和评审模型只在作者自己的 Modal 账户里跑,身份证件排除在所有数据集之外,也从不发布,原始导出、音频和个人信息都不离开本机。
构建文档
USE_CASES.md:按优先级写的 Given/When/Then 用例,描述产品。AGENTS.md:工程约定(TDD、BDD、Clean Code、Clean Architecture、原子提交、工具链、项目细节)。TASKS_PROMPTS.md:从零实现的规格说明,每个任务一条给编码智能体的精确提示词。ARTICLE.md:Field Notes 复盘,讲怎么借助编码智能体构建,以及微调小模型的真实收获。
快速开始
uv sync          # install deps (dev group included)
make check       # ruff + mypy + pytest (unit and Gherkin acceptance, offline)
make run         # launch the Space with the mock backend, no model needed
相关链接
- Hugging Face Space:build-small-hackathon/vivamais
- 项目博客:Viva Mais AI
项目作者:marinarosa。