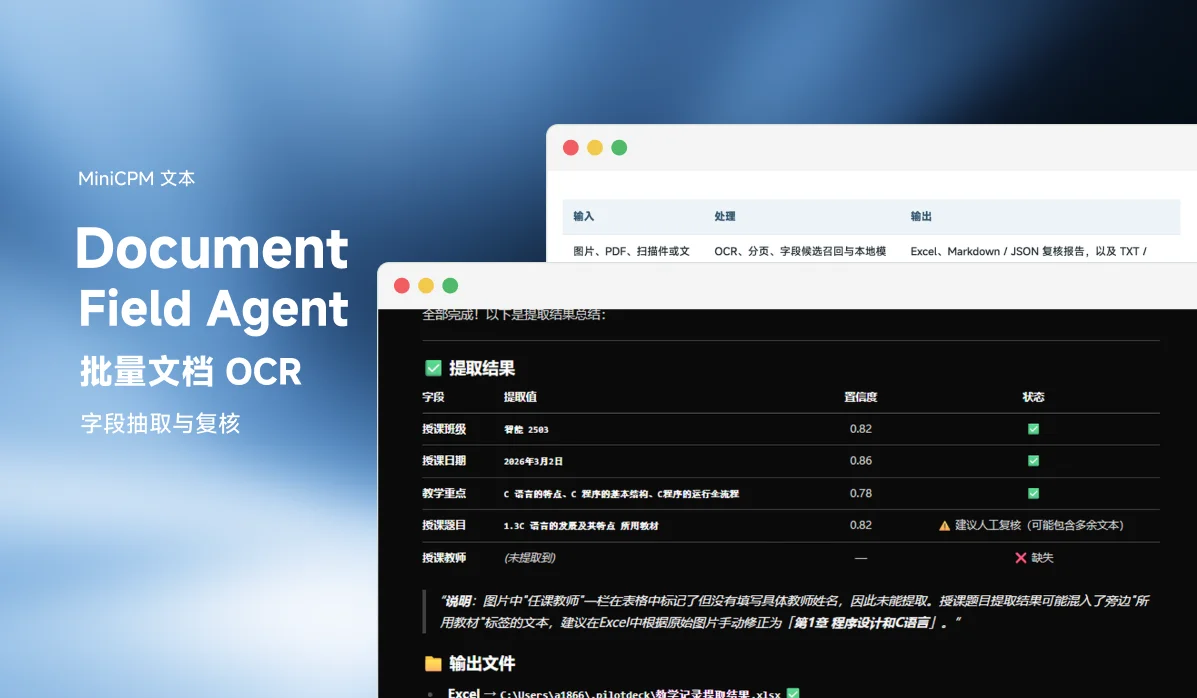
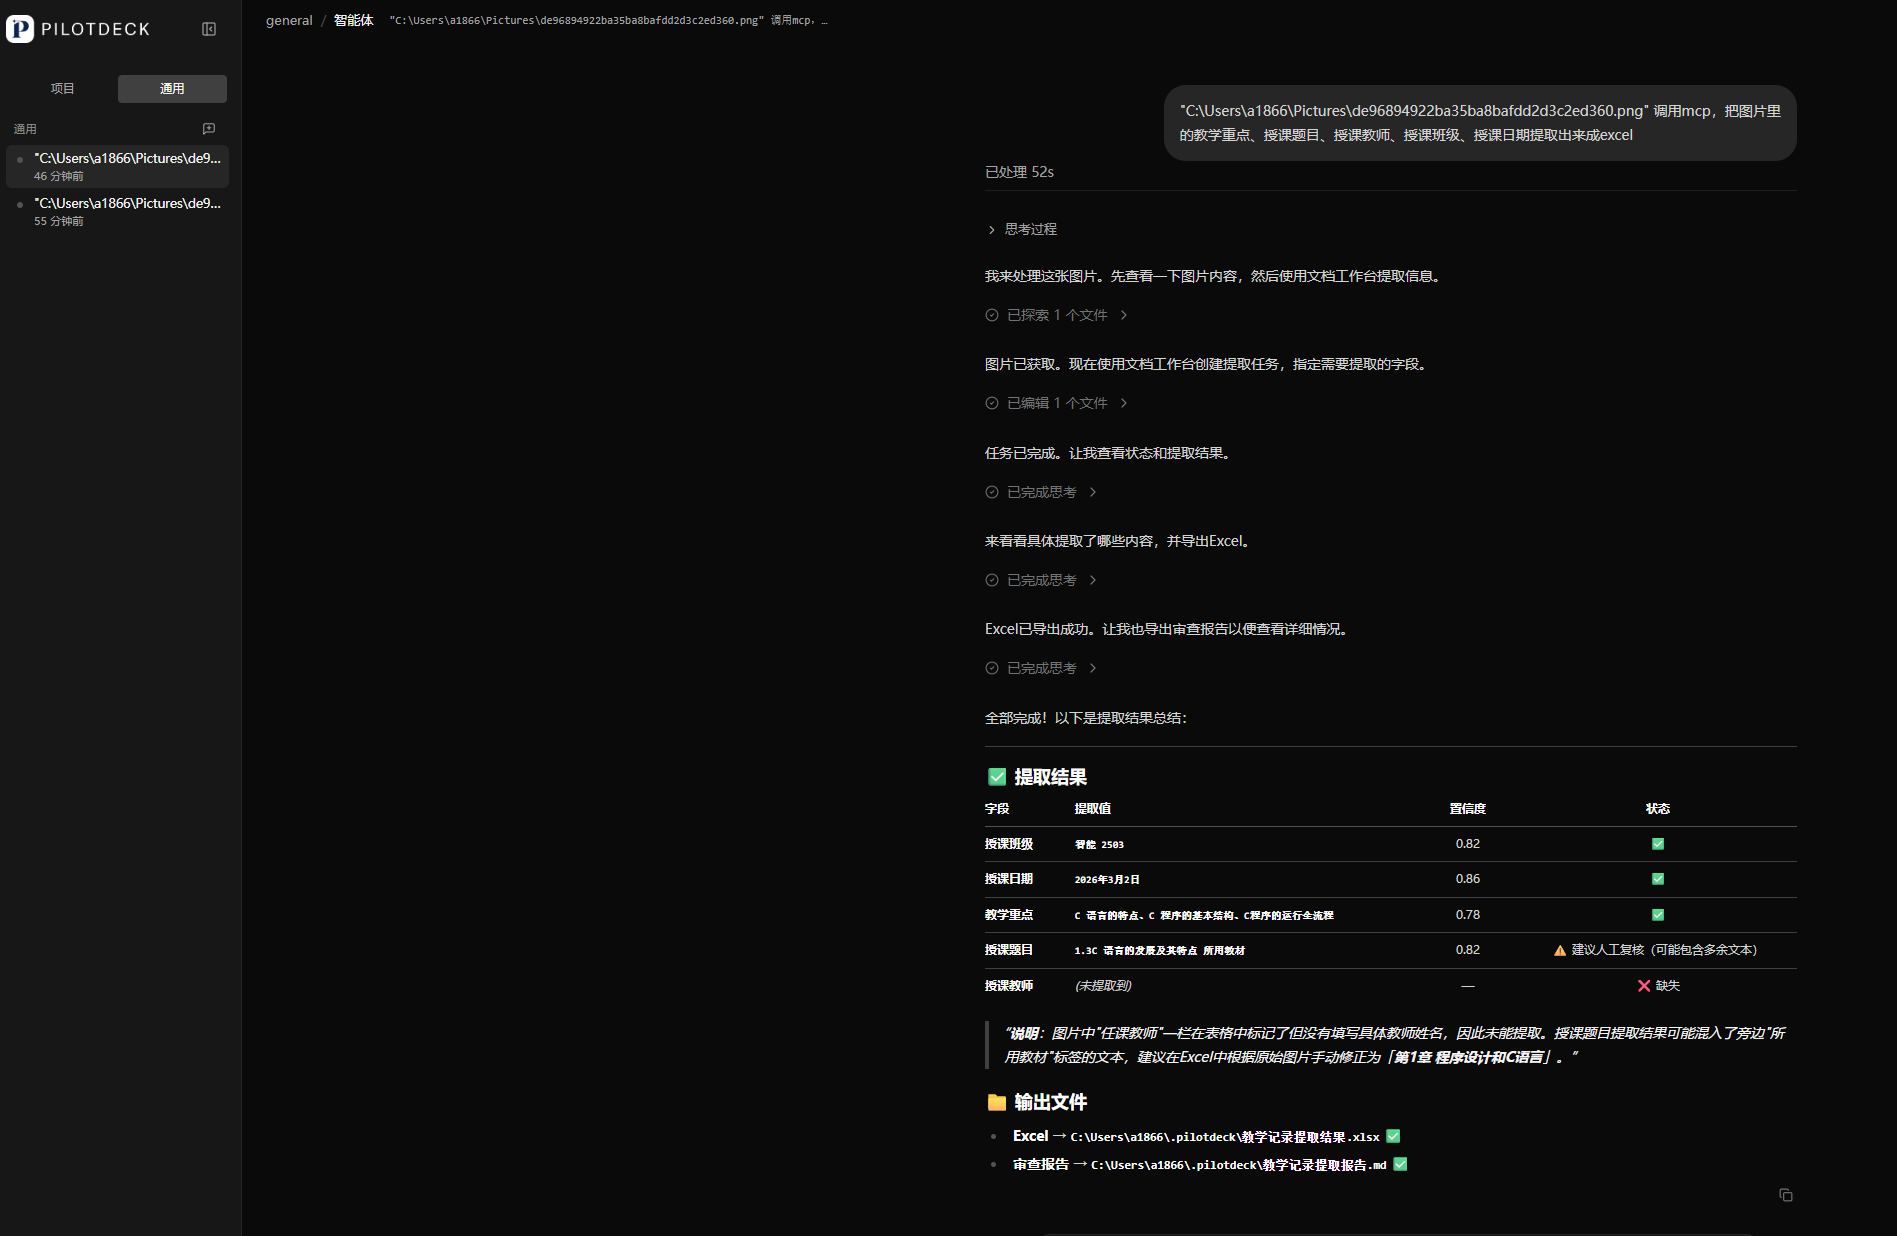
Document Field Agent 把本地的 PDF、图片和扫描件批量转成可复核的字段结果和 Excel。它默认在本地用 PP-OCRv6 做 OCR,再由 MiniCPM5-1B 裁决字段值。同时暴露标准 MCP 接口,任何兼容的 Agent 都能用它跑任务、导出结果、生成复核报告。
特点:Windows 已验证 · 本地优先 · MCP stdio · Excel 与复核报告
从文件到可复核结果
| 输入 | 处理 | 输出 |
|---|---|---|
| 图片、PDF、扫描件或文件夹 | OCR、分页、字段候选召回与本地模型裁决 | Excel、Markdown / JSON 复核报告,以及 TXT / CSV / HTML |
它适用于教案录入、合同台账、表单归档、档案整理、票据或证明信息提取这类重复性文档工作。上传文件、指定字段,就能拿到“每页一行、字段为列”的结构化结果;缺失项和低置信度字段会被标出来,方便人工复核。
核心特点
- 本地处理文档:默认用 PP-OCRv6 做 OCR。拿到 OCR 文本、候选召回和版面判断之后,由 MiniCPM5-1B 裁决字段值。
- 结果可复核:置信度低于
0.7的字段会被标成复核项,拿不准的值不会当成最终答案。 - MCP 是通用接口:MCP Server 走 stdio,通过本地 HTTP API 调度工作台,不绑定某个特定的 Agent 客户端。
- 可选云端模式:需要更高精度的文档解析时,可以显式配置 PaddleOCR-VL-1.6 和 DashScope qwen-plus;默认仍是本地模式。
工作方式
本地 PDF / 图片 / 文件夹
  -> PDF 渲染与分页
  -> PP-OCRv6 本地 OCR 或可选云端解析
  -> 字段候选召回与版面判断
  -> MiniCPM5-1B 本地字段裁决
  -> 置信度校验与人工复核
  -> Excel / Markdown / CSV / HTML / TXT
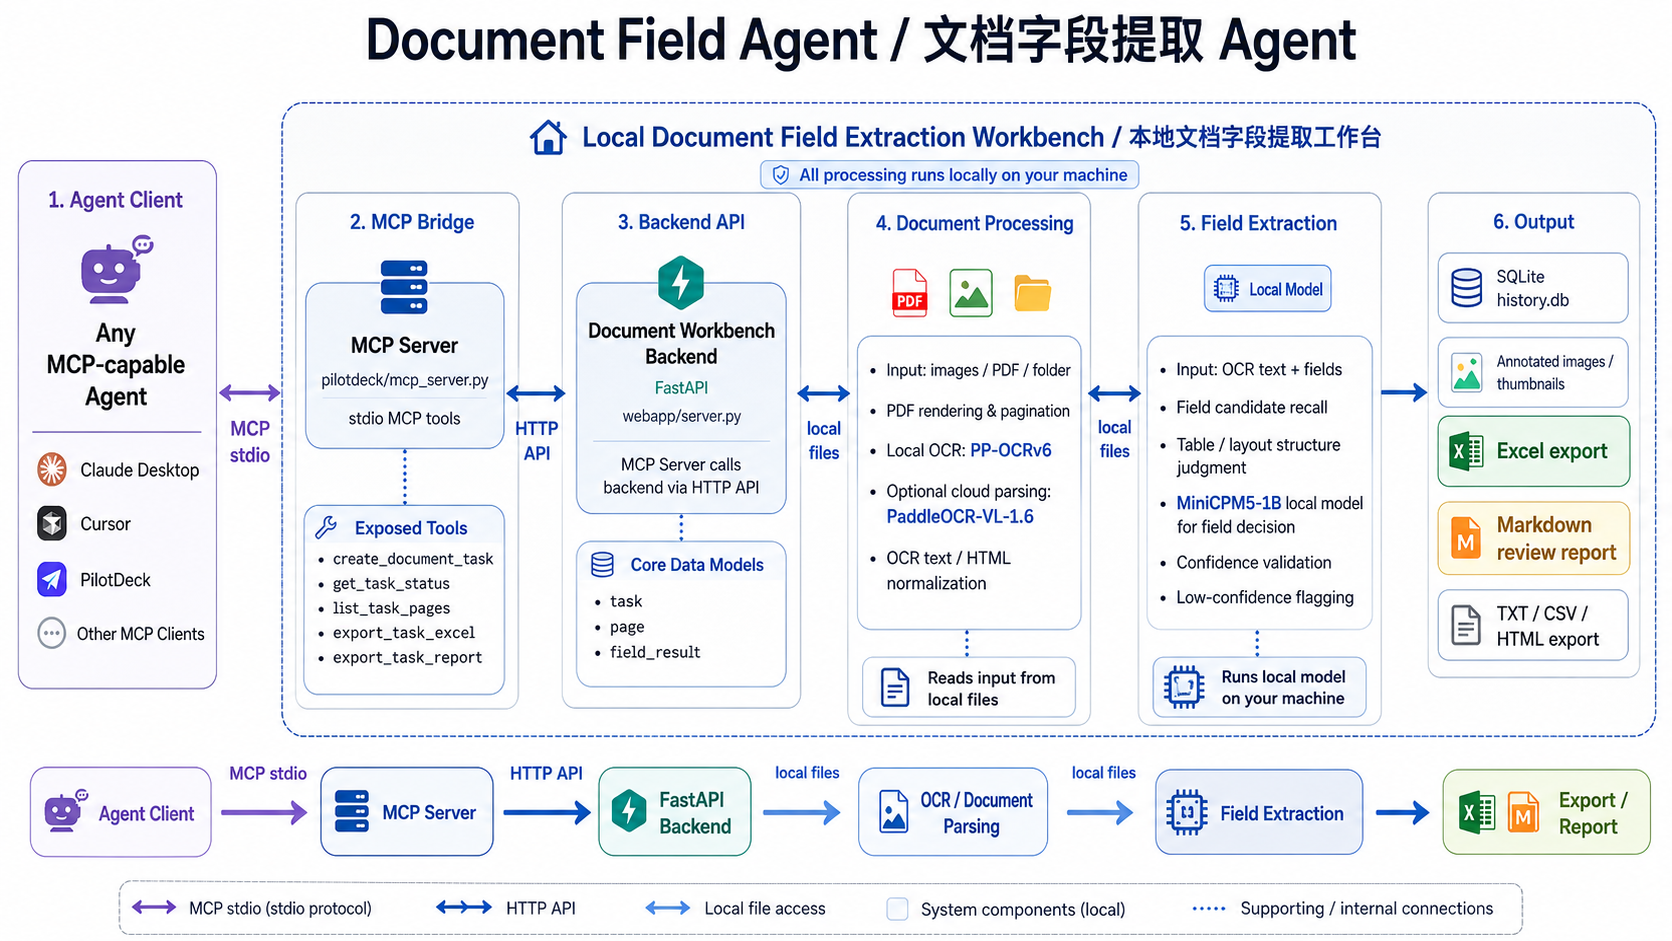
MCP Server 在 pilotdeck/mcp_server.py,默认连 http://127.0.0.1:8766。它只负责调本地工作台的 API,OCR、字段抽取和导出还是工作台做。
本地字段抽取用的是约 700 MB 的 MiniCPM5-1B-Q4_K_M.gguf,以 llama.cpp 的 CPU sidecar 运行(默认端口 11435,4096 上下文,chatml 模板)。
快速开始
-
克隆仓库,创建虚拟环境并安装
requirements-webapp.txt。 -
下载本地模型:
Bashbash scripts/download_models.sh allpython scripts/setup_minicpm5_sidecar.py这会下载 PP-OCRv6 Tiny / Small / Medium ONNX 模型,以及 MiniCPM5-1B GGUF 和 llama.cpp sidecar。
-
启动本地字段抽取 sidecar:
Bash./tools/llama/llama-server \-m ./models/minicpm5-1b-q4_k_m.gguf \--host 127.0.0.1 --port 11435 \-c 4096 -t 8 --chat-template chatml -
启动工作台
python webapp/server.py,在浏览器打开http://127.0.0.1:8766。
使用工作台
- 在首页上传 PDF、图片或文件夹。
- 填写要抽取的字段,比如姓名、单位、课程名称、合同编号、日期或金额;也可以上传 Excel 模板,系统会读第一个 sheet 第一行的字段名。
- 选择本地或云端模式,等任务处理完。
- 在结果页看 OCR 全文、字段结果、缺失项和低置信度提示。
- 导出 Excel 或其他格式,再按复核报告处理待确认项。
接入 MCP Client
保持工作台运行,在 MCP 客户端里把 pilotdeck/mcp_server.py 配成 stdio 服务(用环境变量 DOC_WORKBENCH_URL 指向工作台)。可以先用 python pilotdeck/mcp_server.py --list-tools 看一下工具列表。之后 Agent 按这个顺序干活:
create_document_task:传入明确的本地文件或文件夹路径,以及目标字段。get_task_status:拿任务状态、缺失字段和低置信度字段。list_task_pages:需要页面级 OCR 和字段证据时再调。export_task_excel:导出 Excel。export_task_report:导出 Markdown 或 JSON 复核报告。
隐私敏感的文档默认用 mode="local";确实要云端处理时才用 mode="cloud"。
API 概览
| 接口 | 说明 |
|---|---|
GET /health | 健康检查 |
GET /info | 当前模型、配置和工作台信息 |
POST /tasks | 从上传文件创建任务 |
GET /tasks | 获取历史任务 |
GET /tasks/{id} | 获取任务详情 |
GET /tasks/{id}/pages | 获取任务页面 |
GET /tasks/{id}/export?fmt=xlsx|txt|md|csv|html | 导出任务结果 |
POST /templates/fields | 从 Excel 模板读取字段名 |
POST /agent/tasks/from-path | 从本地路径创建 Agent 任务 |
GET /agent/tasks/{id}/summary | 获取 Agent 任务摘要 |
GET /agent/tasks/{id}/report?fmt=md|json | 获取复核报告 |
运行边界
| 项目 | 当前状态 |
|---|---|
| Windows | 已验证 OCR、任务处理、字段抽取、Excel 导出与 MCP 调用流程 |
| macOS / Linux | 理论上能跑 FastAPI、ONNX Runtime 和 llama.cpp,但启动脚本、模型下载、MCP 调用和 sidecar 还没在真机上完整验证 |
| 本地字段抽取 | 需要约 700 MB 的 MiniCPM5-1B GGUF 模型,用 llama.cpp CPU sidecar |
用 pypdfium2 做渲染和分页 |
致谢
项目基于 andyhuo520/ppocrv6-studio 二次开发,感谢 PaddleOCR、ONNX Runtime、llama.cpp、OpenBMB MiniCPM 和 FastAPI。
链接
- GitHub:BHD110/document-field-agent