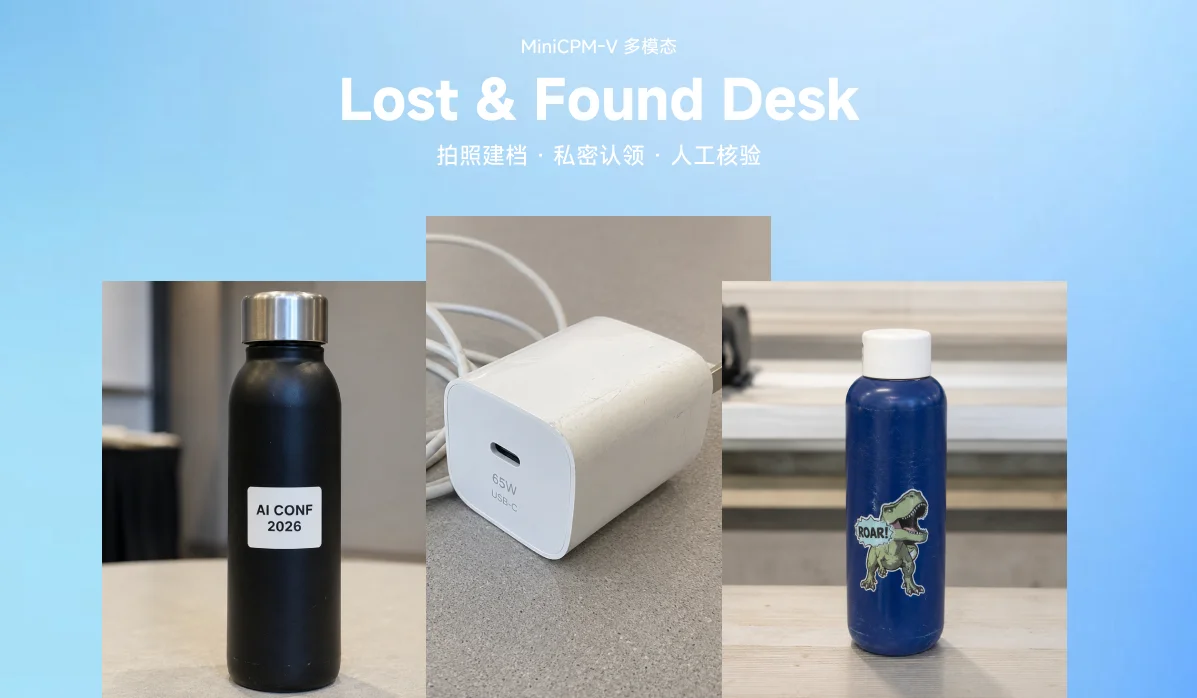
Lost & Found Desk 是一个“描述先行”的失物招领台。MiniCPM-V 4.6 给每件拾获物品写一段可检索的描述,MiniCPM5-1B 负责和失主对话、比对候选、起草消息。物品最后归谁,始终由工作人员线下确认。
问题与范围
会议、健身房、学校、联合办公空间、社区活动,散场后留下的东西都差不多:水杯、充电器、胸牌、包、外套、钥匙、小配饰。事情本身不复杂,但有时效,也涉及隐私。失主可能只记得“我在 B 会议室附近丢了一个黑色水杯”,而工作人员手上有几十件长得差不多的东西要比对。
麻烦主要在两处:
- 信息质量:失主只记得零星细节,工作人员登记时也常常手忙脚乱。
- 信息暴露:系统一旦展示库存照片或候选排序,等于告诉不诚实的认领者该怎么描述。
所以设计要同时满足两件事:库存对工作人员可检索,候选证据不进公开认领流程。项目瞄准中小型活动的库存规模,一名工作人员可以逐件拍照,瓶颈在比对,不在仓库级索引。
设计主张
核心主张是描述先行(caption-first)的登记方式。一张物品照片生成一条物品记录,描述文字串起视觉证据、失主的多语言描述、工作人员审核和后续报告。这样黑客松期间就不用做脆弱的物体分割,工作人员也拿到一份能读、能搜、能改的记录。
系统遵循三条原则:
- 一件物品,一条记录:工作人员逐件拍照,库存和实际归还流程对得上。
- 失主问询不公开:失主描述物品,也可以上传参考照片;库存照片、候选排序和工作人员的判断都留在内部。
- 交接由工作人员把关:模型只帮忙比对和起草消息,身份确认和归还登记都在线下完成。
以下事情应用刻意不做:分割桌面照片、单独跑 OCR 管线、向失主展示物品照片或候选排序、让 AI 决定物品归谁。
用户体验
工作人员:先建一个活动服务台,应用会生成公开的认领链接和工作人员密码。然后逐件上传照片,可以附上拾获地点或备注。MiniCPM-V 写描述;照片里出现能识别身份的文字时,还会给出隐私提示。物品进入该活动的私有库存。
失主:一段简短的对话。助手按类别问缺什么信息,比如颜色、地点、特殊标记,或者请对方补一张照片。失主说不出具体细节之前,问题只停在类别层面。失主通过私密链接继续对话,工作人员也能回复,库存始终不公开。
工作人员审核:两端在这里汇合。工作人员能看到认领摘要、对话记录、失主照片的描述、候选物品、匹配理由,还有一份起草好的安全消息。只有线下确认之后,才登记归还。
整体流程:
- 一张物品照片
- MiniCPM-V 生成描述
- 进入物品库存
- 认领助手与失主对话
- MiniCPM5 把库存打包进提示词做检索
- 只有工作人员看得到的匹配审核
- 起草安全消息
- 线下交接日志
多活动与角色
任何人都能开自己的服务台,拿到一个短活动码和自动生成的工作人员密码。密码只显示一次,存储时只保留加盐 PBKDF2 哈希。每个活动有三个互相隔离的界面,失主和工作人员不会共用一块屏幕:
| 路由 | 界面 |
|---|---|
/ | 首页:创建活动或进入已有活动 |
/e/{event_id} | 公开认领页:开始或继续一份失物报告 |
/e/{event_id}/c/{id} | 某份具体报告(续接链接) |
/e/{event_id}/staff | 工作人员控制台:按活动设密码 |
工作人员控制台有四个标签页:概览、添加物品、认领(收件箱 + 匹配)、报告。
技术实现
应用以 Gradio Server 的形式部署,前端是编译好的 Svelte 界面。后端负责活动、认领、上传、工作人员鉴权、报告和模型服务。在 Hugging Face ZeroGPU 上,跑模型的操作都走 Gradio API 路由,运行时才能正确调度 GPU。
模型栈刻意压得很小,全部低于 Build Small 的 32B 上限:
| 模型 | 作用 |
|---|---|
openbmb/MiniCPM-V-4.6 | 为拾获物品照片和失主参考照片生成描述 |
openbmb/MiniCPM5-1B | 失主问询、工作人员侧比对、安全消息草拟 |
nvidia/llama-nemotron-embed-vl-1b-v2 | 给更大的库存补一路多语言视觉-语言检索信号 |
模型驱动、库存引导的认领对话
真实模式下,英文收集阶段的回复由 MiniCPM5 生成。助手先确认失主说过的内容,再用自己的话问下一个有用的点。模型看不到库存,它只拿到对话内容,以及一个确定性的、感知库存的 planner 在每轮给出的提示。
planner 会看当前描述可能匹配哪些未认领物品,再挑出最能区分这些候选、失主又还没说的属性。于是提问跟着实时库存走,不照固定脚本念,同时不泄露信息(“仍缺少:颜色”这类提示是通用的)。比如库存里有一个黑色水杯和一个蓝色水杯,失主只说了“一个水杯”,下一个问题就是颜色。
围绕 1B 模型设了几道护栏:
- 声称库存状态的回复(如“服务台什么都没有”)会被拒绝
- 和前面回复逐字重复的内容会被拒绝
- 打探库存的问题(“你们有什么?”)不传给模型,直接返回固定的安全拒答和下一个问题
- 繁体中文对话全程用 planner 的原生措辞(MiniCPM5-1B 的中文对话输出不可用:断句,还会漂移成简体)
匹配在对话过程中持续运行,候选结果存在认领记录上供工作人员查看,但会从面向失主的数据里剥掉。
用嵌入扩展匹配:先检索,再重排
把所有描述都塞进匹配提示词,规模一上来就不行了。活动中未认领的库存超过 LFD_MATCH_TOPK(默认 10)时,先按与失主描述的嵌入相似度筛出 top-N,再只让 LLM 给这份短名单排序:
- 登记时,每件物品用 NVIDIA 的多语言视觉-语言模型
nvidia/llama-nemotron-embed-vl-1b-v2编码(照片 + 描述,2048 维),向量按活动存储,不发给前端 - 匹配时,失主的描述作为文本查询嵌进同一个空间。这个空间多语言、跨模态,中文描述也能检索到英文描述的物品
- 小活动(不超过
LFD_MATCH_TOPK)不受影响,也没有嵌入开销
隐私与安全边界
项目把每份认领当成一个私密的能力链接。claim_id 是约 144-bit 的高熵令牌,知道活动码和认领 ID 就能访问这份认领的对话、联系方式和照片,所以续接链接不能公开。工作人员上传的物品照片走仅限工作人员的路由,不放在公开的静态目录里。
认领助手同样有信息边界。它可以问开放式问题,比如物品上有没有贴纸、logo、标签、划痕或其他特殊标记,但在失主自己提到之前,不能带出私有库存里的具体细节。
安全规则:
- 失主不能浏览物品照片,也看不到候选排序
- 应用永远不会说“这是你的”
- 交接必须由工作人员线下确认
- 能识别身份的可见文字不会写进公开 trace
- 已归还的物品从候选检索中移除
- 确认消息只问细节,不确认归属
后端接了 OpenTelemetry(traces、metrics,以及与 trace 关联的日志)。每次模型操作都会记录模式和结果(success / fallback / error),避免悄悄降级。
开发与 Codex
Codex 帮项目从原型走到可提交的版本:对齐官方要求、README 元数据、部署链接、严格的真实模型默认配置、ZeroGPU 启动行为,以及和当前 Spaces 构建器的依赖兼容性。文章草稿和提交说明也是它产出的。它最有价值的地方是“收敛”:让失败状态显式暴露,记下模型和运行时选择,验证公开链接,让 GitHub、Space、演示视频和文章材料保持一致。
本地运行
uv sync
uv run python app.py
打开 http://localhost:7860。在 Mac 上可以用 MPS:
PYTORCH_ENABLE_MPS_FALLBACK=1 LFD_DEVICE=mps uv run python app.py
首次启动会预置一个演示活动:活动码 demo,工作人员密码 demo-pass,控制台在 /e/demo/staff。
写在最后
- 在线体验:Hugging Face Space
- 演示视频:YouTube
- 原文博客:Lost & Found Desk: small models for staff-controlled item return
- 代码:JacobLinCool/Lost-n-Found-Desk
- 作者:Jacob Lin(@JacobLinCool)