MiniCPM5-1B-Agentic-Tooluse-v3 是在 MiniCPM5-1B 上微调出来的 1B 函数调用模型,开放权重,量化成 GGUF,CPU 上就能完全离线跑。不需要 GPU,不调云端 API,数据不出本机。它可以直接用在 llama.cpp、Ollama、LM Studio、koboldcpp 和 text-generation-webui 里。
模型专门学过读工具 schema 和自然语言请求,然后输出函数名正确、参数值正确的结构化调用。LangChain Agent、LlamaIndex 流水线、AutoGen、CrewAI、MCP 工具服务器、ReAct 循环、智能家居助手,靠的都是这个能力。在 300 条留出测试样本上,参数完全正确率 74.67%。
训练方法
大多数小型工具调用模型做到监督微调就停了,这个模型用了两阶段:
- QLoRA 监督微调(SFT):在 ToolACE 的工具调用轨迹上训练。
- GRPO 强化学习:在 SFT 检查点之上接着训,只奖励工具调用里最难的两点,函数名选对,每个参数值都完全正确。
作者自己也说了,和 GPT-4o / Claude 的函数调用比,这个模型牺牲了一部分绝对精度,换回来的是免费、本地运行、数据私密、零调用成本,还能接着微调。
结果
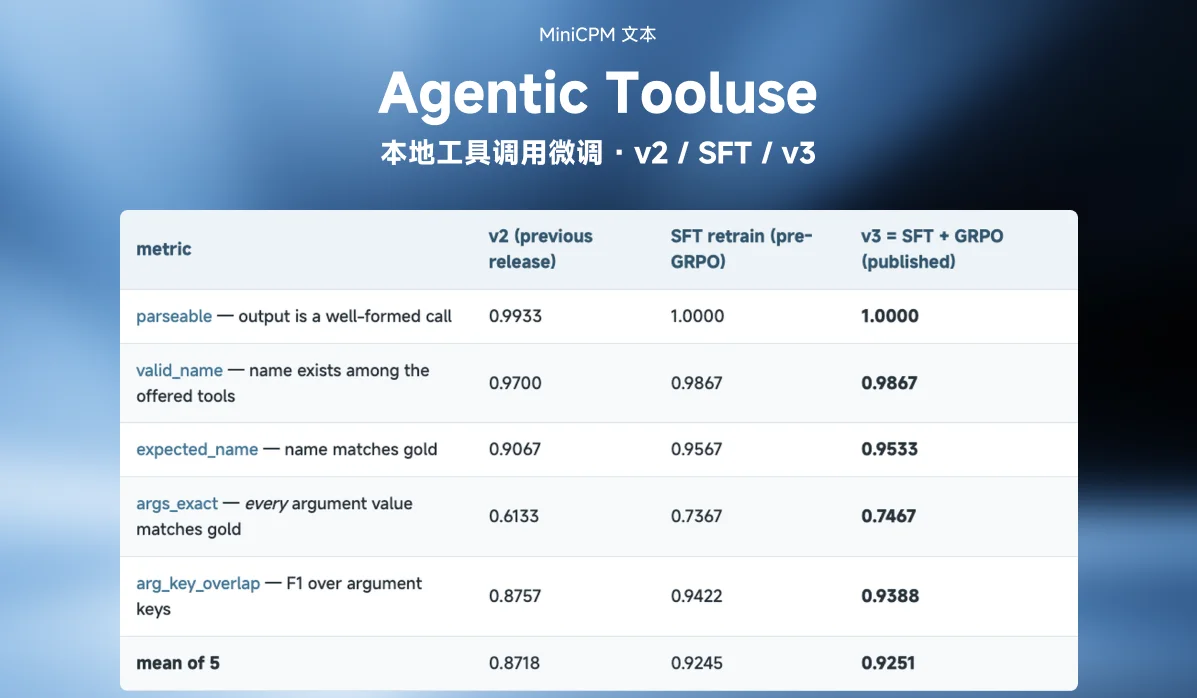
评测用的是 ToolACE 经固定种子打乱后切出的 300 条留出样本。基座列是同一个模型、同一套提示词、不加适配器的结果。发布权重是 SFT + GRPO,保留 SFT 列,是因为下面所有负面结果都拿它做参照。
| 指标 | v2(上一版本) | SFT 重训(GRPO 前) | v3 = SFT + GRPO(发布版) |
|---|---|---|---|
parseable:输出为格式正确的调用 | 0.9933 | 1.0000 | 1.0000 |
valid_name:函数名存在于提供的工具中 | 0.9700 | 0.9867 | 0.9867 |
expected_name:函数名与标准答案一致 | 0.9067 | 0.9567 | 0.9533 |
args_exact:每个参数值都与标准答案一致 | 0.6133 | 0.7367 | 0.7467 |
arg_key_overlap:参数键的 F1 | 0.8757 | 0.9422 | 0.9388 |
| 5 项平均 | 0.8718 | 0.9245 | 0.9251 |
GRPO 在最关键的 args_exact 上提升 +0.0100,代价是 expected_name 和 arg_key_overlap 各掉 0.0034(各一个测试样本)。作者把这个取舍写得很清楚:平均值只涨了 +0.0006,所以这是对最难指标的定向增益,不是全面提升。
完整 8 项指标(留出测试集,n=300)
沿用 v2 的评测格式,用同一套工具和留出集对比 Base、v2、v3:
| 指标 | Base MiniCPM5-1B | v2(上一版本) | v3(本模型) | 变化(v2 → v3) |
|---|---|---|---|---|
| parseable_rate | 0.0133 | 0.9933 | 1.0000 | +0.0067 |
| valid_name_rate | 0.0133 | 0.9700 | 0.9867 | +0.0167 |
| expected_name_rate | 0.0133 | 0.9267 | 0.9533 | +0.0267 |
| args_exact_rate | 0.1500 | 0.6533 | 0.7467 | +0.0934 |
| arg_key_overlap | 0.0033 | 0.7517 | 0.9388 | +0.1871 |
| no_schema_copy_rate | 1.0000 | 1.0000 | 0.9967 | -0.0033 |
| no_repetition_rate | 0.9967 | 1.0000 | 0.3400 | -0.6600 |
| stopped_cleanly_rate | 0.0000 | 0.1500 | 0.0000 | -0.1500 |
注:模型卡里两张表的 v2 数值(expected_name、args_exact、arg_key_overlap)对不上,这里按原文照录。
附加指标含义:
no_schema_copy_rate:模型没有把工具 schema 里的字段描述原样抄进参数值。no_repetition_rate:输出里没有重复的函数调用块,也没有退化的重复短语循环。这是这个模型的已知弱点,它经常在工具调用结束后继续生成填充内容。stopped_cleanly_rate:模型在完整的</function>标签之后立刻停下,没有多余 token。
所以用的时候,请用解析器截出第一个完整的 <function>...</function> 块作为动作边界,不要指望模型自己停下来。
量化版本
| 文件 | 量化 | 大小 | 适用场景 |
|---|---|---|---|
MiniCPM5-1B-Agentic-Tooluse-v3.F16.gguf | F16 | 约 2.02 GB | 最高质量,GPU 或大内存 CPU 推理 |
MiniCPM5-1B-Agentic-Tooluse-v3.Q8_0.gguf | Q8_0 | 约 1.07 GB | 接近无损,推荐大多数用户默认使用 |
MiniCPM5-1B-Agentic-Tooluse-v3.Q4_K_M.gguf | Q4_K_M | 约 656 MB | 最小最快,适合边缘设备、手机和低内存纯 CPU 机器 |
三种量化在 CPU 上都能跑得不错,GPU 只是让它更快。
快速开始
llama.cpp:
./llama-cli -m MiniCPM5-1B-Agentic-Tooluse-v3.Q8_0.gguf -p "Your prompt with tool schema here"
llama-server(OpenAI 兼容 API,适配大多数 Agent 框架):
./llama-server -m MiniCPM5-1B-Agentic-Tooluse-v3.Q4_K_M.gguf --port 8080
Ollama:
# 创建 Modelfile,内容为:
#   FROM ./MiniCPM5-1B-Agentic-Tooluse-v3.Q8_0.gguf
ollama create minicpm5-tooluse-v3 -f Modelfile
ollama run minicpm5-tooluse-v3
LM Studio: 直接在 LM Studio 的搜索 / 下载界面里下载上面任意一个 .gguf 文件。
关闭思考模式
MiniCPM5-1B 内置 <think>...</think> 对话模板。工具调用时务必设 enable_thinking=False。开着思考,模型会把 token 预算花在思考内容上,可能来不及输出完整的函数调用。本页所有评测数据都是关掉思考测的。
prompt = tokenizer.apply_chat_template(
    messages, tools=tools, add_generation_prompt=True,
    enable_thinking=False,
    tokenize=False,
)
适用场景
- 完全本地 / 离线 / 私密的 AI Agent
- 智能家居与语音助手
- 移动端、浏览器扩展和嵌入式 / IoT 工具调用 Agent
- 对成本敏感、调用量大、负担不起大模型 API 费用的后端服务
- LangChain、LlamaIndex、AutoGen、CrewAI 及基于 MCP 的 Agent 栈的函数调用底座
- 小模型 Agent 推理的个人实验与研究
相关仓库
| 格式 | 仓库 |
|---|---|
| v3 LoRA 适配器(PEFT,下载最小,可继续微调) | MiniCPM5-1B-Agentic-Tooluse-QLoRA-v3 |
| v3 合并后全量 FP16(transformers / vLLM / SGLang) | MiniCPM5-1B-Agentic-Tooluse-v3-Merged-FP16 |
| v3 GGUF 量化(llama.cpp / Ollama / LM Studio) | MiniCPM5-1B-Agentic-Tooluse-v3-GGUF |
| v2 LoRA 适配器 | MiniCPM5-1B-Agentic-Tooluse-QLoRA-v2 |
| v2 合并 FP16 | MiniCPM5-1B-Agentic-Tooluse-Merged-FP16 |
| v2 GGUF | MiniCPM5-1B-Agentic-Tooluse-GGUF |
链接
- Hugging Face:MiniCPM5-1B-Agentic-Tooluse-v3-GGUF
- 基座模型:openbmb/MiniCPM5-1B
- 训练数据:Team-ACE/ToolACE