tiny-llm 是一个完全用 Rust 写的极简 LLM 推理引擎,专门给 MiniCPM5-1B 用。作者做它是为了研究大语言模型的基本原理,每一处理解都直接落到代码里,也希望顺带帮到想学的人。它同时也是作者给笔记应用 OpenNote 集成 AI 算法和技术做的准备。项目受 tiny-vllm 启发。
核心特点
- 纯 CPU 推理:不需要 GPU。
- 极简 KV Cache:实现了一个简单的 KV cache,性能最高提升约 6 倍。
- 手写算法与张量运算:算法和张量操作都是手写的,作者从
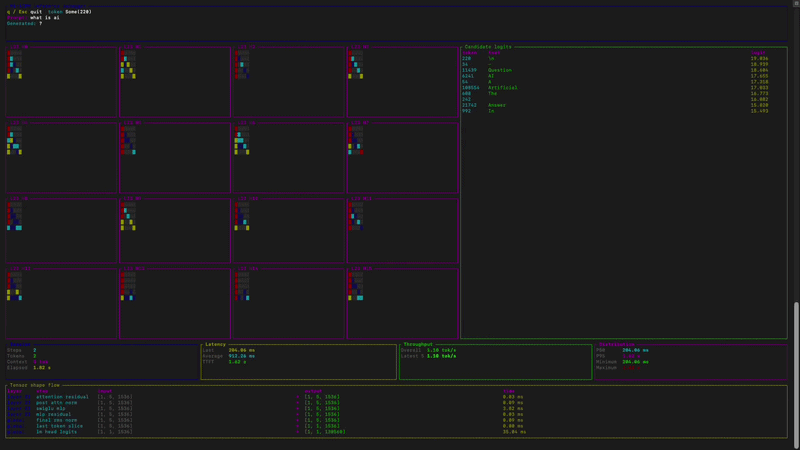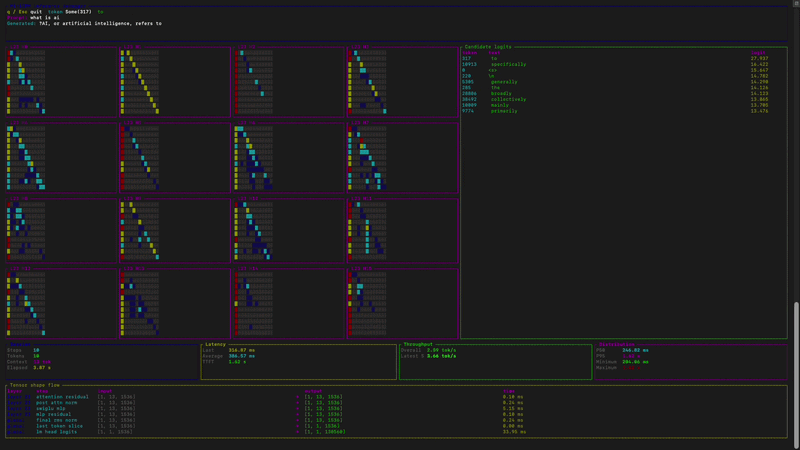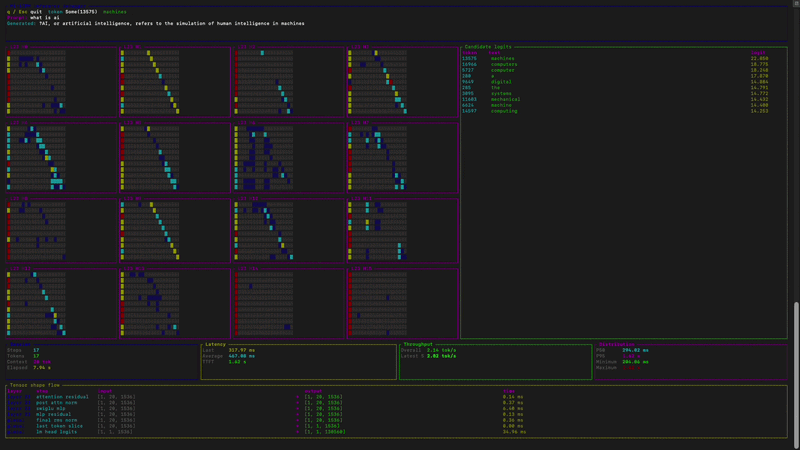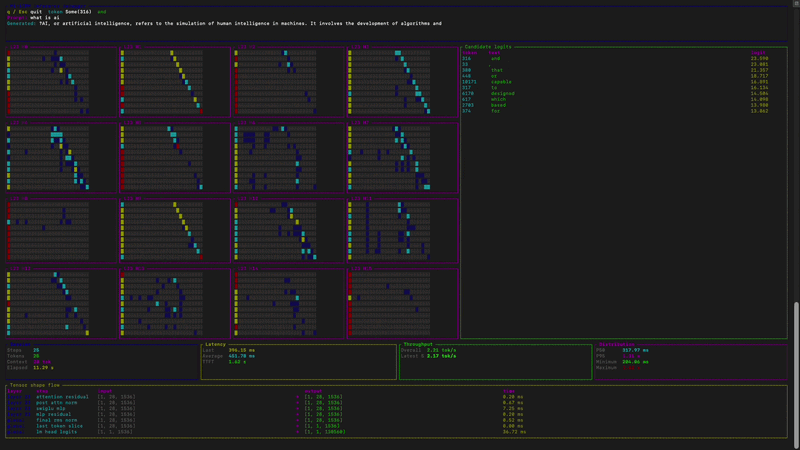
candle的张量实现里学到很多。 - TUI 可视化:实时看模型怎么“思考”,包括注意力热力图和候选 logits。
已实现的组件
| 组件 | 说明 |
|---|---|
| Embedding | 通过 embedding 表查找 Token ID |
| RoPE | 旋转位置编码 |
| Attention | 带 GQA(分组查询注意力)的多头注意力 |
| MLP | SwiGLU 激活函数 |
| Normalization | RMSNorm |
| 残差连接 | 注意力和 MLP 之后的标准跳跃连接 |
目前手写的 TinyTensor 性能和 candle 持平或略快。仓库的 main 分支是手写版本,candle-based-implementation 分支基于 candle,without-kv-cache 分支不带 KV cache。作者还在 OPTIMIZATIONS.md 里记了已完成和试过的优化,在 TUI.md 里说明了 TUI 怎么看。
代码导读
LLM 部分
src/tensors.rs:手写的TinyTensor类型与基础张量运算。src/algorithms.rs:RMSNorm、RoPE、注意力、SwiGLU 等 LLM 运算。src/main.rs:模型加载与predict_next_token_with_kv_cache推理流程。src/simd.rs:张量运算的 SIMD 优化。src/kv_cache.rs:这个极简推理引擎的 KV cache。src/inference.rs:模型推理的主体逻辑。
TUI 部分
src/tui.rs:终端界面、注意力热力图和候选 logits。src/benchmark.rs:实时延迟、吞吐和算子耗时统计。
快速开始
- 从 Hugging Face 下载 MiniCPM5-1B,放到一个目录里(比如
./models/minicpm5-1b/),目录中需要有config.json、model-00000-of-00001.safetensors和tokenizer.json。 - 编译并运行:
Bash
cargo run --release -- ./models/minicpm5-1b "What is artificial intelligence?"
运行中按 q 可以提前退出。
链接
- GitHub:AspadaX/tiny-llm