VoiceMem 是给实时语音智能体用的记忆系统,基于“流式双脑”架构,记忆做得准、带情绪、懂人格,延迟和成本都低。项目的语音合成层可插拔,内置 VoxCPM2 本地 TTS 后端,“听—记—答—说”整条链路可以全部跑在本机。
项目简介
VoiceMem 想补上语音模型缺的最后一块:灵魂。用久了,它真的会越来越懂你。它基于流式双脑架构,记忆服务做到准确、有情绪、懂人格、延迟低,成本也压到最低。仓库会一直保持全部开源。
快速理解 VoiceMem:
- 左脑: 直接管事实信息,记忆只留 Top-3,性能仍能维持在 Mem0 满载时的水平。
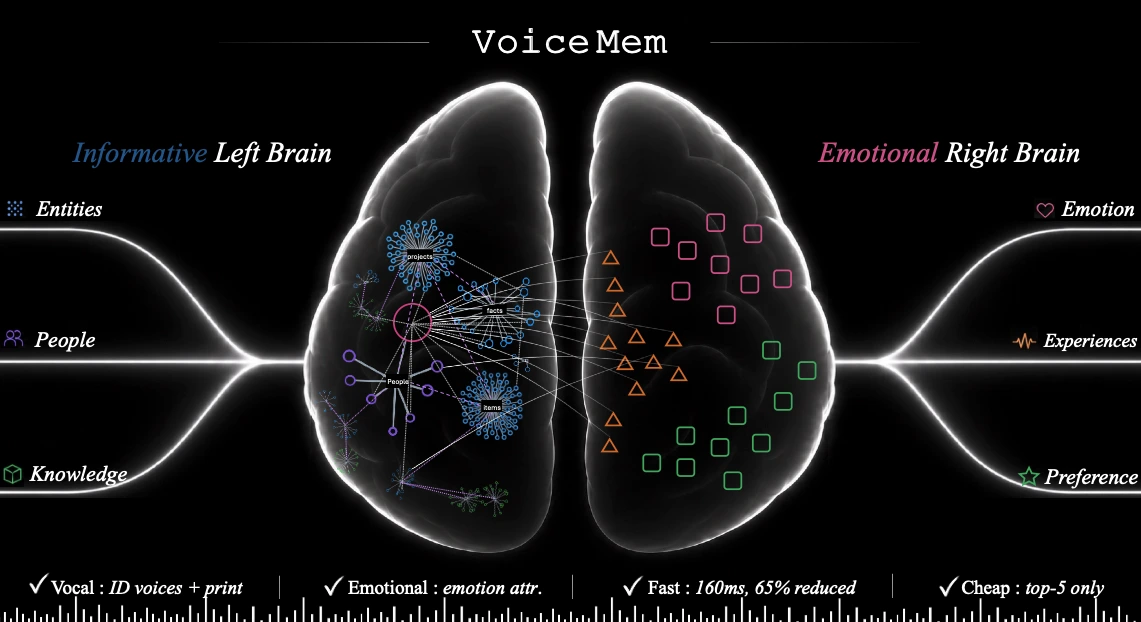
- 右脑: 用长短期情绪归因来管“情商”,节点可以跨实体,也会和左脑的信息一起维护。
- 低延迟: 靠信息压缩、分层存储和流式查询(0–300 ms 投机预取),基本不给链路加延迟。
- 简单实用: 单轮查询大约 300 token;架构完全解耦,所有组件(连底层记忆引擎)都能换。
演示视频:GitHub Demo
快速开始
安装
git clone https://github.com/xzf-thu/VoiceMem.git
cd VoiceMem

# 安装记忆系统(含 ASR / 声纹 / 场景 / 情绪 / 本地 embedding 全套内置组件)
pip install voicemem

# 可选:用我们微调的 Qwen 回复模型
pip install "voicemem[slm]"
下载所需模型
pip install -U huggingface_hub

hf download zhifeixie/VoiceMem_Default_Models_Env --local-dir ./models
作为离线记忆引擎运行
from voicemem import VoiceMem

vm = VoiceMem(
    mode="normal",
    openai_key="api_xxx",
    top_k=5,
)

# 本地模型是懒加载的,先热起来,别让第一次调用去等加载
vm.warmup()

# 存:音频文件
# 内部跑 ASR / 声纹 / 场景 / 情绪感知 / Embedding 抽取
print("入库开始")
vm.ingest(audio="assets/input.wav")  # 我是素食主义者,对坚果过敏。
print("入库结束")

# 查:写入慢是因为要抽事实、打标签、建图;查询走的是纯向量检索,跟写入无关
print("检索开始")
result = vm.search("我的饮食禁忌是什么?")
print("检索结束")

print(result.result_leftbrain, result.result_rightbrain)


# 存:左脑信息文本(无情感)
vm = VoiceMem(
    mode="leftbrain_only",
    openai_key="api_xxx",
    top_k=5,
)

vm.ingest("我是素食主义者,对坚果过敏。")

result = vm.search("我的饮食禁忌是什么?")
以流式方式运行 VoiceMem
把 VoiceMem 的流式接口当成一个持续吃音频的 VAD 接口就行。
下面这段先显式存一条事实,再喂一段问句音频,看记忆怎么在人还没说完时就把答案查好,最后照例走一次入库判断。
import asyncio
import os
from pprint import pprint

import numpy as np
import soundfile as sf

from voicemem import VoiceMem

# 沿用上面那个 vm;单独跑这段就自己建一个
vm = VoiceMem(mode="normal", openai_key=os.environ["OPENAI_API_KEY"], top_k=5)

# 本地模型是懒加载的,先热起来,别让第一块音频去等模型加载
vm.warmup()

# 先存一条事实,等下那个问句才有东西可查
vm.ingest("我是素食主义者,对坚果过敏。")

SPEC_MIN_CHARS = 6
searching = False


def on_partial(text):
    """边说边出字。够长了就说明后台这一刻已经开查了。"""
    global searching
    print(f"\r[partial] {text}", end="", flush=True)
    if not searching and len(text) >= SPEC_MIN_CHARS:
        searching = True
        print("\n[检索开始] 人还没说完,后台已经在查了", flush=True)


async def main():
    # 这段音频里是一个问句:「我的饮食禁忌是什么?」
    audio, sr = sf.read("assets/question.wav", dtype="float32")
    pcm = (np.clip(audio, -1, 1) * 32767).astype(np.int16)

    stream = vm.stream(src_rate=sr, vad_threshold=0.5, on_partial=on_partial)
    step = int(sr * .032)

    for i in range(0, len(pcm), step):
        st = await stream.feed(pcm[i:i + step].tobytes())
        if st.state != "turn_over":
            continue

        # VAD 确认这一轮说完了。记忆早在说话过程中就查好了,这里直接取,不再等
        print("[检索结束]")
        print("转写  ", st.transcript)
        print("左脑  ", st.result_leftbrain)
        print("右脑  ", st.result_rightbrain)
        pprint({k: getattr(st, k) for k in
                ["speaker_id", "speaker_voiceprint", "emotion",
                 "entity", "schema", "text_embedding"]})

        # 每一轮都要走一次入库判断
        print("[入库] LLM 正在判断这句话值不值得入库…", flush=True)
        res = vm.ingest(st.transcript)
        print(f"[入库] 抽出 {res['facts_count']} 条事实 -> {res['memory_ids']}")


asyncio.run(main())
交互式演示
演示代码在仓库里(pip 装的包只有库本身),先确认已经克隆并进入仓库目录。
python web/run.py
然后访问 http://localhost:8787。
Demo 默认把终端输出(含 Python logging 和 Uvicorn 的日志)保存一份到 results/logs/voicemem-时间-PID.log,每行带时间戳和 stdout/stderr 标记。启动时终端会打印实际路径。想指定文件或者临时关掉,这样写:
python web/run.py --log-file results/logs/debug.log
python web/run.py --no-file-log
回复模型的上下文由三部分组成:当前输入、本次会话里还没入库的对话、检索到的记忆。每轮对话先放进内存里的 SessionBuffer;异步写入完成、确认生成了持久记忆,对应的 turn 才从 SessionBuffer 移走。没形成长期记忆的临时对话会一直留到本次会话结束。不同的 Memory Space 和 WebSocket 会话互相隔离。
播放期间的插话分两步处理:VAD 先暂停播放,同时保留音频队列;只有明确的停止指令或稳定的 ASR 文本确认后,才清空队列、取消回复。附和、回声、没有文字的声音和单音节碎片会让播放恢复。候选静音的判定回退和最长等待时间,分别用 BARGE_REJECT_SILENCE_MS、BARGE_CANDIDATE_TIMEOUT_MS 调整。
两种回复模式共用一条以 PCM 样本位置为基准的输出时间轴。浏览器 AudioWorklet 回报实际渲染进度,所以打断时只有已经播出的部分会写进 SessionBuffer。TTS 后端可以返回 TimedAudioChunk 提供文字对齐;普通 PCM 后端按分段音频长度和动态语速估算。
基于流式双脑架构的记忆系统
VoiceMem 没有把所有记忆塞进同一个检索库,而是拆成两块,互相配合:
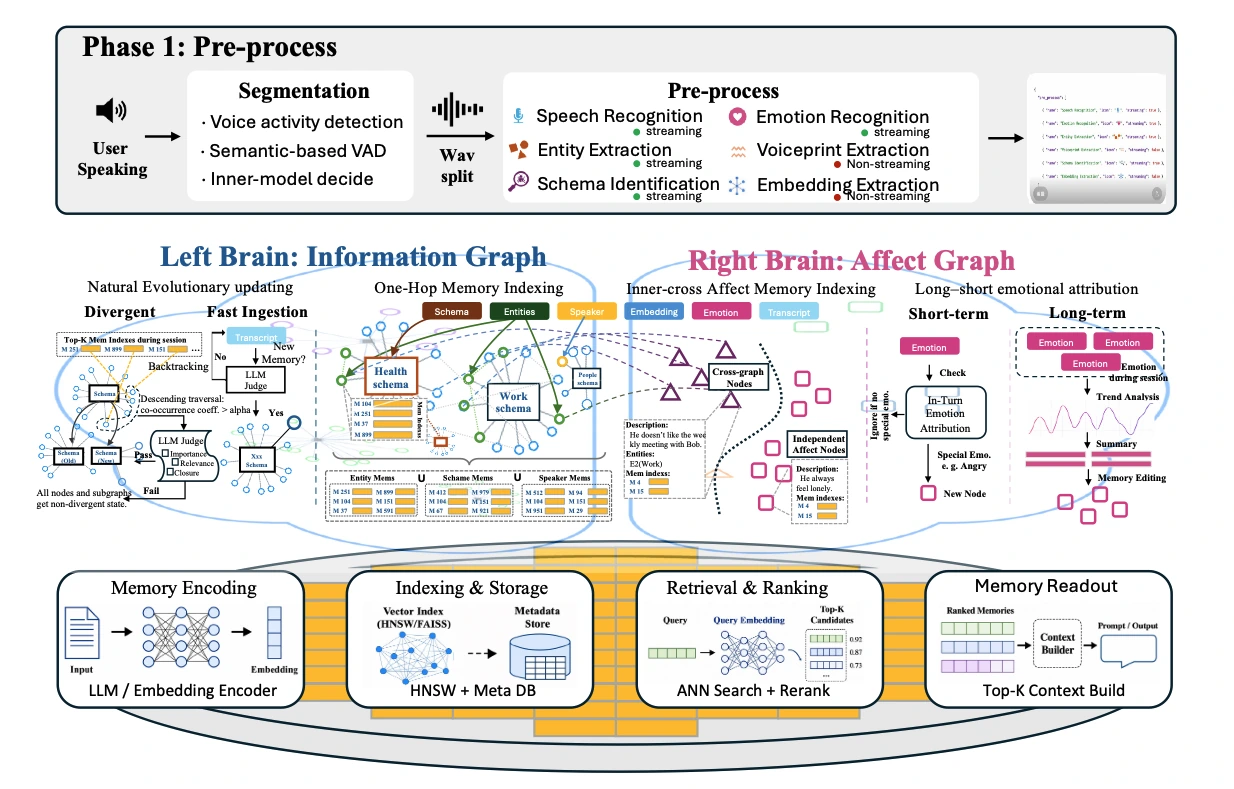
- 左脑用 Schema 和 Entity 组织事实记忆,检索时更准。
- 右脑用独立节点和跨实体节点管人格、情绪和关系。
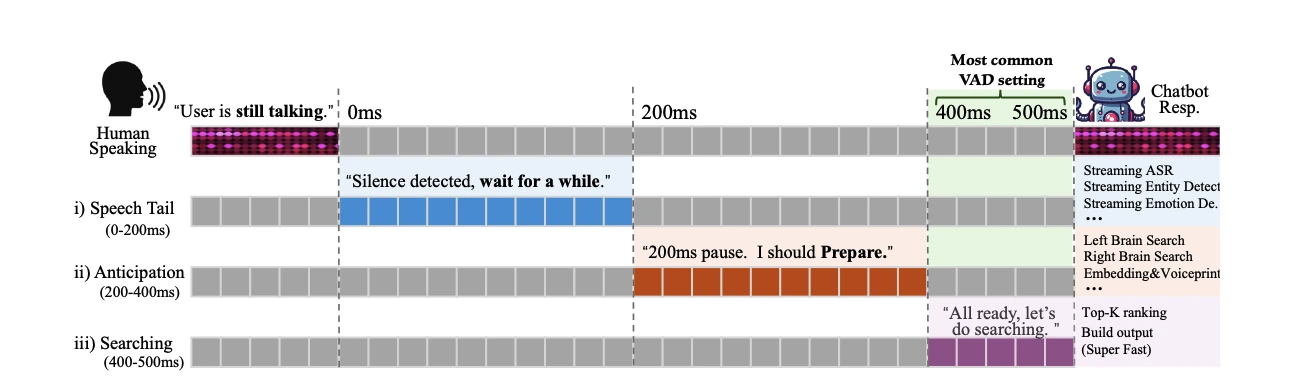
整条流程都是流式的:用户还在说话,VoiceMem 就在做音频分段、语音转写、记忆提取,并把结构化信息写进记忆图。
查询时先路由、再排序,只把 Top-K 条记忆注入模型上下文,相关信息留住了,上下文长度也压得住。
主要特性
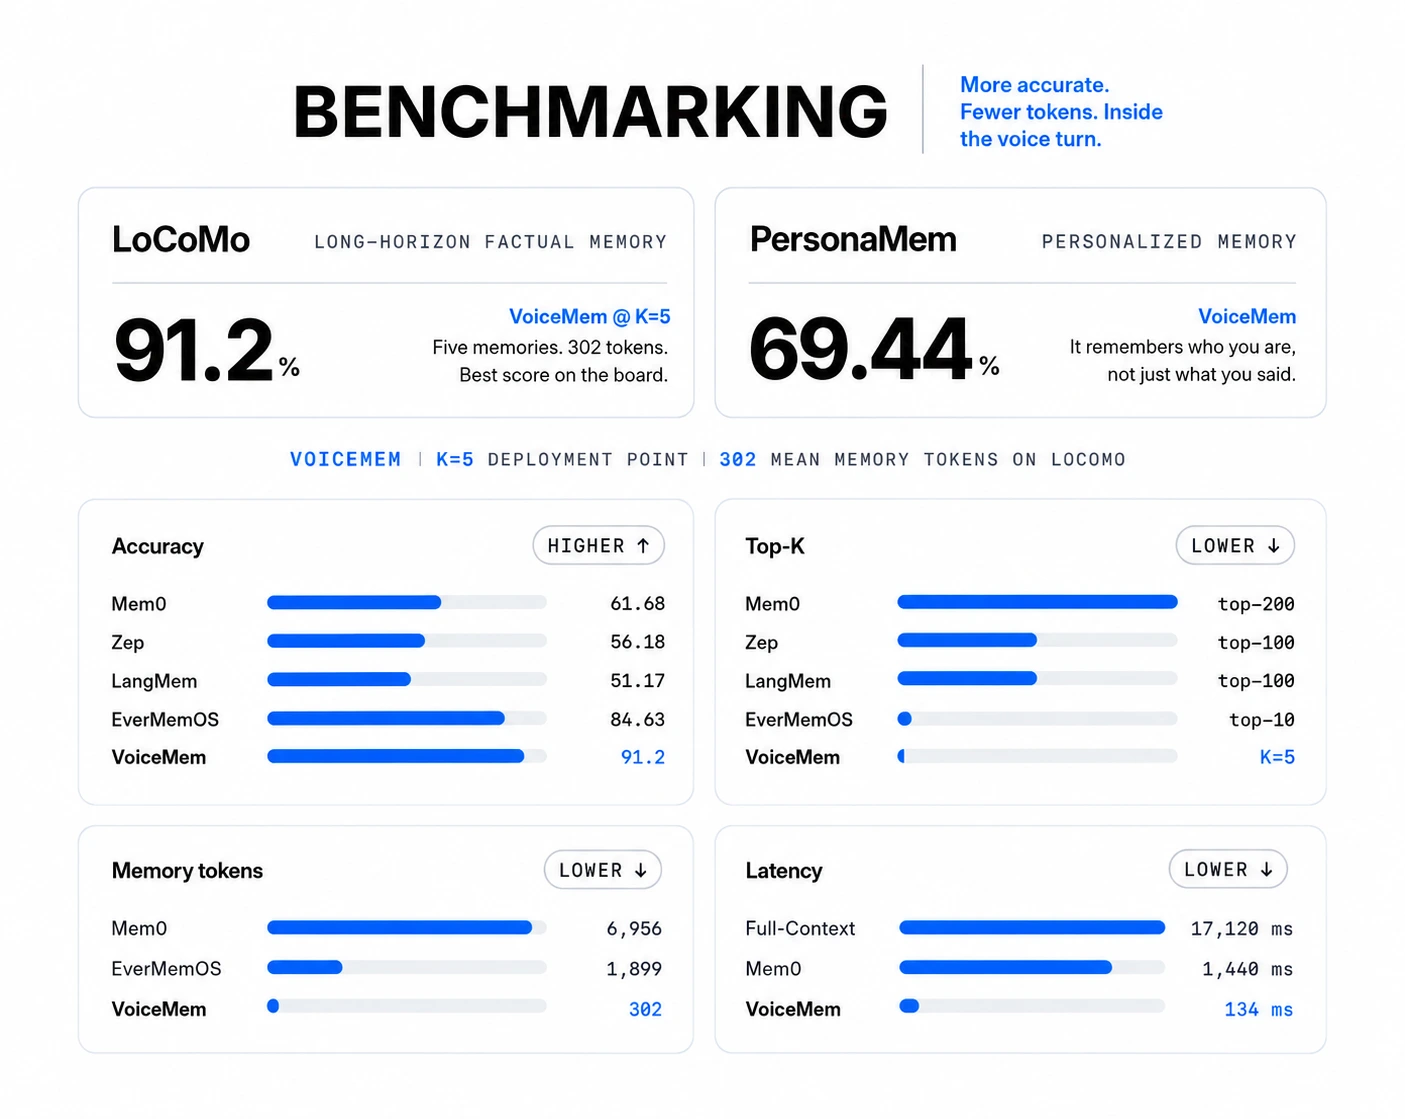
- 准确:LoCoMo 上 91.2%,Mem0 是 61.68%,而且只用了 Top-5 条记忆。
- 有情感、懂人格:不只记住用户说过什么,还记得用户是谁、有什么感受。PersonaMem 上 69.44%。
- 多模态:能从真实世界的音频里记住语音、说话人、声音事件、多人对话和音乐。
- 低延迟:响应 134 ms,Mem0 是 1,440 ms,还支持在语音轮次内部做流式检索。
- 低 Token 消耗:每次只用 430 个记忆 token,Mem0 是 6,956,EverMemOS 是 1,899。
使用 VoxCPM2 作为本地语音合成
VoiceMem v0.0.2 开放了可插拔的语音合成层。README 正文里没单独写,但仓库代码(voicemem/tts.py)内置了 VoxCPMTTS 后端,默认加载 openbmb/VoxCPM2。装上 voxcpm,改一下配置就能用:
pip install voxcpm
{"tts": {"provider": "voxcpm"}}
仓库示例 examples/04_all_local_l40s.py 演示了单张 L40S 上的全本地方案:vLLM 跑 Qwen3-8B 当回复模型,VoxCPM2 负责合成语音(显存约 5G,首帧 0.5s 出声)。
VoiceMem 模型系列
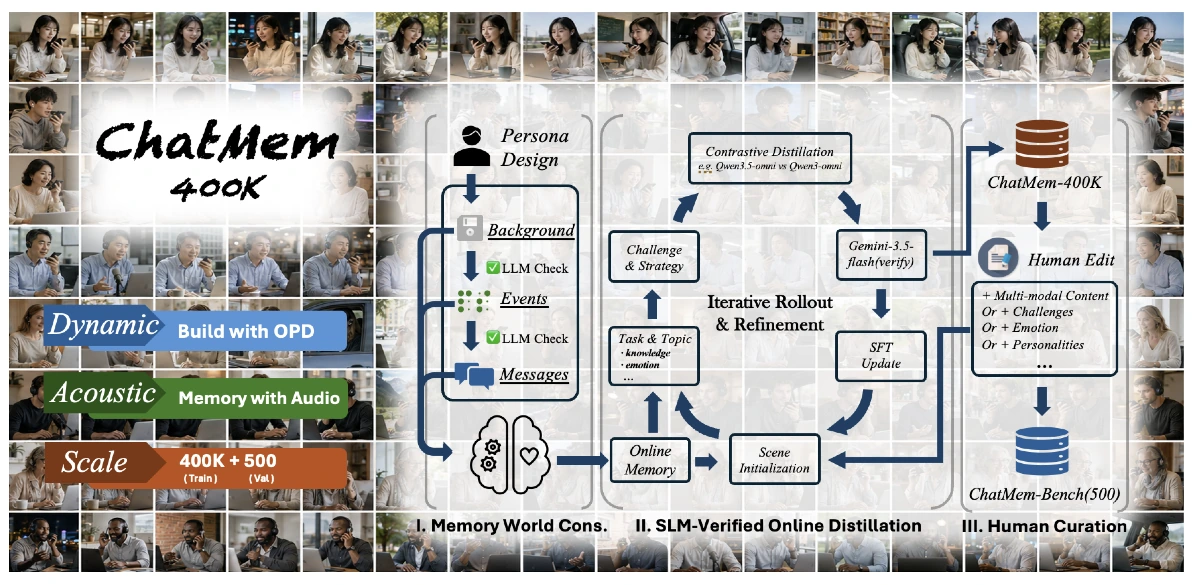
我们用三阶段 OPD 流程训出了 ChatMem-400K:
- Memory-world construction
- SLM-validated online on-policy distillation(OPD)
- Human refinement
同一套流程加上人工编辑,得到 ChatMem-Bench,用来评测语音模型能不能在长期交互中积累出对用户的理解。
VoiceMem 家族开源模型包括 Qwen2.5-Omni、Qwen3-Omni 和 Step-Audio2-Mini。这些模型可以在对话时接收并理解 VoiceMem 提供的记忆信息。
使用 VoiceMem 定制你的语音智能体
把 VoiceMem 接到自己的语音模型上,就能做出带长期记忆的实时语音智能体。流程是:
麦克风 → VoiceMem 监听语音并提前检索相关记忆 → 你的模型读取这些记忆并生成回答
export OPENAI_API_KEY=sk-...
# 仅在写入记忆时用于事实信息提取。
# 记忆检索完全在本地运行。

python examples/03_simple_agent_with_voicemem_memory.py
换成自己的模型,只要把生成那一步换掉,记忆那半边一行都不用动。
def my_reply(text, memory_context):        # 同步函数也可以,会自动丢线程
    return my_model.generate(system=memory_context, user=text)

vm = VoiceMem(reply=my_reply)
模型微调
VoiceMem 放出了完整的微调代码,可以训自己的 VoiceMem Model Family Adapter。默认训练配置和发布 checkpoint-3318 时用的一样,默认参数下跑下面这条命令,能复现同一个 Adapter:
pip install ms-swift==4.5.2 bitsandbytes

python finetune/train.py --data data/train.jsonl
训练数据格式、GPU 显存要求,以及怎么换基础模型,见仓库里的 finetune/README.md。
评测
评测流程完全开源,可以复现。
跑 Benchmark 只要一条命令:
export OPENAI_API_KEY=sk-...

# 建议先跑仓库里自带的小示例,
# 确认环境和配置没问题。
# 2 个对话,5 个问题。
python evaluation/run.py \
    --dataset locomo \
    --data evaluation/examples/locomo_sample.json

# 再跑完整数据集。
python evaluation/run.py \
    --dataset locomo \
    --data data/locomo.json
示例结果:
LoCoMo: 10 conversations · 152 questions

Score: 139/152 = 91.4%

  multi_hop     88.2%
  temporal      85.7%
  single_hop    95.1%

Median retrieval latency: 12 ms
Median retrieved memory: 298 tokens
跑完整评测之前,可以先加 --inspect 看看数据集解析对不对。这个模式不调模型,也不产生 API 费用:
python evaluation/run.py \
    --dataset locomo \
    --data data/locomo.json \
    --inspect
评测时,回答模型只拿得到检索出来的记忆,拿不到原始对话历史。要是把整段对话直接塞给模型,测的就是模型的阅读理解,不是记忆系统本身。加一个新 Benchmark 只要多一个文件、实现两个函数,细节见 evaluation/README.md。
引用
@misc{2608.26005,
  author = {Zhifei Xie and Jiaqi Lang and Ze An and Yifan Zhao and Dongchao Yang and Kai Li and Ziyang Ma and Mingbao Lin and Chunyan Miao and Shuicheng Yan},
  title = {{V}oice{M}em: {S}treaming {D}ual-{B}rain {M}emory for {R}eal-{T}ime {I}nteraction},
  year = {2026},
  eprint = {2608.26005},
  note = {arXiv:2608.26005v1}
}
致谢
VoiceMem 用到了这些开源项目:mem0(向量记忆引擎)、FunASR(基于 paraformer-zh-streaming 的流式 ASR)、sherpa-onnx(Silero VAD、3D-Speaker 说话人验证及备用流式 ASR)、intfloat/multilingual-e5(本地 Embedding 和 Slot 分类)。
许可证:Apache License 2.0。
相关链接
- GitHub:xzf-thu/VoiceMem
- 项目主页:xzf-thu.github.io/VoiceMem
- 技术报告:arXiv 2608.26005
- 模型与数据:VoiceMem Utils · VoiceMem Model Families · ChatMem-400K
感谢作者 Zhifei Xie(@xzf-thu)及团队的开源分享!