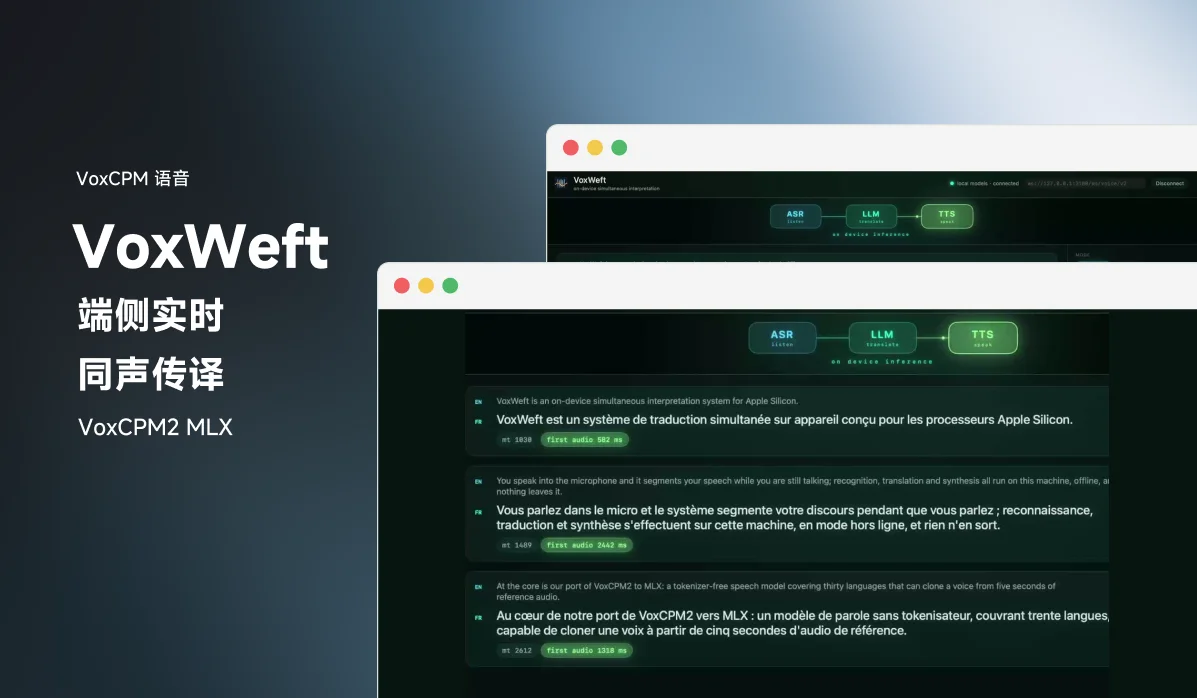
VoxWeft 是一个跑在 Apple Silicon 上的端侧同声传译系统:语音进去,翻译后的语音流式出来,全程不出本机。核心是作者把 VoxCPM2 移植到了 MLX。
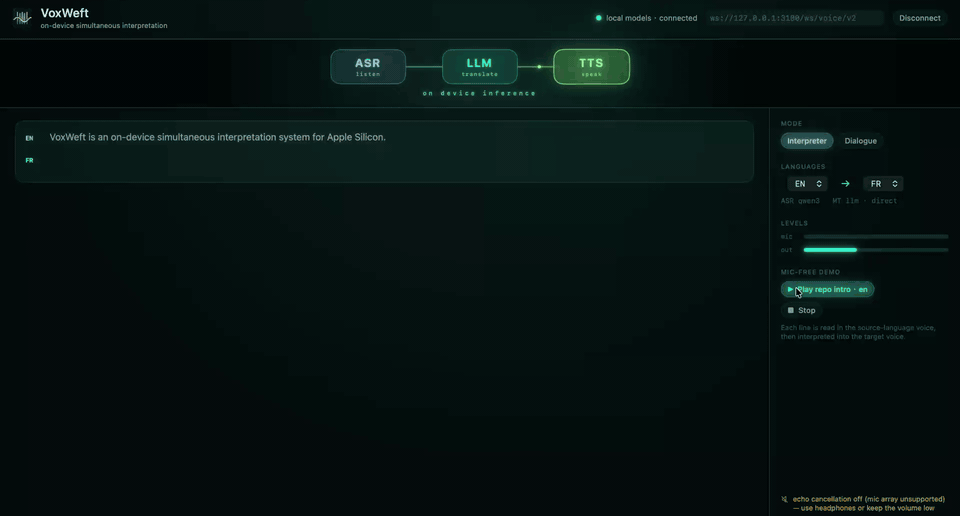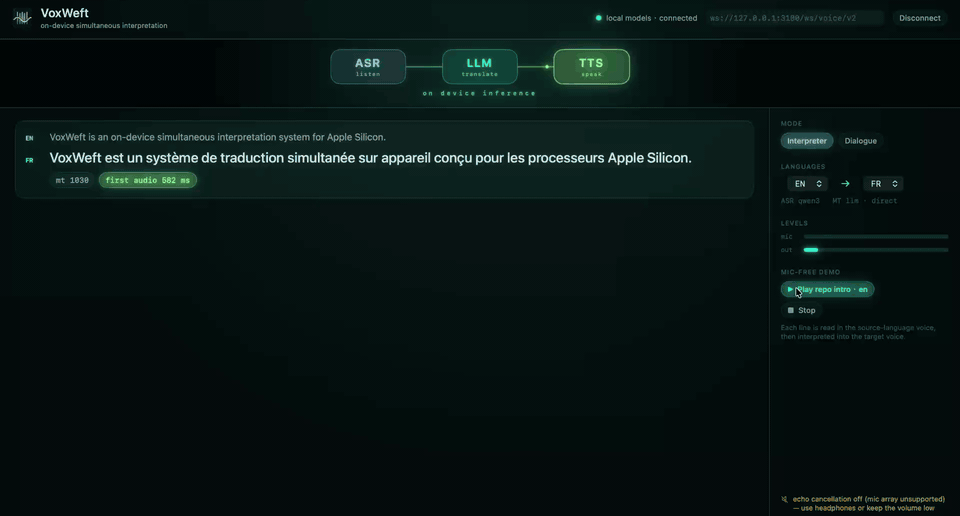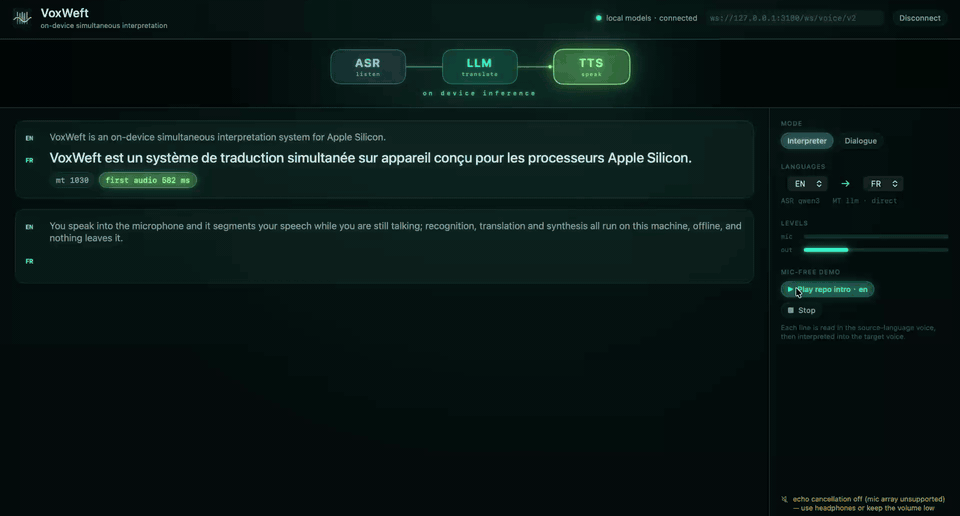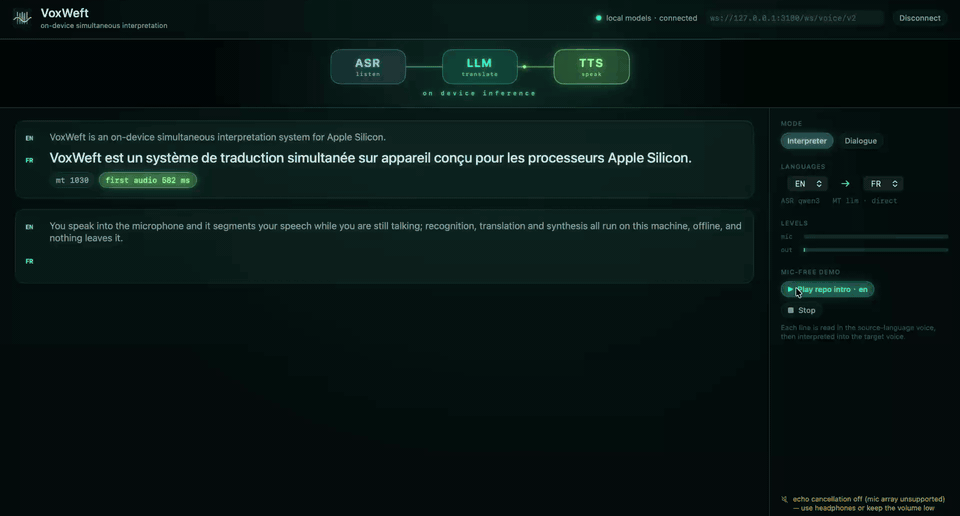
上图是 MacBook(M5)上的英语 → 法语演示,不用麦克风:每一句先用设计好的源语音色朗读,再同传成目标语音色;仪表盘会高亮当前正在工作的模型。
项目概览
项目的核心,是把 VoxCPM2(一个覆盖 30 种语言、无 tokenizer 的 2B TTS 模型)移植到 MLX:
- LM 权重零转换,AudioVAE 逐位一致(bit-exact)
- 有状态的流式解码器:首包音频在 M5 上约 170 ms,基础款 M2 上约 300 ms,M3 Ultra 上约 150 ms
- 约 5 秒参考音频就能克隆声音
- 支持 4-bit 量化
- 每个模块都跟官方 PyTorch 实现对过,结果一致
在它之上是一个运行时:说话人还没讲完,麦克风输入就已经被切分、翻译、朗读出来。再加一个 macOS 外壳,实时显示哪个模型在干活、每一步花了多久。
项目有意不发 PyPI 或 npm 包,源码就是分发方式。克隆下来,用可编辑模式装上,再把你的 Agent 指到这个目录就行:
git clone https://github.com/HenryZ838978/VoxWeft && cd VoxWeft
python -m venv .venv && source .venv/bin/activate
pip install -e .              # L1: TTS, clone, `voxweft say`
pip install -e ".[mcp]"       # + MCP server for agent harnesses
pip install -e ".[runtime]"   # + segmenter, ASR/LLM adapters, WebSocket server
如果你是替用户搭环境的 Agent(Claude Code、Codex、Cursor 等),去读 docs/AGENT-SETUP.md,那份文档就是写给你的。
三层架构,一个仓库
              ┌──────────────────────────────────────────────────────┐
   L3         │  CLI  ·  MCP server  ·  macOS shell (app/)           │  wrappers — thin, replaceable
              └──────────────────────────────────────────────────────┘
              ┌──────────────────────────────────────────────────────┐
   L2         │  segmenter / endpointing  →  ASR  →  MT | LLM        │  runtime — MLX only,
   runtime    │  language router · orchestrator · /ws/voice/v2       │  models are yours to pick
              └──────────────────────────────────────────────────────┘
              ┌──────────────────────────────────────────────────────┐
   L1         │  VoxCPM2 on MLX: streaming VAE · clone · 4-bit       │  core — ours end to end
   core       │  `voxweft say`                                       │
              └──────────────────────────────────────────────────────┘
L1 是这个仓库的立身之本。 功能完整,过了 golden 对齐测试,本身就能用:任何 Agent 框架只要一段 JSON 配置,就能通过 MCP server 拿到本地语音能力。
L2 是乐高积木。 ASR 和 LLM 各给了两个默认选项,也都有对应适配器,但权重得自己下。所有东西都跑在 MLX 上;项目不支持 Ollama 之类的 CPU 优先运行时,它们在这类硬件上达不到延迟预算。
L3 怎么合适怎么来。 里面有 CLI、MCP,以及 app/ 里约 700 行的 SwiftUI 外壳:按住说话、实时的 ASR → LLM → TTS 仪表盘、每轮延迟标签,还有一个不用麦克风的演示模式。设计上就是可替换的。
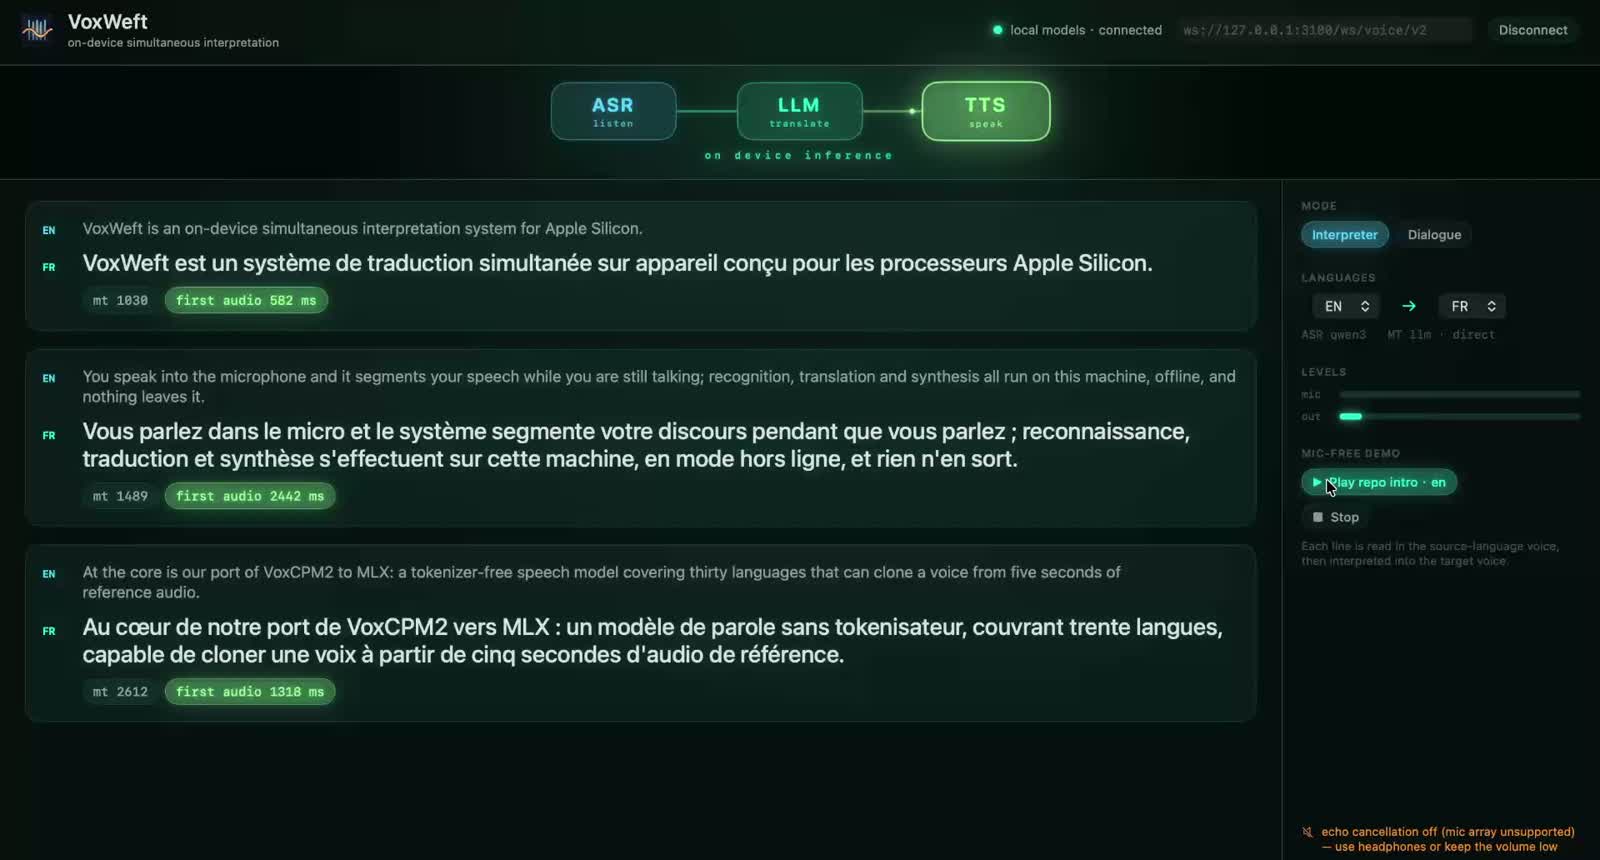
每张卡片对应一个片段:源语句、译文和耗时。mt 是 LLM 花的时间,first audio 是从文本送进 VoxCPM2,到扬声器播出第一个采样点的时间。
快速开始:L1
export VOXCPM2_MODEL=~/.voxweft/models/VoxCPM2      # see docs/MODELS.md
python scripts/convert_vae.py $VOXCPM2_MODEL        # one-time, audiovae.pth → MLX

voxweft say "你好,欢迎使用语音合成服务。" --play
voxweft say "Guten Morgen, wie geht es Ihnen?" --stream -o out.wav   # prints first-audio ms
voxweft say "ສະບາຍດີທຸກໆທ່ານ" --ref my_voice.wav -o lao.wav          # clone from ~5 s
from voxweft.core import VoxCPM2Pipeline

pipe = VoxCPM2Pipeline(model_dir, inference_timesteps=6, quantize_lm=4)
for chunk, i in pipe.generate_streaming("text", ref_latents=pipe.encode_reference(ref_16k)):
    play(chunk)                       # float32 @ 48 kHz
通过 MCP 接进 Claude Code / Codex / Cursor 这类支持 MCP 的工具:配置指向克隆目录里的 venv 就行,不用全局安装。mcp Python SDK 1.x 和 2.x 都兼容(2.x 改了 FastMCP 的名字,server 会自动适配):
{"mcpServers": {"voxweft": {
    "command": "/path/to/VoxWeft/.venv/bin/voxweft", "args": ["mcp"],
    "env": {"VOXCPM2_MODEL": "/path/to/models/VoxCPM2"}}}}
快速开始:L2 运行时
运行时由两个进程组成。bridge 拿着 TTS 和 ASR 的 MLX 模型,每个模型固定在自己的线程上(MLX 的 GPU stream 跟线程绑定,细节在 devlog 里)。server 负责切分、路由、进程内的 MLX LLM/MT,以及 WebSocket。
pip install -e ".[runtime]"
export VOXWEFT_MODEL_DIR=~/.voxweft/models         # VoxCPM2/, Qwen3-ASR-1.7B-8bit/, <llm>/
export VOXWEFT_LLM_DIR=$VOXWEFT_MODEL_DIR/Qwen3-4B-Instruct-2507-4bit
export VOXWEFT_VOICE_DIR=samples/voices          # <lang>_tgt.wav → the interpreter's voice per target language

voxweft bridge --port 8133 &      # wait for GET /ready → 200
voxweft serve  --port 3100        # ws://localhost:3100/ws/voice/v2
协议写在 voxweft/runtime/server.py 的 docstring 里:客户端发 session_config、ptt_start、int16 PCM 帧、ptt_end;服务端回 asr、translation、audio_start + 48 kHz PCM 分块 + audio_end、turn_end,要是一帧都没切出片段,还会带一个 no_speech,附上实测音量。
默认模型
| 槽位 | 默认 | 备选 | 许可证 |
|---|---|---|---|
| TTS | VoxCPM2(4-bit) | — | Apache-2.0 |
| ASR | Qwen3-ASR-1.7B 8-bit,基于 mlx-audio(zh/en/vi/th/id/ms 及另外 20 种语言)。2.5 GB,RTF 0.11,测试集上转写结果跟 bf16 完全一致 | bf16(4.1 GB)· 0.6B | Apache-2.0 |
| ASR(lo/km/my) | whisper-large-v3-turbo(MLX),自动路由;质量较差(老挝语常被识别成泰文字母) | 基于 sherpa-onnx 的 Omnilingual-ASR CTC 是更好的开源选项(适配器还没写) | MIT |
| LLM / MT | Qwen3-4B-Instruct(mlx-lm) | Qwen3-8B · Hy-MT2-1.8B | Apache-2.0 |
| MT 兜底 | NLLB-200-1.3B | — | CC-BY-NC-4.0,需手动开启,仅限研究 |
仓库里不带任何模型权重,下载说明在 docs/MODELS.md(HF 慢的话可以用 ModelScope 镜像)。
运行时做了哪些“下载模型”做不到的事
- 边说边切。 逐帧 RMS 配自适应底噪,0.45 s 静音规则;6 s 之后在第一个 ≥100 ms 的低谷处强制切分(9 s 硬切);还有一个 carry 缓冲区,让 0.4 s 的 “So,” 接到下一个片段上,而不是悄悄丢掉。学习式的轮次结束检测(SmartTurn v3)已经接进来了,但默认关闭:作者实测它对同传是负收益,原因也写清楚了。
- 按语言对直接路由,不绕中转语言。 任何语言对都直接过 LLM,es→ms、de→vi、ja→fr 都是一跳,绝不经过中文或英文转一手。只有低资源的目标语言(lo/km/my)才交给专用 MT,因为 4B 的对话模型被要求书写这些语言时,会猜错文字系统。
- 并发之下让 MLX 活着。 线程固定的执行器、不在
yield之间握锁、预热走跟真实请求一样的代码路径。每一条背后都是一次真踩过的崩溃。 - 打断就是真打断。
ptt_start或 Stop 会切断客户端流、取消正在跑的轮次,并关掉通往 TTS 的 socket,让 bridge 在一次 patch 之内停止合成。M2 上大约 1 s 就能开始下一句,而不是在作废的句子后面排 20 s 的队。 - 失败要喊出来。 按下按键却没切出片段时,会返回
no_speech {peak_rms, threshold, too_quiet},“什么都没说”和“声音太小”当场就能分清,不用去翻服务端日志。
性能数据
测试机是基础款 M2 16 GB,跑的时候没开别的程序(飞书、VPN 辅助程序和零散的 Python 进程都提前关了,它们常驻时同一条流水线会慢 3–4 倍,空闲内存只剩约 100 MB)。M3 Ultra 的数据来自 stage 构建。
| 单阶段测试 | M2 16 GB | M5 16 GB(MacBook) | M3 Ultra |
|---|---|---|---|
| VoxCPM2 4-bit TTS,首包音频(预热后) | 303 ms | 169 ms | 124–168 ms |
| VoxCPM2 4-bit TTS,RTF | 1.47 | 0.94(同时运行完整桌面会话) | ≈ 0.2 |
| Qwen3-ASR-1.7B 8-bit,10 s 音频 | 1.2 s(RTF 0.11)· bf16:RTF 0.24 | — | — |
| Qwen3-4B 4-bit,一句 zh→en | 首 token 405 ms · 16 tok 用时 870 ms | — | — |
| 三个模型常驻内存 | 6.7 GB(bf16 ASR:8.5) | 6.7 GB | — |
端到端,/ws/voice/v2 | M2 16 GB | M5 16 GB | M3 Ultra |
|---|---|---|---|
| 文本 → LLM → 首包译文音频,逐句(上方演示,en→fr) | — | 0.58 / 2.4 / 1.3 s | — |
| 片段提交 → 首包译文音频(worker 空闲) | ≈ 2.5 s | — | ≈ 0.85 s |
| 每片段总耗时,输出 5 s 语音 | ≈ 7 s | ≈ 5 s | ≈ 1.5 s |
| TTS 经 ASR 回环的 CER,仓库简介 zh / en | 3.4% / 7.8% | ||
| 切分器,手机麦克风,ASR CER 固定阈值→自适应阈值 | 16.3% → 10% |
在 M2 上,瓶颈是 TTS:RTF 1.47 意味着 5 s 的语音要生成 7 s,串行 worker 会让下一个片段干等。ASR 和 LLM 加起来约 1.5 s,跟得上实时;TTS 是这块芯片的天花板(上游实测的 RTF 也一样)。到了 M3 Ultra,三者都快于实时,流水线能顺畅地流式跑。
项目不发布 BLEU。翻译质量取决于你接的模型;这个仓库负责的是流水线在传递过程中不丢质量:TTS 经 ASR 回环还能听懂、首包音频延迟、RTF。相关脚本在 bench/ 里。
音色
仓库不带任何参考录音,演示用的音色都是设计出来的:用 VoxCPM2 的描述模式((A mature man in his fifties, calm broadcaster voice, Castilian Spanish)…)生成候选,再由人为每种语言和角色挑一个,挑中的音色就成了 bridge 在该目标语言下使用的克隆参考。约定是这样的:源语说话人是成熟男声,译员是年轻女声,所有语言共用同一段文本,也就是仓库自己那两句简介。
samples/voices/ 里带了 22 个音色(11 种语言 × src/tgt),登记在 voxweft.db 中。这是一个单独的 SQLite 文件,充当运行时的默认配置:音色、各语言用的简介文本,还有演示用的路由矩阵。bridge 启动时会把音色全部读进来,不用额外配置。python -m voxweft.db show 可以打印里面的内容。
想设计自己的音色:
python scripts/design_voices.py --langs de,fr --n 3 --out /tmp/cands
# listen, mark "pick": true in /tmp/cands/manifest.json, then
python scripts/pick_voices.py /tmp/cands && cp /tmp/cands/*_{src,tgt}.wav samples/voices/
python -m voxweft.db build
samples/voices/<lang>_src.wav 同时也是演示时的麦克风替身:scripts/mock_interpret.py --wav samples/voices/es_src.wav --src es --tgt ms 会按实时速度把它送进真实的 PTT 路径,切分器、ASR、MT、TTS 一个不少,全程不用麦克风。
开发日志也是产品的一部分
docs/DEVLOG.md 记下了每一次翻车、哪里判断错了,以及代价多少:MLX stream 的线程绑定、在 async yield 之间握锁把进程冻住、名不副实的 temperature、模型老老实实念出来的文本、SwiftPM 2.8 s 就报“构建完成”其实压根没编译、SwiftUI Button 在 macOS 26 上崩溃、让同传变差的学习型端点检测器。一个能跑的 demo,哪个模型都能重新生成;这份清单不能。
目录结构
voxweft/
  core/        model.py · vae.py · generate.py · cli.py          L1
  runtime/     segmenter · router · orchestrator · translator     L2
               bridge.py (TTS+ASR HTTP) · server.py (WebSocket)
  wrappers/    mcp_server.py                                      L3
app/           SwiftUI macOS shell (hold-to-talk, latency chips, demo)  L3
tests/         golden alignment (needs model) · segmenter · router · orchestrator (no model)
bench/         asr / mt / tts benches + ASR-round-trip judge
scripts/       convert_vae.py · probe_{onset,stream,clone,perf}.py · mock_interpret.py
docs/          DEVLOG.md · TTS-FINDINGS.md · ARCHITECTURE.md · HARDWARE.md · MODELS.md
samples/       zero-shot zh / lo output, round-trip verified
致谢
- OpenBMB/VoxCPM:模型本身。事实证明,无 tokenizer 的设计对低资源语言恰好是对的,因为不存在会掉到分布外的 RVQ 码本。
- ml-explore/mlx:让移植只花了一天、调试花了两周的数组框架。
- Qwen3-ASR、mlx-lm、mlx-audio、pipecat SmartTurn:那些乐高积木。
项目采用 Apache-2.0 许可证。
相关链接
- GitHub:HenryZ838978/VoxWeft
- 完整演示视频:docs/media/showcase.mp4(70 s,1.6 MB)
- 作者:HenryZ838978