Gander 是一个开源的全双工交互模型,以 MiniCPM-o 4.5 为基座,外面套了一层异步智能体循环。自然语音对话、持续的多模态感知和长程任务执行被放进同一场实时交互里:任务跑着的时候,你可以随时说话、打断、换方向,也可以把屏幕共享给它看。
概览
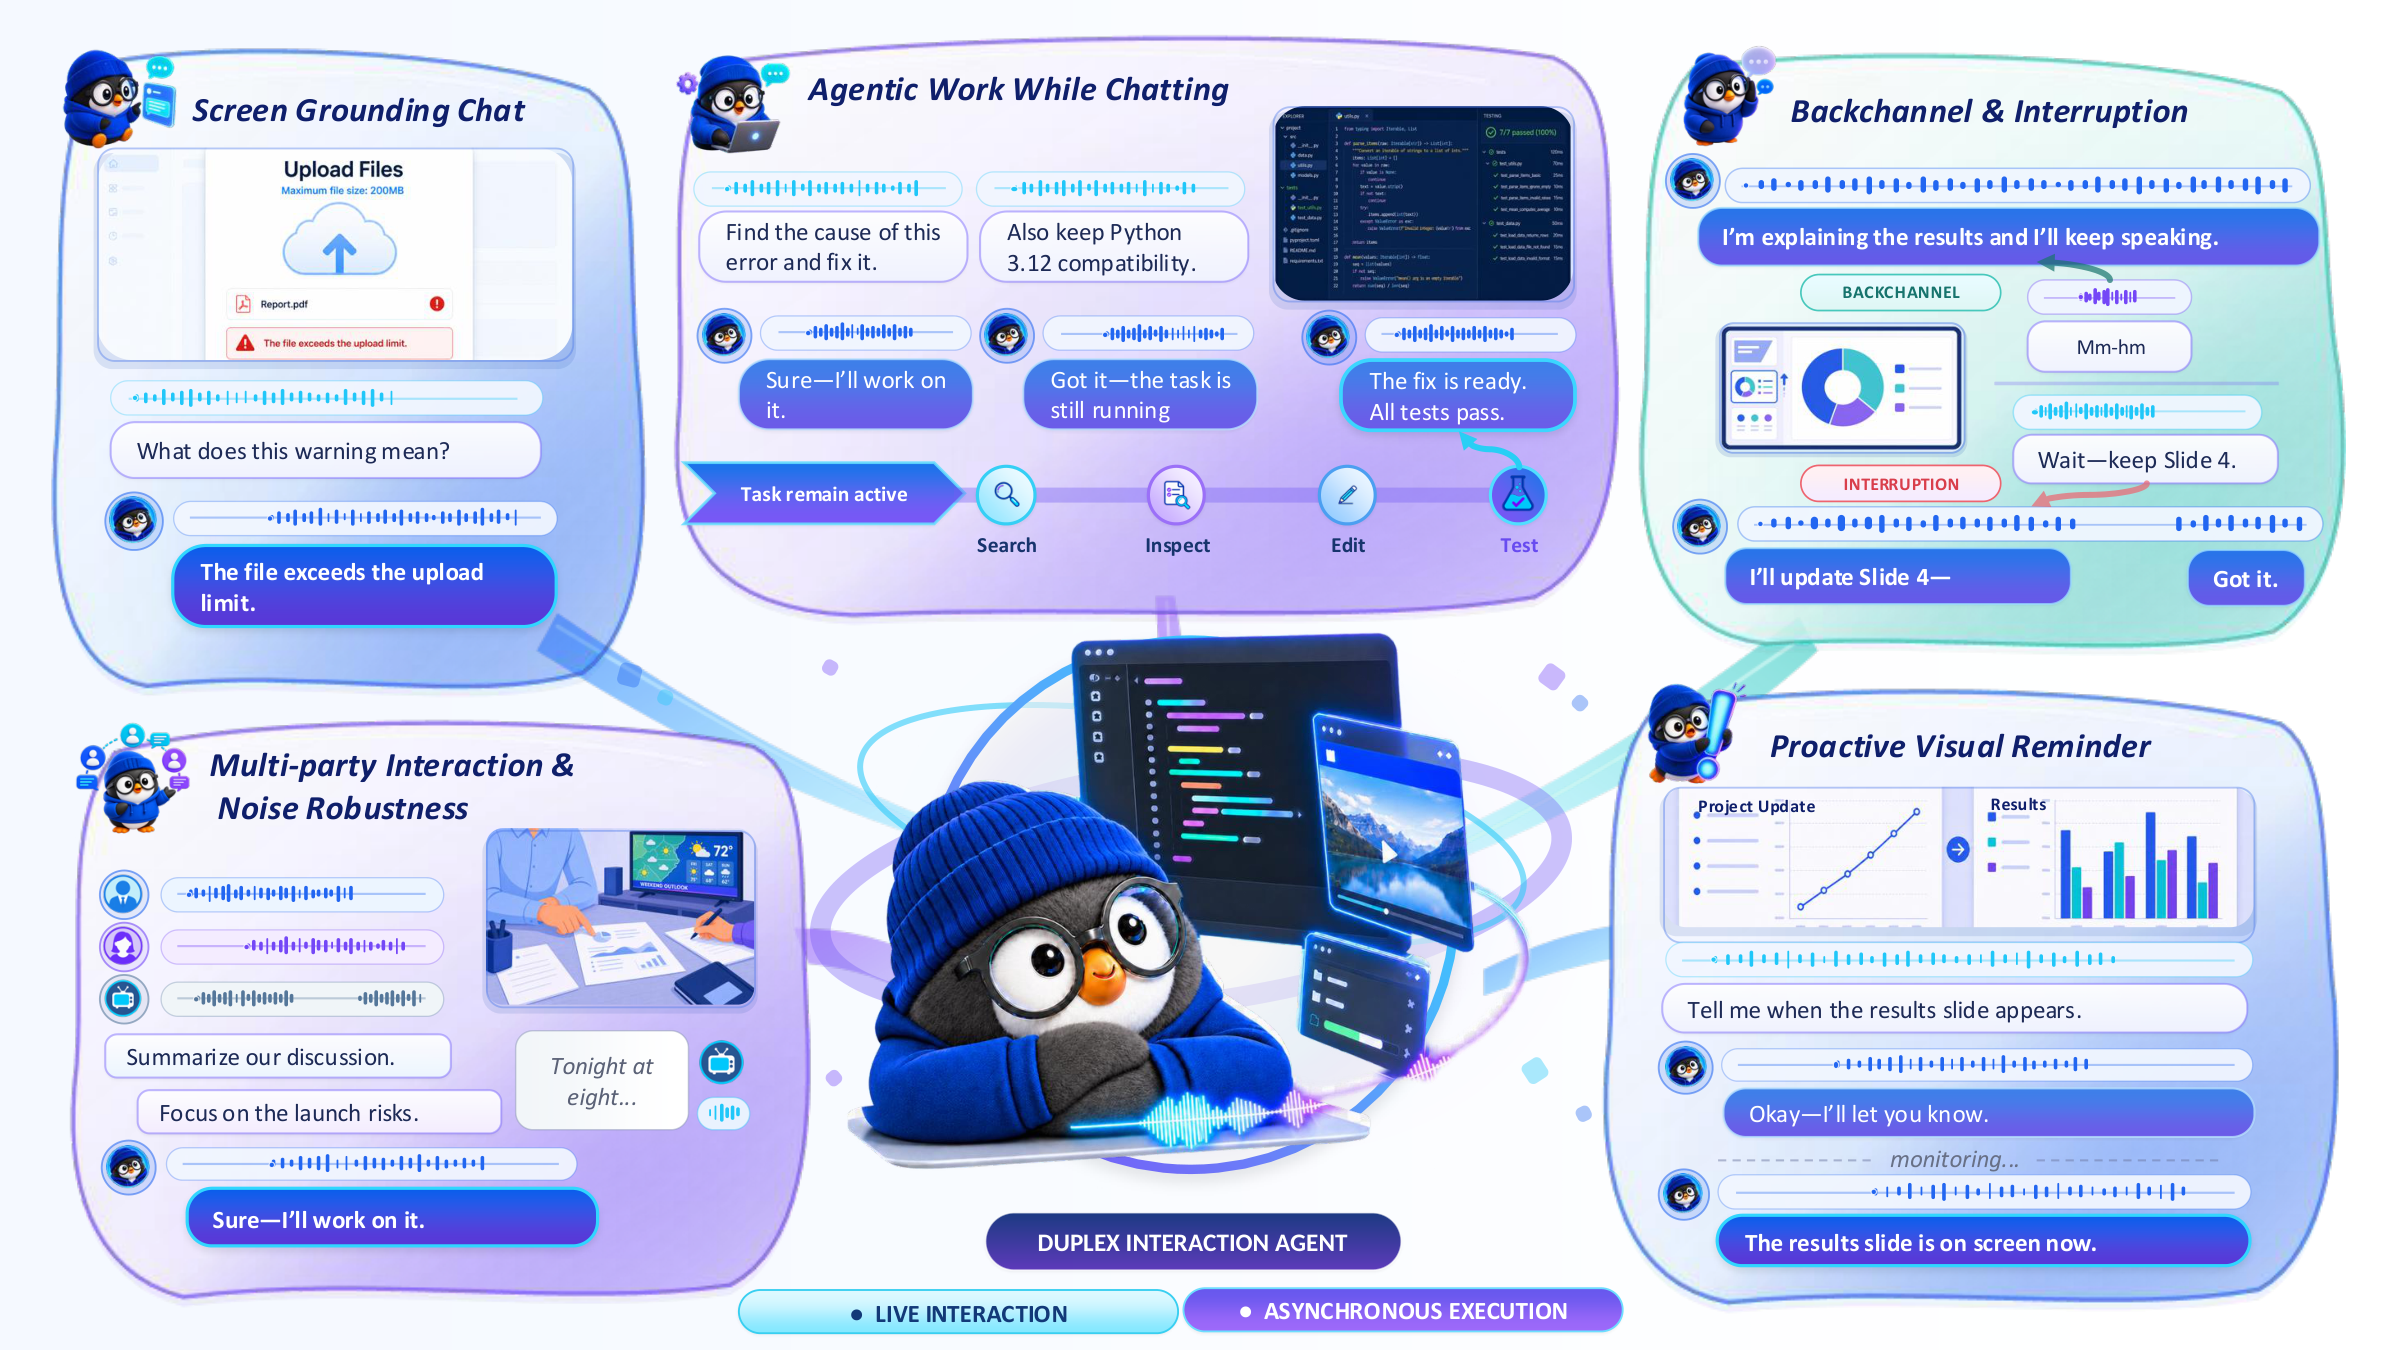
Gander 是冲着语音协作训练的,既要对话自然、有表现力,也要有知识和指令遵循能力。它的 Cerebellum-Brain(小脑-大脑)架构把一个流式对话模型和一个异步推理智能体配在一起,反应快的交互和跑很久的任务因此能待在同一个对话里。
- 对话自然,交互行为靠学习。 轮次切换、附和、处理重叠、打断、主动接话,这些都是模型学出来的行为。Gander 不只学说什么,也学什么时候开口。
- 事情发生时就能看见、听见。 语音、视频、文本共用一条因果时间线,对话因此落在你说的话、你的屏幕和周围不断变化的场景上。
- 它干活的时候,你还能接着聊。 把复杂任务交出去之后,你仍然可以全程参与:补充需求、追问、看进度、给权限、叫停,都在同一场对话里完成。
演示视频:在 YouTube 观看 Gander 演示。
系统设计
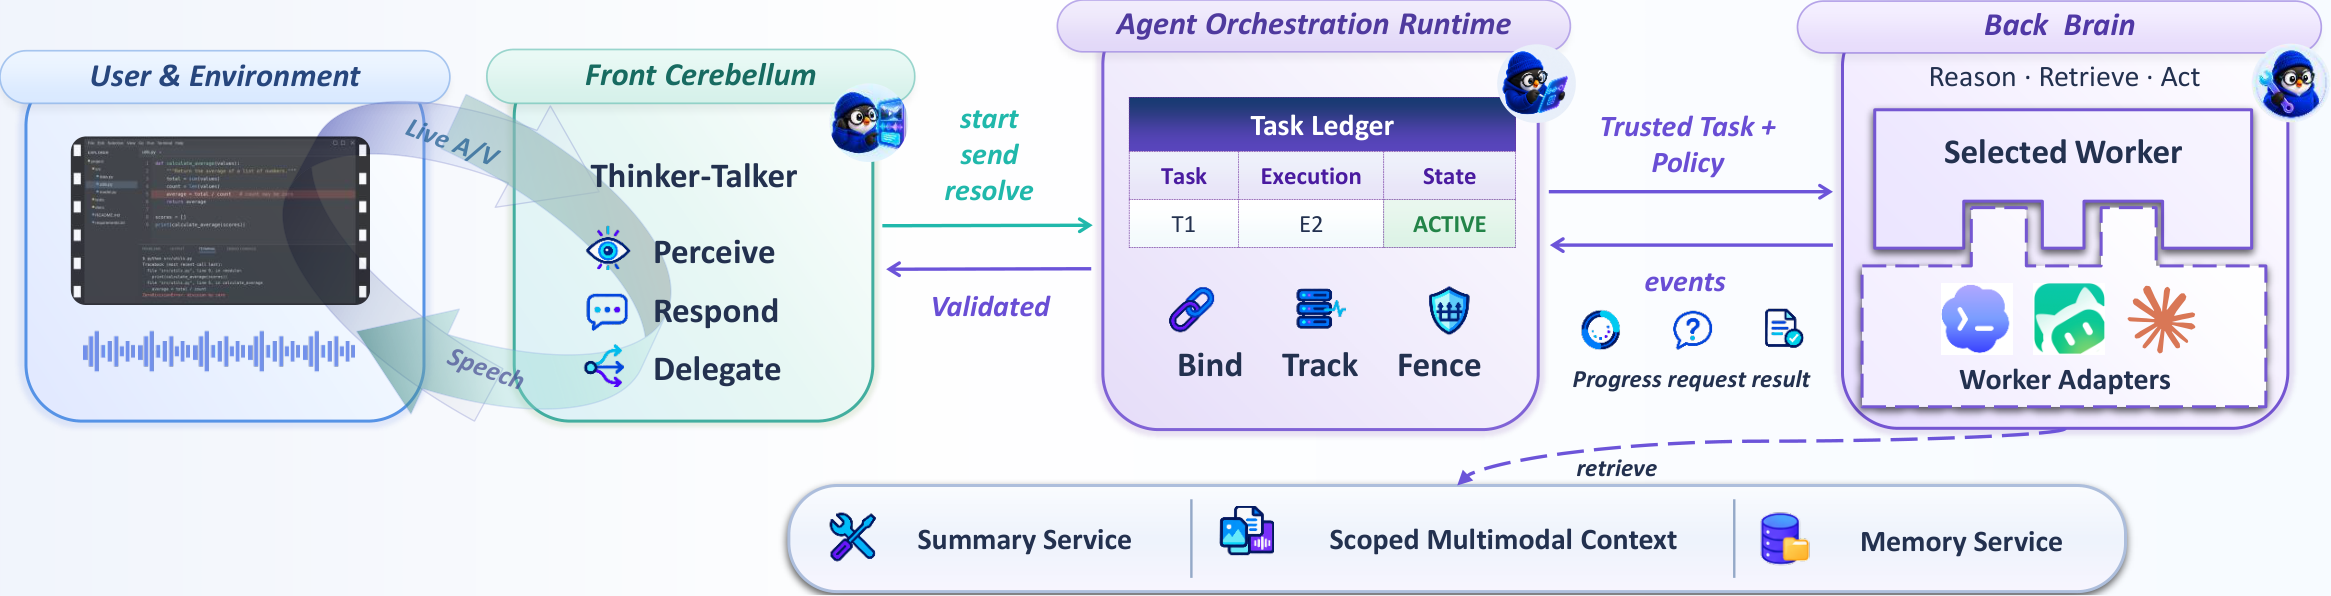
小脑管实时交互,大脑管长程工作,运行时把两边接到同一条任务时间线上。职责分开了,对话没有分开:
| 模块 | 实现 | 职责 |
|---|---|---|
| 流式小脑(Streaming Cerebellum) | minicpm_ft | 实时视听感知、交互控制、文本生成和语音合成。 |
| 智能体编排运行时 | gander_runtime | 可信轮次绑定、任务状态、多模态上下文、worker 事件、权限与结果投递。 |
| 可插拔后端大脑(Back Brain) | Provider 接口 | 长程推理、工具使用、文件与应用操作、工作流执行。 |
一次实时请求只走一条因果路径:
- 浏览器推流麦克风音频,也可以带上摄像头或屏幕画面。源时间戳负责把视觉证据和同一时刻采集的音频对齐。
- 小脑预测这一步是听、说、打断,还是调用任务操作。简单请求直接在本地回答。
- 运行时把智能体工作绑到已经确定的用户轮次上,用有界的文本和视觉上下文启动一次可追踪的大脑执行。
- 大脑在后台异步工作。里程碑、提问、权限请求和最终结果都通过同一段实时对话返回。
托管 ASR 提供浏览器端转写,以及传给大脑的可信文本指令;小脑本身直接处理原始音频。
1. 流式小脑
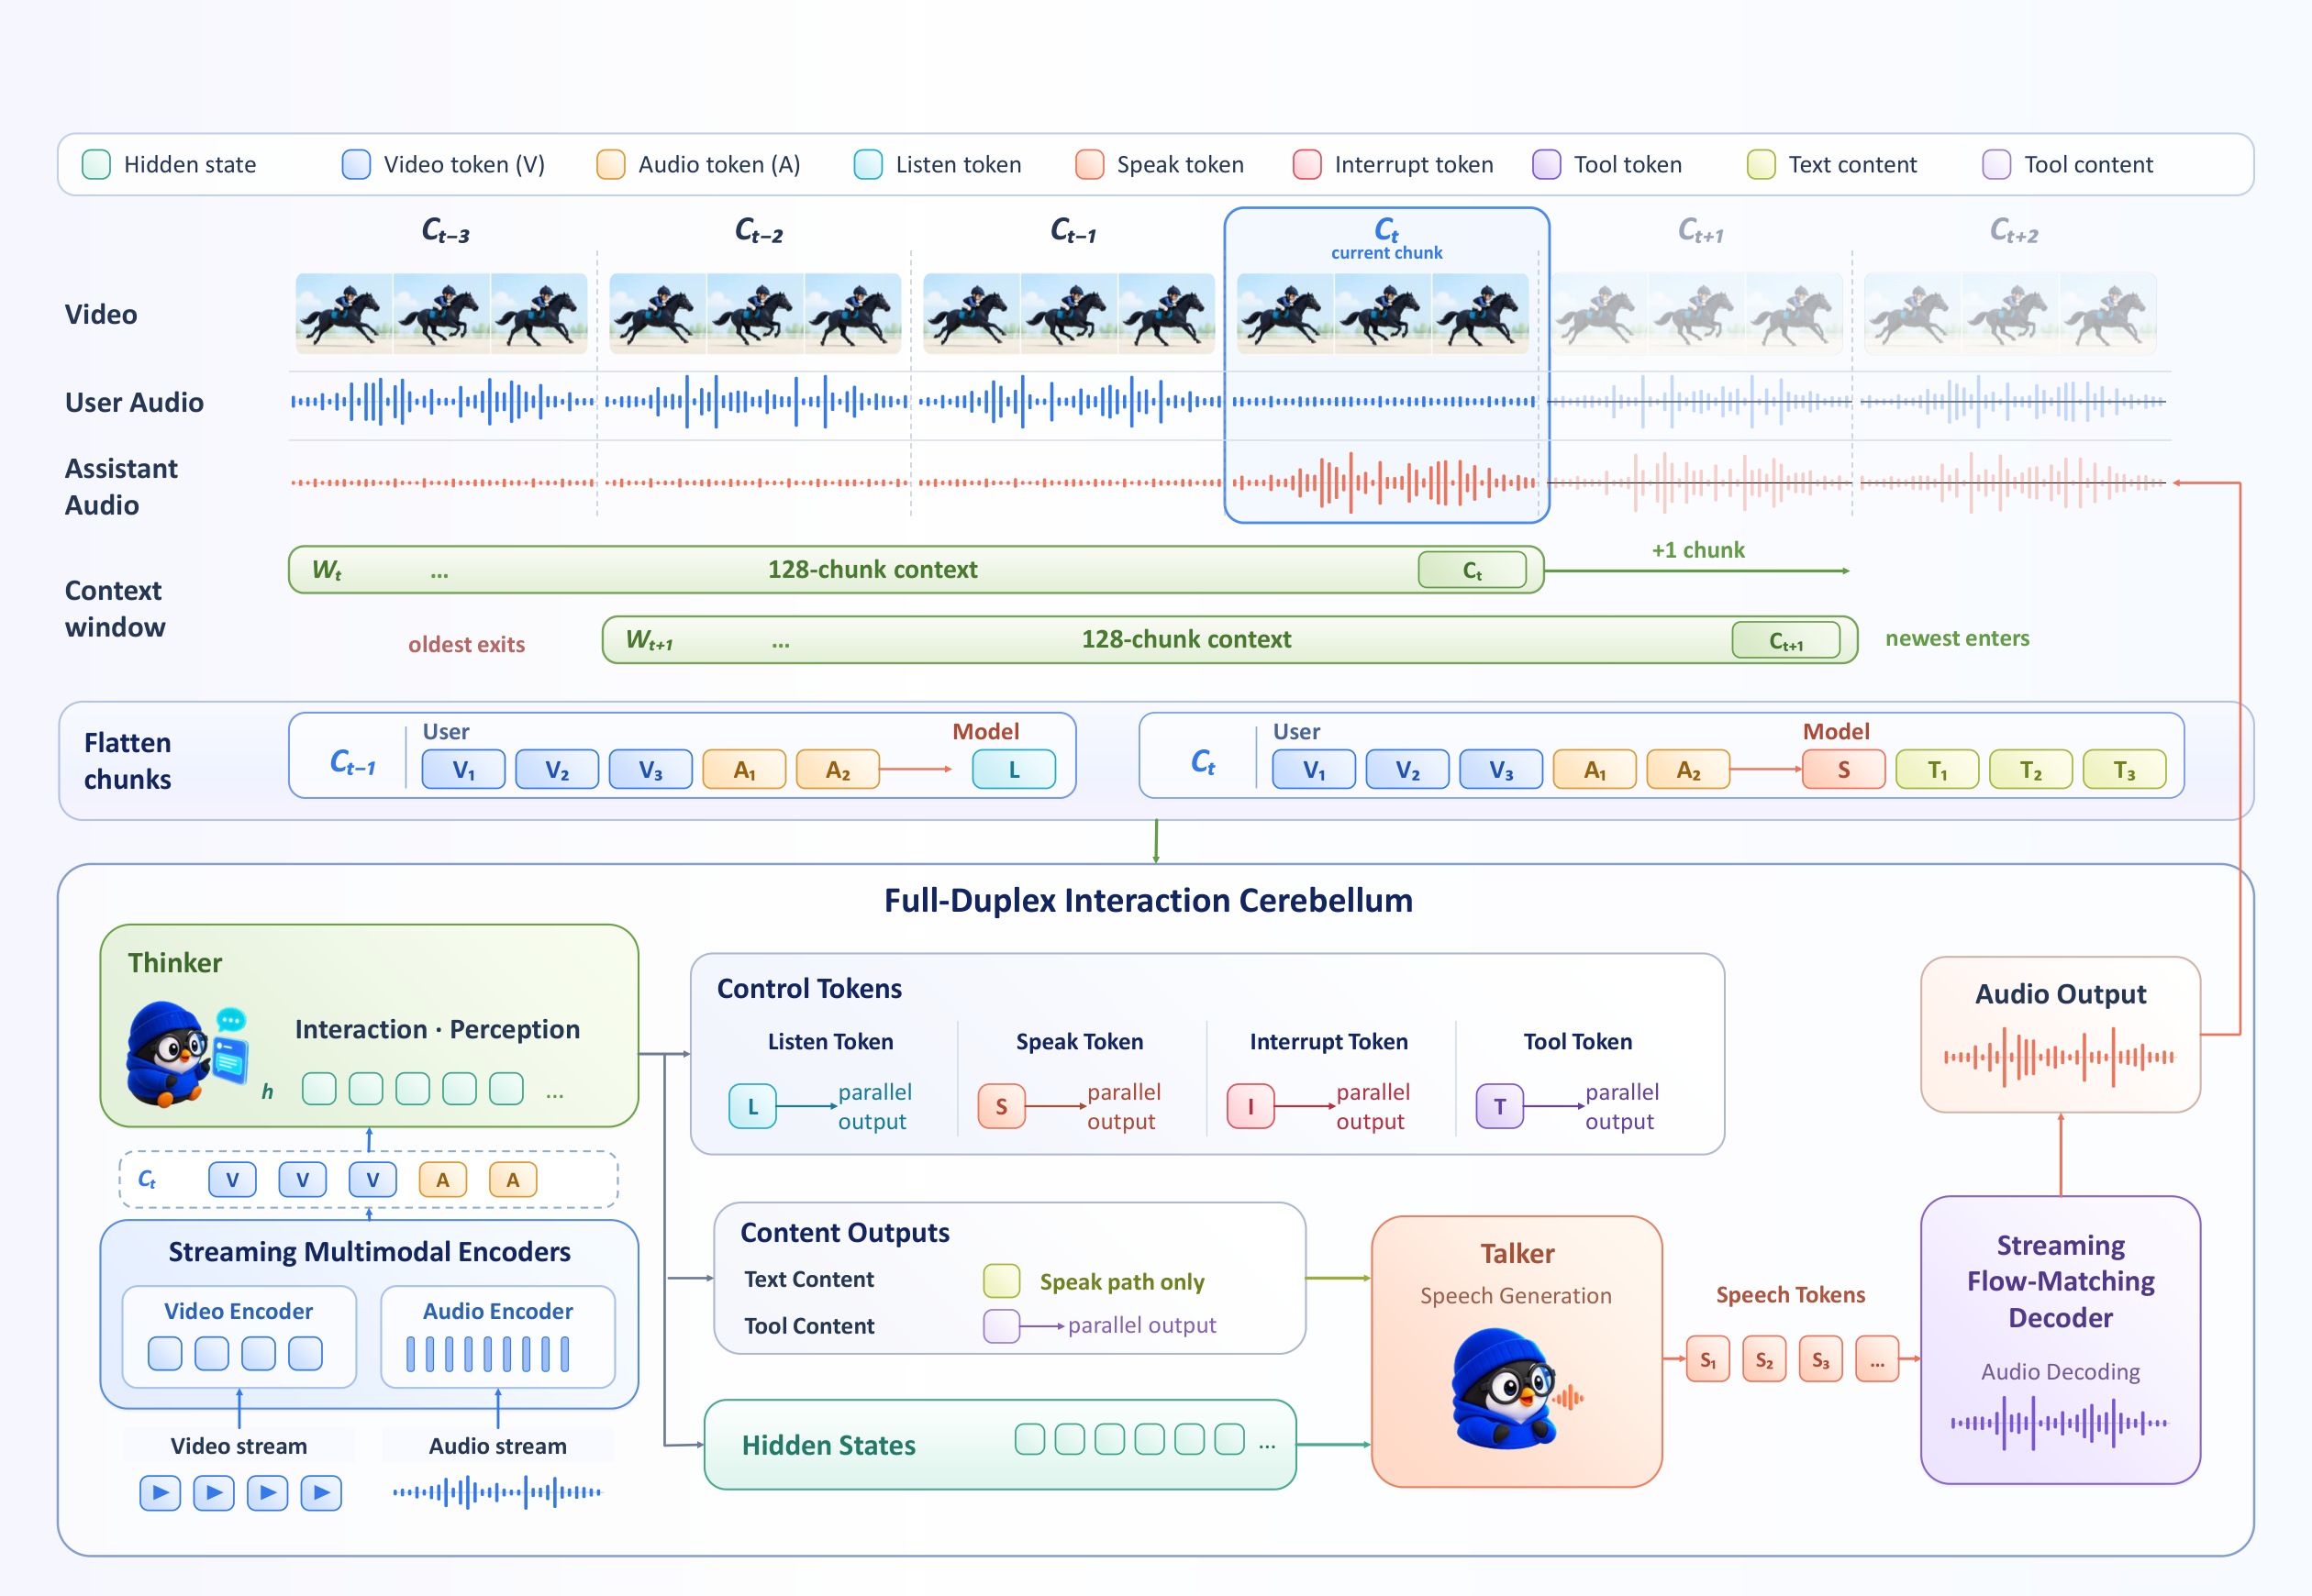
Thinker 管交互和内容,Talker 单独部署,只负责把语音渲染出来,不挡感知。小脑从 MiniCPM-o 4.5 出发,把连续的交互切成 1 秒一个的因果单元:
[video] [audio] [optional task context] -> [control] [text or tool content]
控制 token 先于内容预测,把“要不要动”和“产出什么”分开。
| 控制 | 行为 |
|---|---|
listen | 保持沉默,继续观察输入流。 |
speak | 生成一段有界文本并发送给 Talker。 |
interrupt | 停掉已经不合适的发言,包括用户抢过话头的情况。 |
tool | 为运行时输出一个结构化的任务操作。 |
遇到 speak 单元,Talker 以 Thinker 的隐状态和对齐好的文本 token 为条件预测 S3 语音 token,再由一个因果 flow-matching 解码器增量渲染音频。发布版本里一个单元是 8 个文本 token 对 50 个 S3 token;Talker 独立部署,生成语音的时候感知不会停。
长会话下,模型最多保留最近 128 个单元。运行时提供 context_no_previous、context_slate 和 context_memory 三种模式;发布的服务配置用 context_slate,不靠记忆模型也能保住活跃的任务状态。
2. 智能体编排运行时
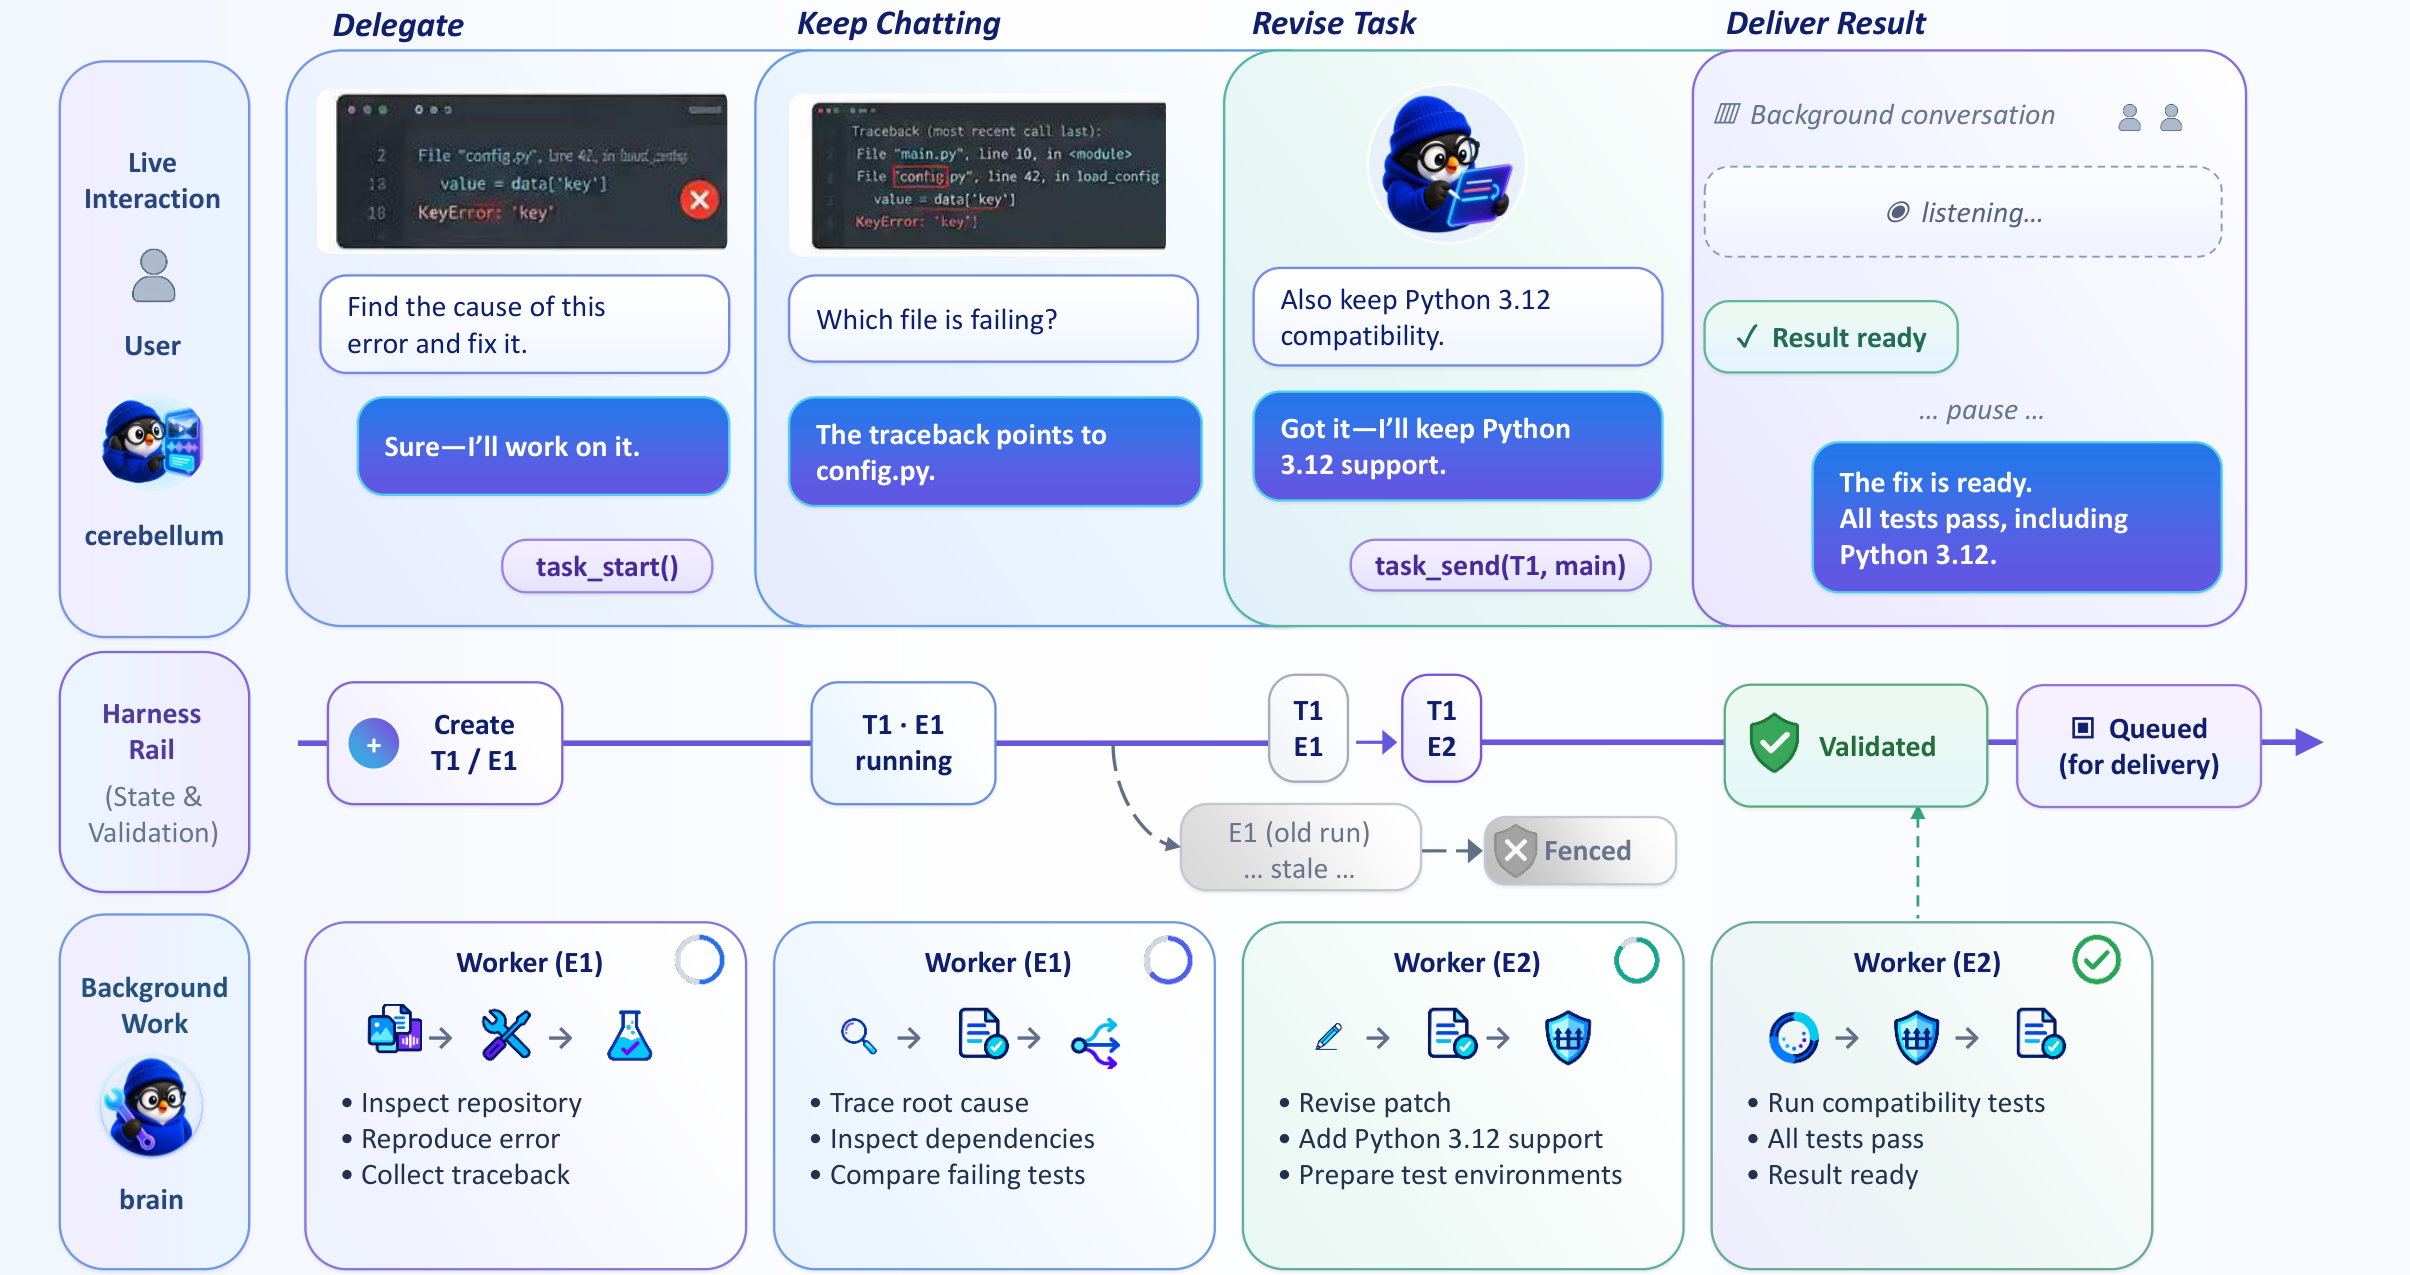
小脑只对外暴露几个任务动作,运行时把它们展开成完整的执行生命周期:
| 操作 | 含义 |
|---|---|
task_start | 基于当前可信用户轮次创建一个后台任务。 |
task_send(main) | 补充信息或约束,引导主执行流程。 |
task_send(fork) | 发起只读的旁路询问,不修改主任务。 |
task_resolve | 取消任务或回应权限请求。 |
项目、任务、运行、worker 事件和投递各自独立追踪。目标改过之后,执行代次(generation)会把过期结果隔开,旧工作不会变成最终答案。里程碑、多问题澄清、权限决策、停止、重置、清空这些原生事件类型也各自保留,不会混成一种。
3. 可插拔后端大脑
默认的大脑 provider 是 Codex。provider 走注册表构建,想接别的智能体,不用碰小脑的任务协议或 gateway 状态机。在 worker.profile: full 下,大脑保留自己原有的工具,另外拿到几个 Gander 专用接口:
| 接口 | 用途 |
|---|---|
| Provider 工具 | 使用 worker 配置的文件、shell、检索、应用等工具。 |
context_fetch | 从当前任务谱系中获取可信轮次、任务事件、产物以及摄像头或屏幕帧。 |
memory_search | 配置外部记忆 provider 时,检索跨会话证据。 |
share | 在工作继续时返回已验证的里程碑、重要发现或更正。 |
| 原生提问与审批 | 询问缺失信息或请求权限,并用用户的回答继续同一次执行。 |
评测
技术报告评了四块:对话能力、全双工交互、多模态理解和工具辅助的任务执行。人工评测显示,Gander 的语音对话能保持自然、有表现力。全双工流式设置下,它在 SpokenQA 和 VoiceBench 的 2,052 条基准语句上做了评测;全双工和智能体后训练之后,WorldSense 上准确率 49.62%,Daily-Omni 上 78.53%。
| 能力 | 评测 | 结果 |
|---|---|---|
| 语音知识问答 | SpokenQA,Llama Questions / Web Questions | 75.60 / 59.30 |
| 语音指令与对话 | VoiceBench,AlpacaEval / SD-QA | 3.96 / 5 与 46.84% |
| 交互时机 | Full-Duplex-Bench v3 | 100% 恰当轮次切换;8.0% 过早打断 |
| 工具辅助执行 | Full-Duplex-Bench v3 | 工具选择 F1 0.759;参数准确率 0.503;严格 Pass@1 0.400 |
| 视听理解 | WorldSense / Daily-Omni | 49.62% / 78.53% 准确率 |
快速开始
按下面的步骤可以把整套浏览器系统跑起来:托管 ASR、流式 Thinker、独立部署的 Talker、智能体运行时、Web UI,以及基于 Codex 的大脑。
环境要求
| 要求 | 说明 |
|---|---|
| 系统 | Linux、Conda,以及与 CUDA 12.4 PyTorch 栈兼容的 NVIDIA 驱动。 |
| GPU | 发布配置使用三张物理 GPU,Thinker、Talker 和 ASR 各一张。 |
| 模型 | MiniCPM-o 4.5、配套的 Gander Thinker/Talker 权重,以及 faster-whisper large-v3。 |
| 大脑 | 已登录的 Codex CLI,或支持 app-server --stdio 的兼容可执行程序。 |
1. 安装仓库
git clone https://github.com/Omni-Interaction-Gander/Omni-Interaction-Agent.git
cd Omni-Interaction-Agent

conda env create -f environment.yml
conda activate gander
2. 安装大脑
在服务器上安装 Codex CLI,然后运行一次,完成登录:
curl -fsSL https://chatgpt.com/codex/install.sh | sh
codex
登录后确认 codex app-server --help 能正常执行。Gander 会自己启动和管理 app server。
3. 下载模型权重
mkdir -p checkpoints

hf download openbmb/MiniCPM-o-4_5 \
  --local-dir checkpoints/MiniCPM-o-4_5
hf download Gander-Omni/Gander \
  --local-dir checkpoints/Gander
hf download Systran/faster-whisper-large-v3 \
  --local-dir checkpoints/faster-whisper-large-v3
已经有本地副本的也能直接用。Thinker 和 Talker 请从 Gander 模型页上挑配套的那一对。
4. 配置服务
cp gander_runtime/configs/serve.example.yaml \
  gander_runtime/configs/serve.local.yaml
mkdir -p workspace
把 serve.local.yaml 里的路径占位符换成绝对路径:
| 资源 | 配置字段 |
|---|---|
| MiniCPM-o 4.5 | model.model_name_or_path、model.processor_name_or_path、model.token2wav_dir 和 duplex.ref_audio_path |
| Gander | duplex.checkpoint 和 duplex.talker_checkpoint |
| 托管 ASR | asr.model_path |
| 大脑 | worker.settings.codex_bin;只有用另一个已登录的 home 目录时才需要设置 codex_home |
大脑的配置不长:
worker:
  provider: codex
  cwd: ../workspace
  profile: full
  settings:
    codex_bin: codex
    model: null
    reasoning_effort: medium
    codex_home: null
cwd 是大脑能用的工作区。codex_bin 填 PATH 里的命令或绝对路径都行,model: null 表示沿用 Codex 的默认模型。
发布模板已经设好 8/50 token 对齐、context_slate、完整的大脑工具,以及三卡映射:GPU 0 跑 Thinker,GPU 1 跑 Talker,GPU 2 跑 ASR。
5. 校验并启动
./scripts/serve.sh --check-config
./scripts/serve.sh
--check-config 只校验服务配置,不加载模型权重。启动后打开 http://127.0.0.1:8000;/health 和 /api/asr/health 分别报告运行时和 ASR 是否就绪。要从远端访问,得用 HTTPS 把 HTTP 和 WebSocket 路由一起代理出去,浏览器的媒体权限才会正常。
训练
训练只有一个入口,配置分层写在 YAML 里。scripts/train.sh 先加载 minicpm_ft/configs/train.yaml,再按顺序叠上传入的数据集或实验 YAML,最后应用命令行里点号形式的覆盖参数。
数据与训练-服务对齐
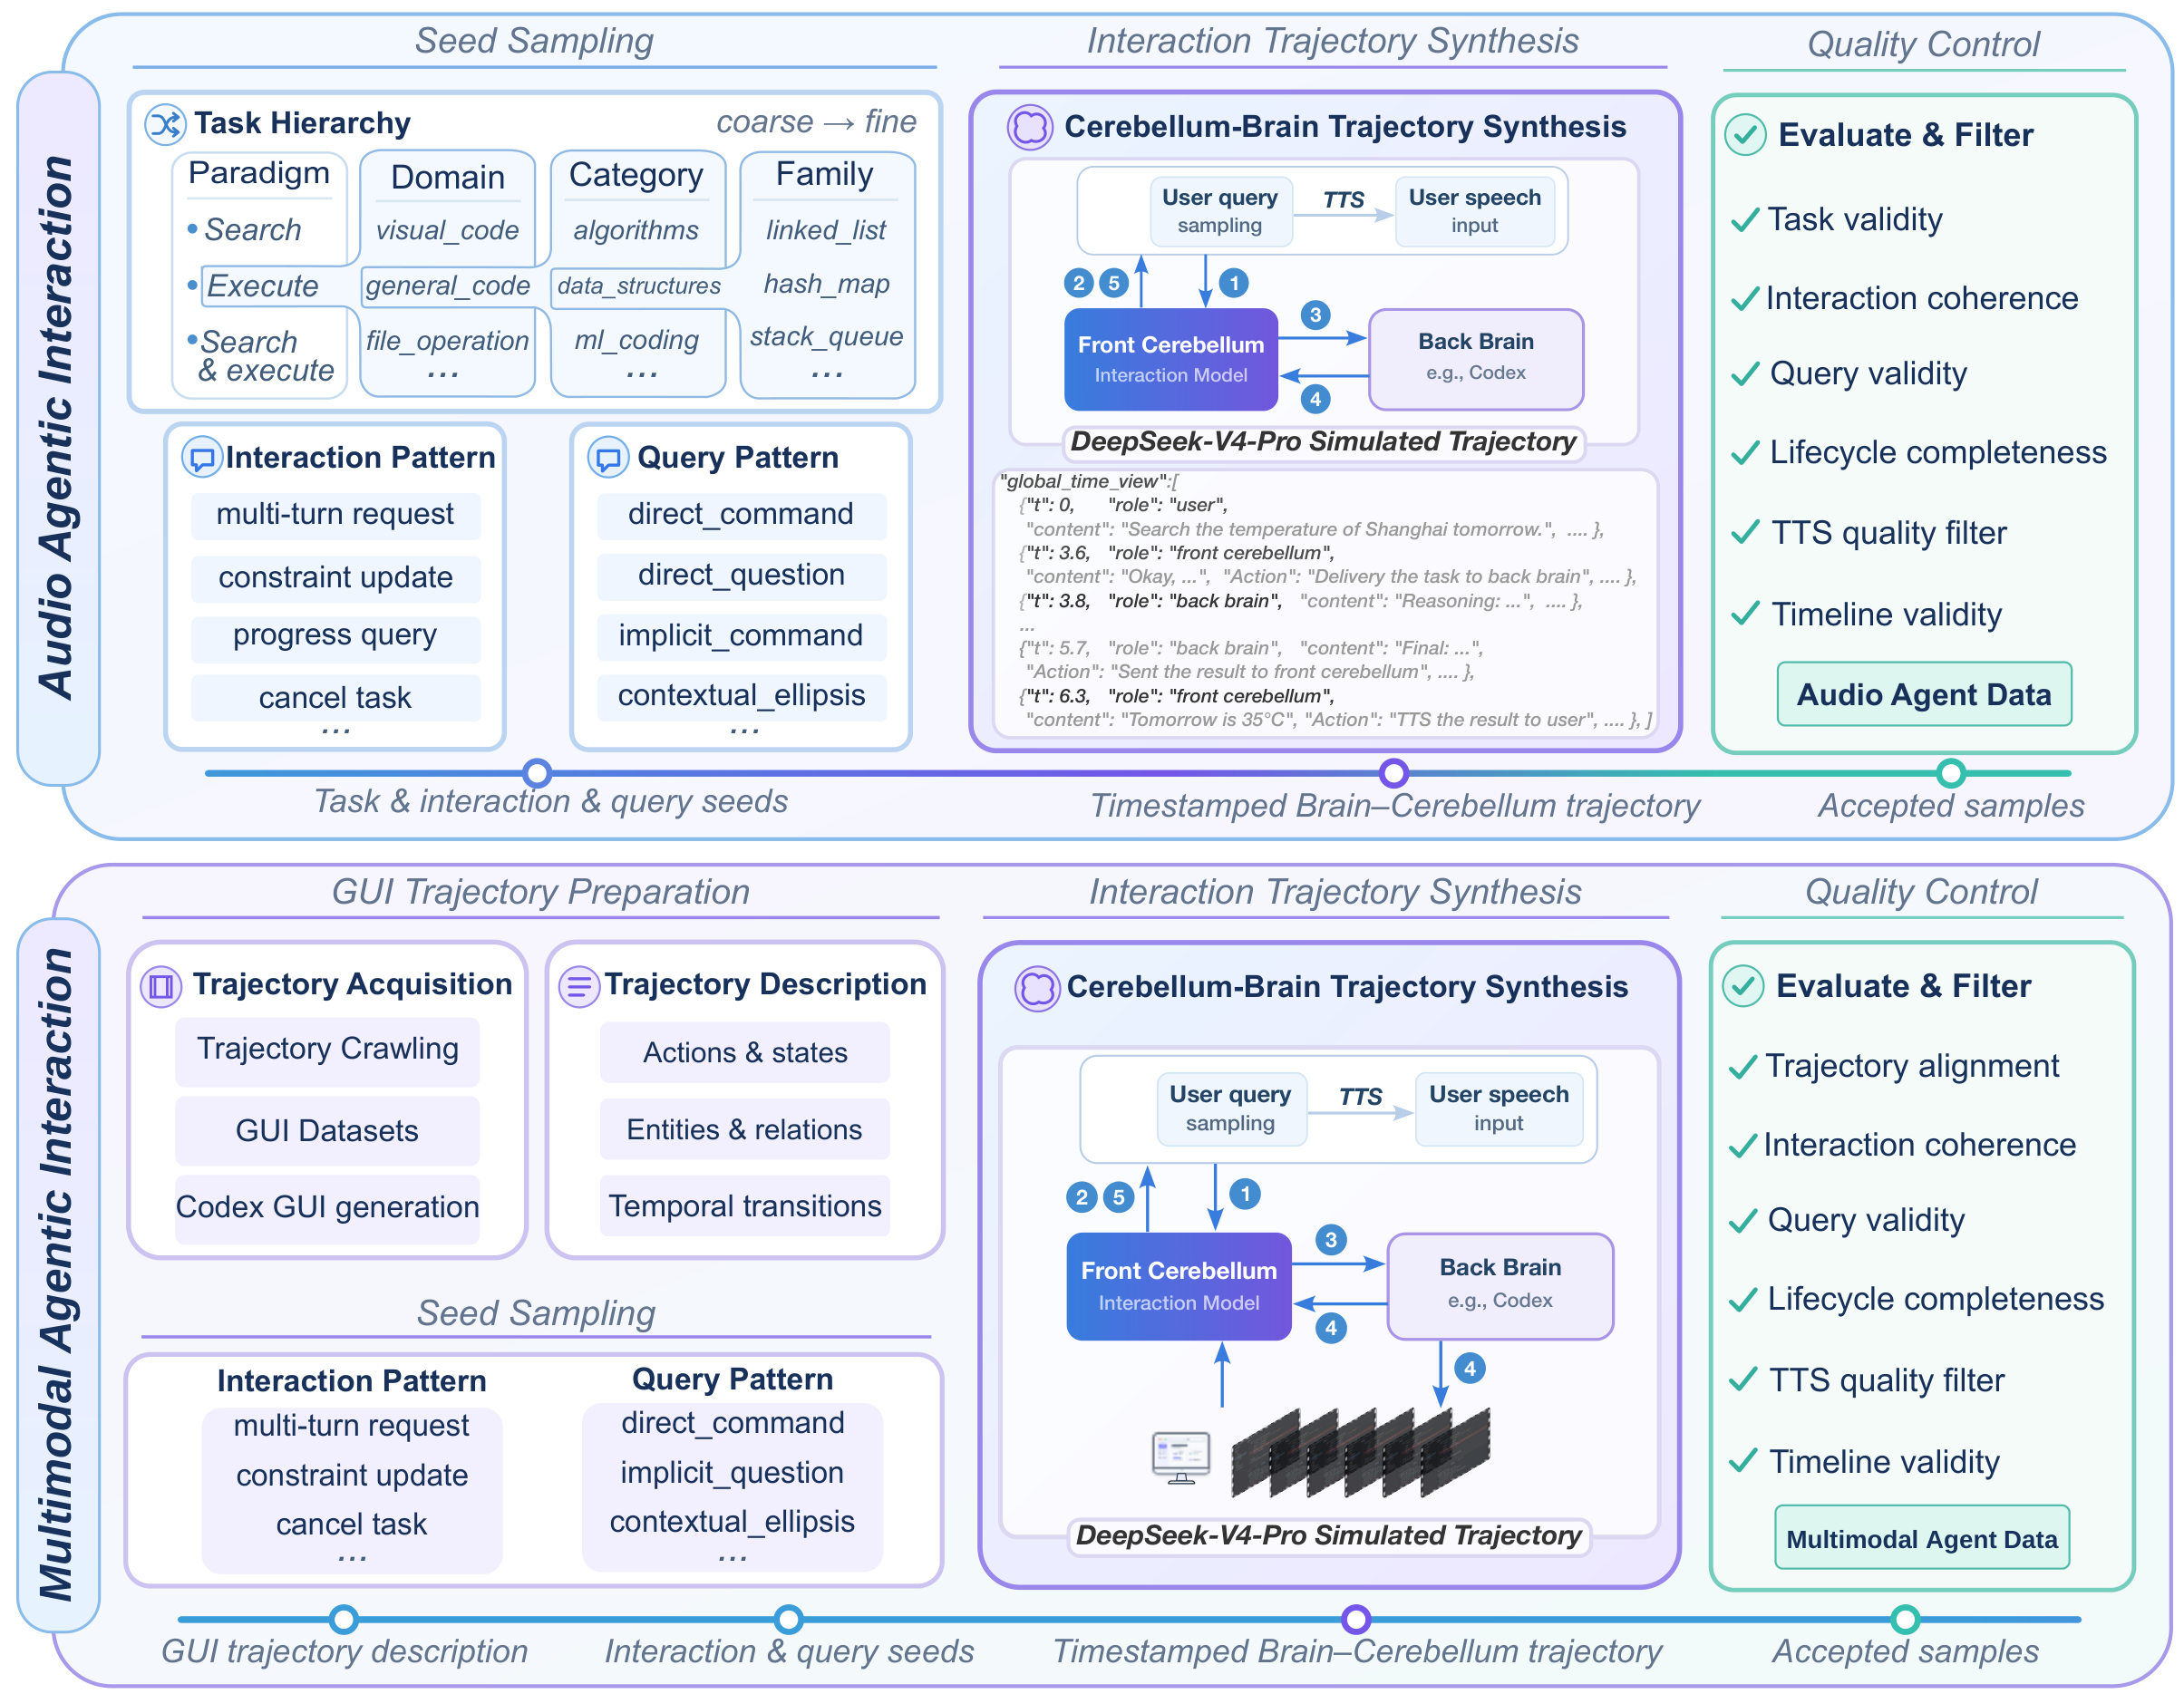
训练样本沿用部署系统的因果单元时间线和任务生命周期。Gander 的训练集是 270 万条样本的混合数据:
| 数据类别 | 规模 | 主要监督内容 |
|---|---|---|
| 语音交互 | 1.01M | 语音对话与问答、InteractionSpeech、打断、附和回应、同声传译。 |
| 视听交互 | 1.10M | 流式视频问答、解说、时间定位和主动视觉回应。 |
| 智能体交互 | 359.6K | 委派、引导、进度、澄清、权限、取消、GUI 轨迹和工具推理。 |
| 鲁棒性与负样本 | 229.7K | 无关视频、无指令环境、干扰、重叠的干扰说话人和多方追踪。 |
训练和服务共享三条核心约定:
- 输入和输出使用相同的 1 秒因果单元,视觉证据按源时间选取。
- 长上下文训练最多保留 128 个历史单元和 1,500 个历史上下文 token;超过 16,384 token 上限的样本直接过滤掉,不做截断。
- 声学增强会加入噪声、多人嘈杂声、瞬态声、设备染色、房间响应、回声或空闲段,交互时间线保持不动。
发布的训练方案分两个阶段:
| 阶段 | 可训练模块 | 目标 |
|---|---|---|
| Thinker | LLM 和音频投影 | 文本、交互控制和结构化工具调用 token。 |
| Talker | TTS 投影和解码器;Thinker 冻结 | 以 Thinker 隐状态为条件、时间对齐的 S3 语音 token。 |
仓库也留了联合训练模式,供实验使用;发布权重走的是上面这条两阶段流程。
校验内置示例
仓库内置 12 条 Thinker 示例和 6 条 Talker 示例,都带本地媒体,用来做小规模的数据链路检查:
./scripts/prepare_data.sh check \
  minicpm_ft/examples/release/thinker/train_config.yaml
./scripts/prepare_data.sh check \
  minicpm_ft/examples/release/talker/train_config.yaml
训练 Thinker
BASE=/absolute/path/to/MiniCPM-o-4_5

./scripts/train.sh minicpm_ft/examples/release/thinker/train_config.yaml \
  --model.model_name_or_path "$BASE" \
  --model.processor_name_or_path "$BASE" \
  --launch.gpus_per_node 1 \
  --train.output_dir outputs/thinker
Thinker 模式训练 LLM 和音频投影,视觉塔、resampler 和 TTS 模块保持冻结。默认目标是文本损失加上权重 1.5 的交互控制损失。
训练 Talker
BASE=/absolute/path/to/MiniCPM-o-4_5
THINKER=/absolute/path/to/thinker-checkpoint

./scripts/train.sh minicpm_ft/examples/release/talker/train_config.yaml \
  --model.model_name_or_path "$BASE" \
  --model.processor_name_or_path "$BASE" \
  --runtime.init_checkpoint "$THINKER" \
  --launch.gpus_per_node 1 \
  --train.output_dir outputs/talker
Talker 模式冻结训好的 Thinker 的 LLM 和音频投影,只训练 TTS 投影和解码器。内置示例自带 S3 目标;要是数据集里没有内联的 turn.meta.s3_codes,就在训练 YAML 里设好 data.s3_cache_dir,先建缓存:
./scripts/prepare_data.sh s3 /path/to/release/train_config.yaml --device cuda:0
两个阶段默认都开着 save_trainable_only: true。部署时先拿 MiniCPM-o 4.5 叠上 Thinker,再叠上 Talker,两份权重都不重复存冻结的基座参数。
离线推理
同一个入口,两条路径:
| 模式 | 输入与行为 |
|---|---|
turn | 一次有界的文本、音频、图像或组合输入,生成一次回复。 |
duplex | 以在线 1 秒单元消费音频,逐单元输出控制决策、增量文本、工具轨迹以及可选的语音。 |
从发布配置改起,设好 model.model_name_or_path、model.processor_name_or_path、inference.checkpoint 和 inference.input 下面的字段,然后运行:
cp minicpm_ft/configs/infer.yaml /tmp/gander-infer.yaml
./scripts/infer.sh /tmp/gander-infer.yaml
轮次式推理保持 inference.mode: turn,input.text、input.audio、input.image 里支持哪几种就填哪几种。分块式全双工推理用发布时的流式参数:
inference:
  mode: duplex
  checkpoint: /path/to/gander-thinker-checkpoint
  input:
    text: null
    audio: /path/to/input.wav
    image: null
  duplex:
    chunk_ms: 1000
    speak_text_tokens_per_unit: 8
    talker_speech_tokens_per_unit: 50
    sliding_window_mode: context_slate
    context_previous_max_tokens: 1500
要生成语音,还得配好 Talker 和参考音频:
model:
  init_tts: true
  token2wav_dir: /path/to/MiniCPM-o-4_5/assets/token2wav

inference:
  talker_checkpoint: /path/to/gander-talker-checkpoint
  generate_audio: true
  output_audio: /path/to/output.wav
  input:
    audio: /path/to/input.wav
    ref_audio: /path/to/reference.wav
配置参考
主要部署选项都在服务 YAML 里:
| 配置项 | 选项 |
|---|---|
server.mode | lean 走最短的可信任务路径;coordinator 额外加一层规划与监督。 |
duplex.media_mode | voice 从音频开始,omni 需要视觉输入,auto 交给客户端选。 |
duplex.allow_client_video | 单独控制摄像头和屏幕接入。 |
duplex.sliding_window_mode | 选 context_no_previous、context_slate 或 context_memory。 |
worker.provider / worker.profile | 选已注册的大脑后端,以及任务范围或完整的工具集。 |
asr.mode | 跑托管 ASR、接外部服务,或者关掉转写。 |
仓库结构
| 路径 | 内容 |
|---|---|
minicpm_ft/mcpmft/data/ | 清单加载、媒体解析、数据增强、时序序列化、批处理和 S3 目标。 |
minicpm_ft/mcpmft/modeling/ | 模型加载、可训练模块选择、多模态前向和流式声学特征。 |
minicpm_ft/mcpmft/infer/ | 轮次式与分块式推理、上下文窗口、独立 Talker、ASR 和浏览器客户端。 |
gander_runtime/gander_runtime/ | 实时传输、媒体时间线、任务 gateway、台账、上下文路由、worker 事件和监督。 |
gander_runtime/gander_runtime/providers/ | 类型化的大脑 provider 注册表、能力声明、工厂和 Codex 适配器。 |
minicpm_ft/examples/release/ | 自带本地媒体的 Thinker 与 Talker 示例。 |
scripts/ | 数据校验、训练、离线推理和服务的稳定入口。 |
docs/ | 论文和部分系统图。 |
相关链接
- GitHub:Omni-Interaction-Gander/Omni-Interaction-Agent
- 论文:arXiv:2609.08977
- 模型:Gander-Omni/Gander
- 项目主页:Omni-Interaction-Gander.github.io/Omni-Interaction-Agent
- 演示视频:YouTube
- 数据集:即将开源
项目作者:Omni-Interaction-Gander 团队(Orantqing、Shengpeng Ji、Junlong Tong 等)。代码以 Apache License 2.0 发布。