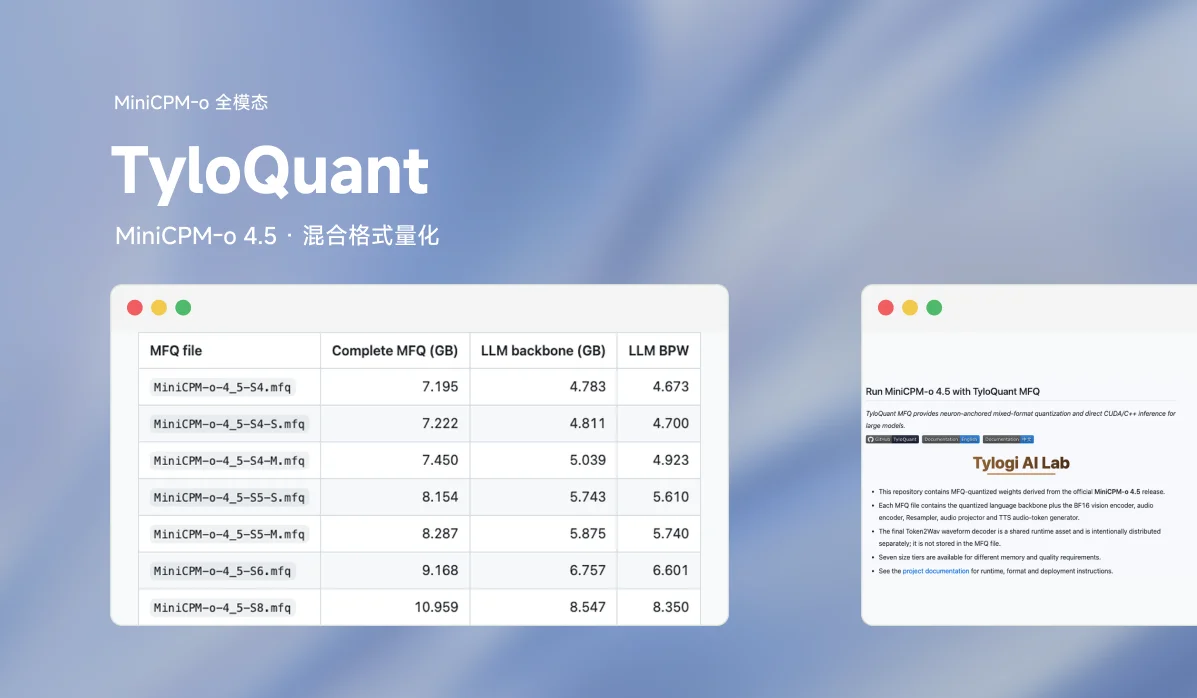
MFQ 是 Tylogi AI Lab 做的量化和推理系统,目标是在本地硬件上跑大模型,口号是“Every Bit. Maximum Fidelity.”。它把三件事放在一起设计:细粒度混合精度校准、紧凑的权重格式、原生 CUDA/Metal 运行时。在内存、存储和延迟的预算里,尽量保住模型质量。MiniCPM-o 4.5 是 MFQ 官方支持、并且已经发布量化版本的多模态模型之一。
效果一览
下面这组结果跑在 Qwen3.8-Flash-Next 上,每一项都标了所用档位和测量条件。
| 关注点 | 实测结果 | 配置 |
|---|---|---|
| 量化质量 | KLD 降低 37.4%;Top1 一致率提升 5.03 个百分点 | V1-M 对比 Unsloth UD IQ1_M,WikiText-2,权重约 74.5 GB |
| 常驻权重 | 43.36 GiB | V1-M,Metal,PLE 表从 SSD 读取 |
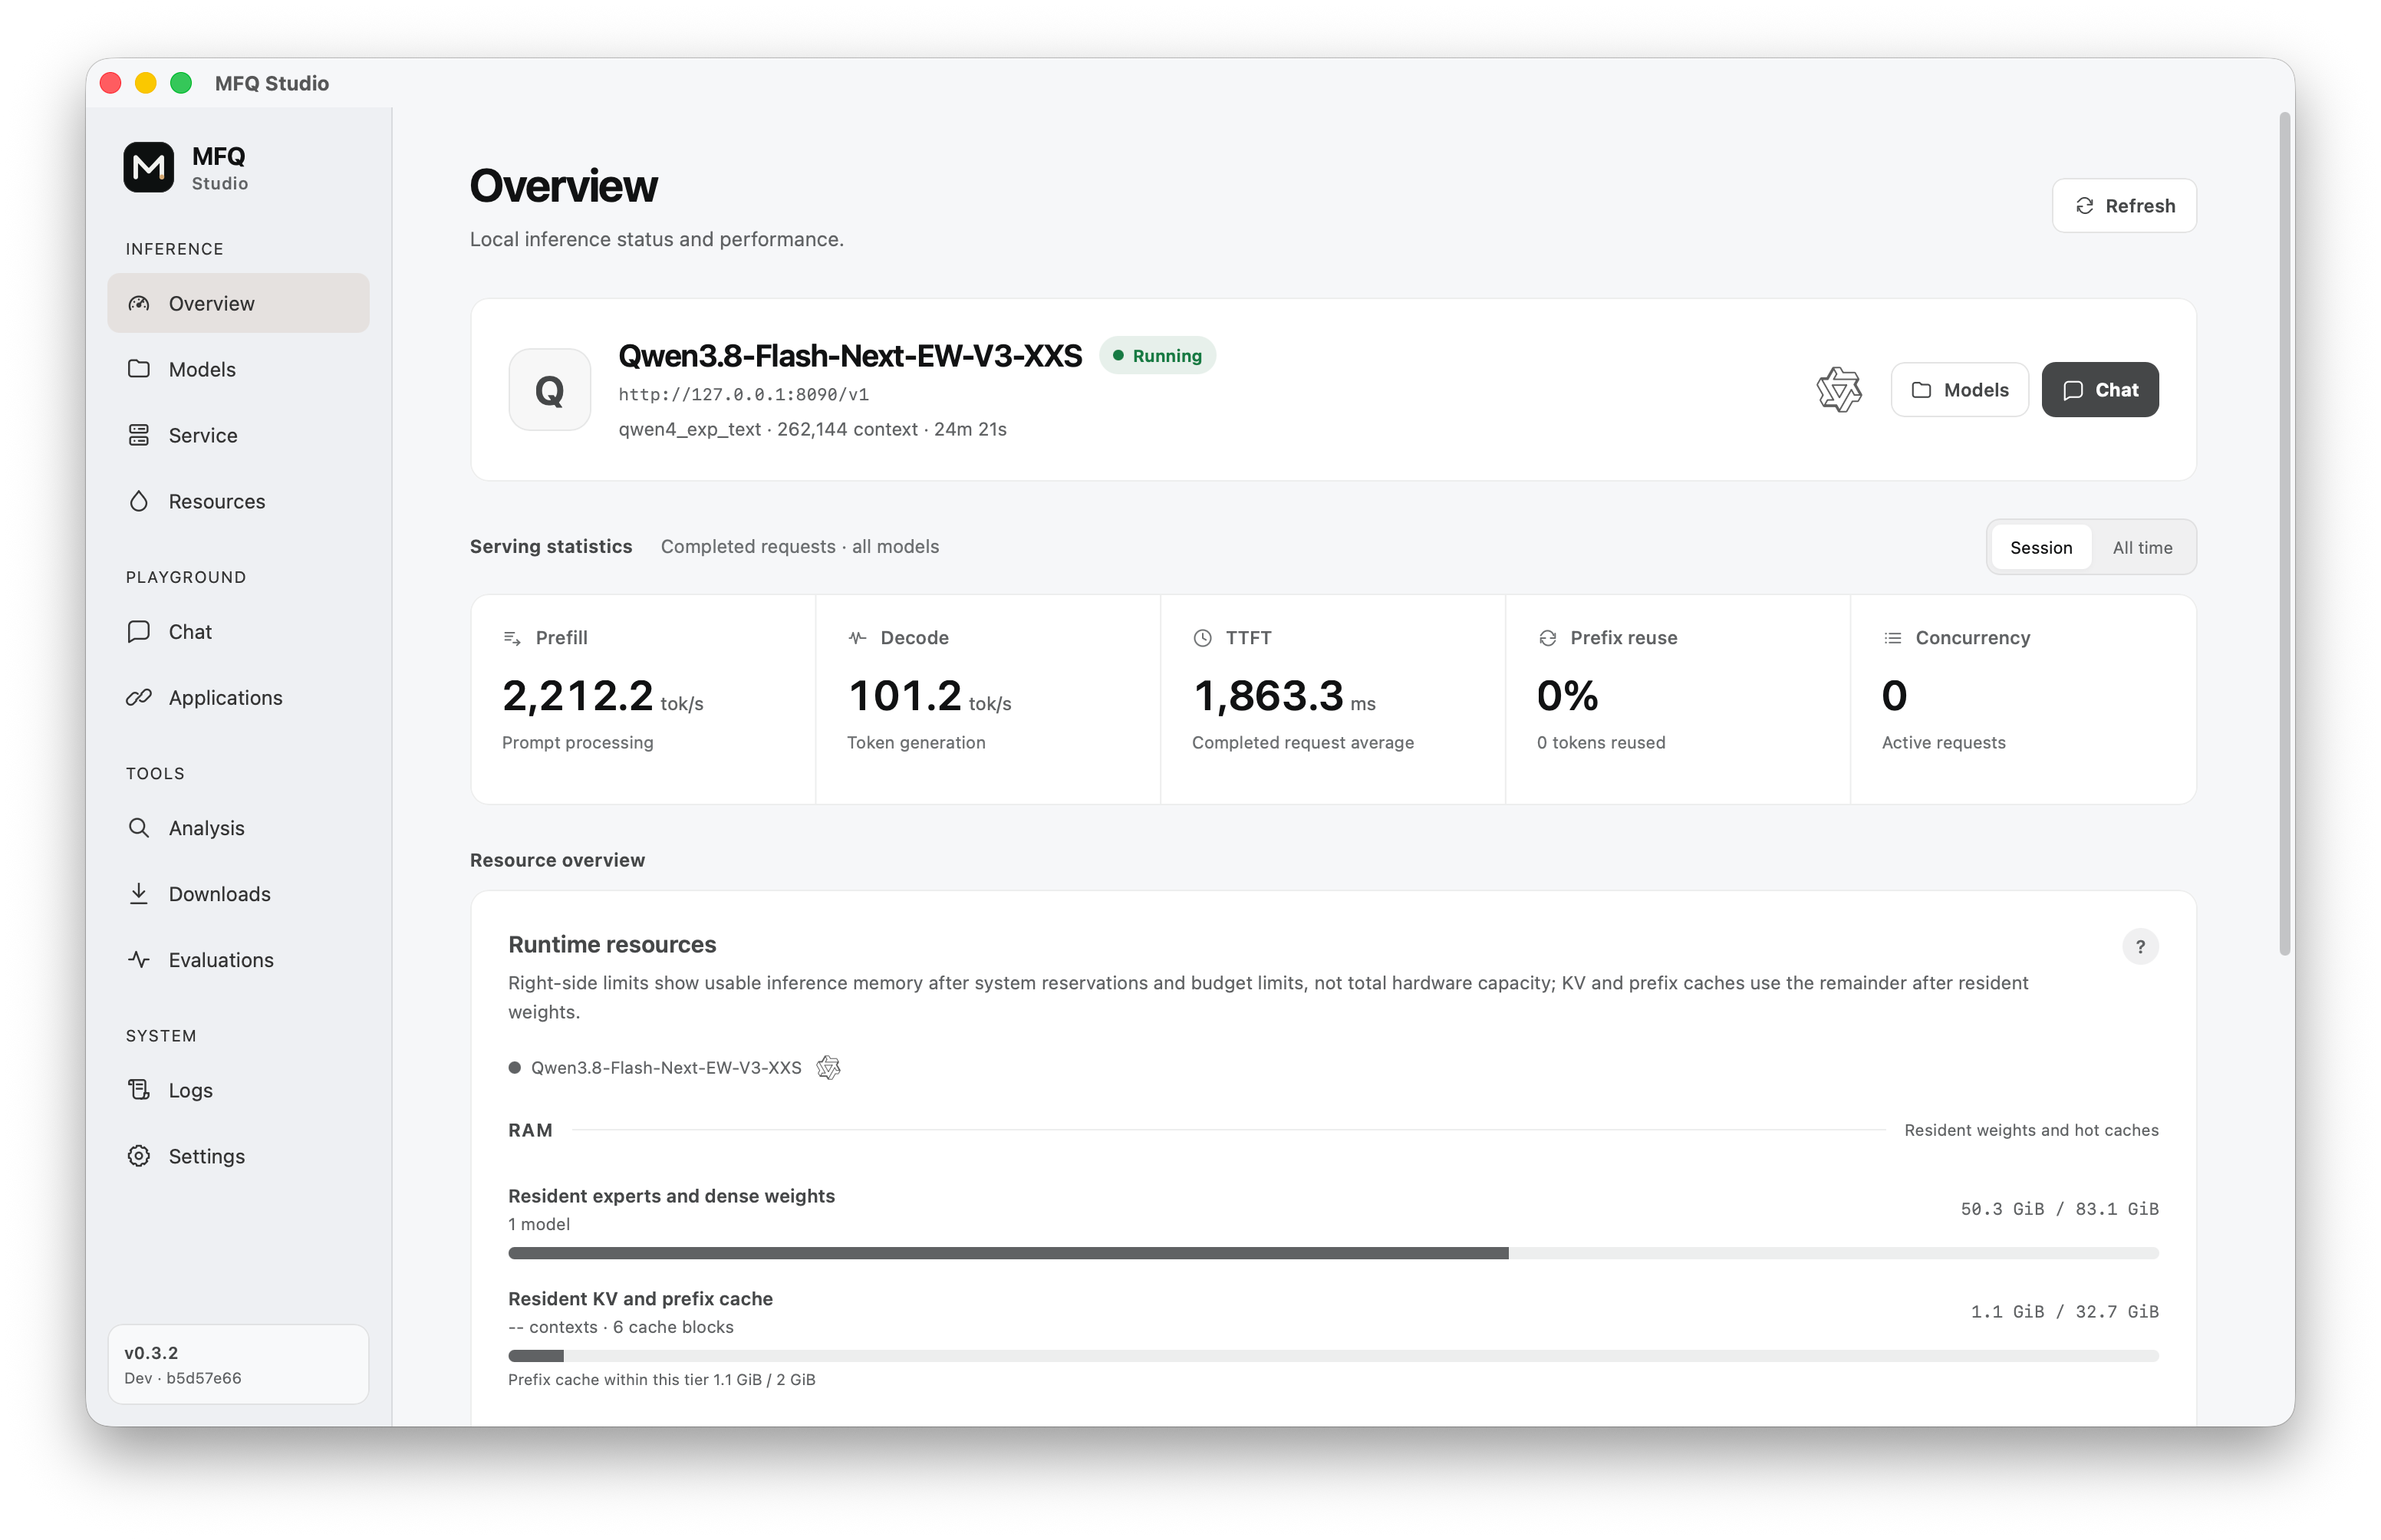
| Apple / Metal 生成速度 | 101.2 tok/s | V1-M;M5 Max(40 核 GPU,128 GB);4,096 token 输入;开启 MTP |
| NVIDIA / CUDA 生成速度 | 87.0 tok/s | V1-S;RTX 3090 Ti + 32 GiB 内存;4,096 token 输入;开启 MTP |
常驻权重不含 KV cache 和运行时分配。
为什么选 MFQ
精度分得细,模型质量保得住
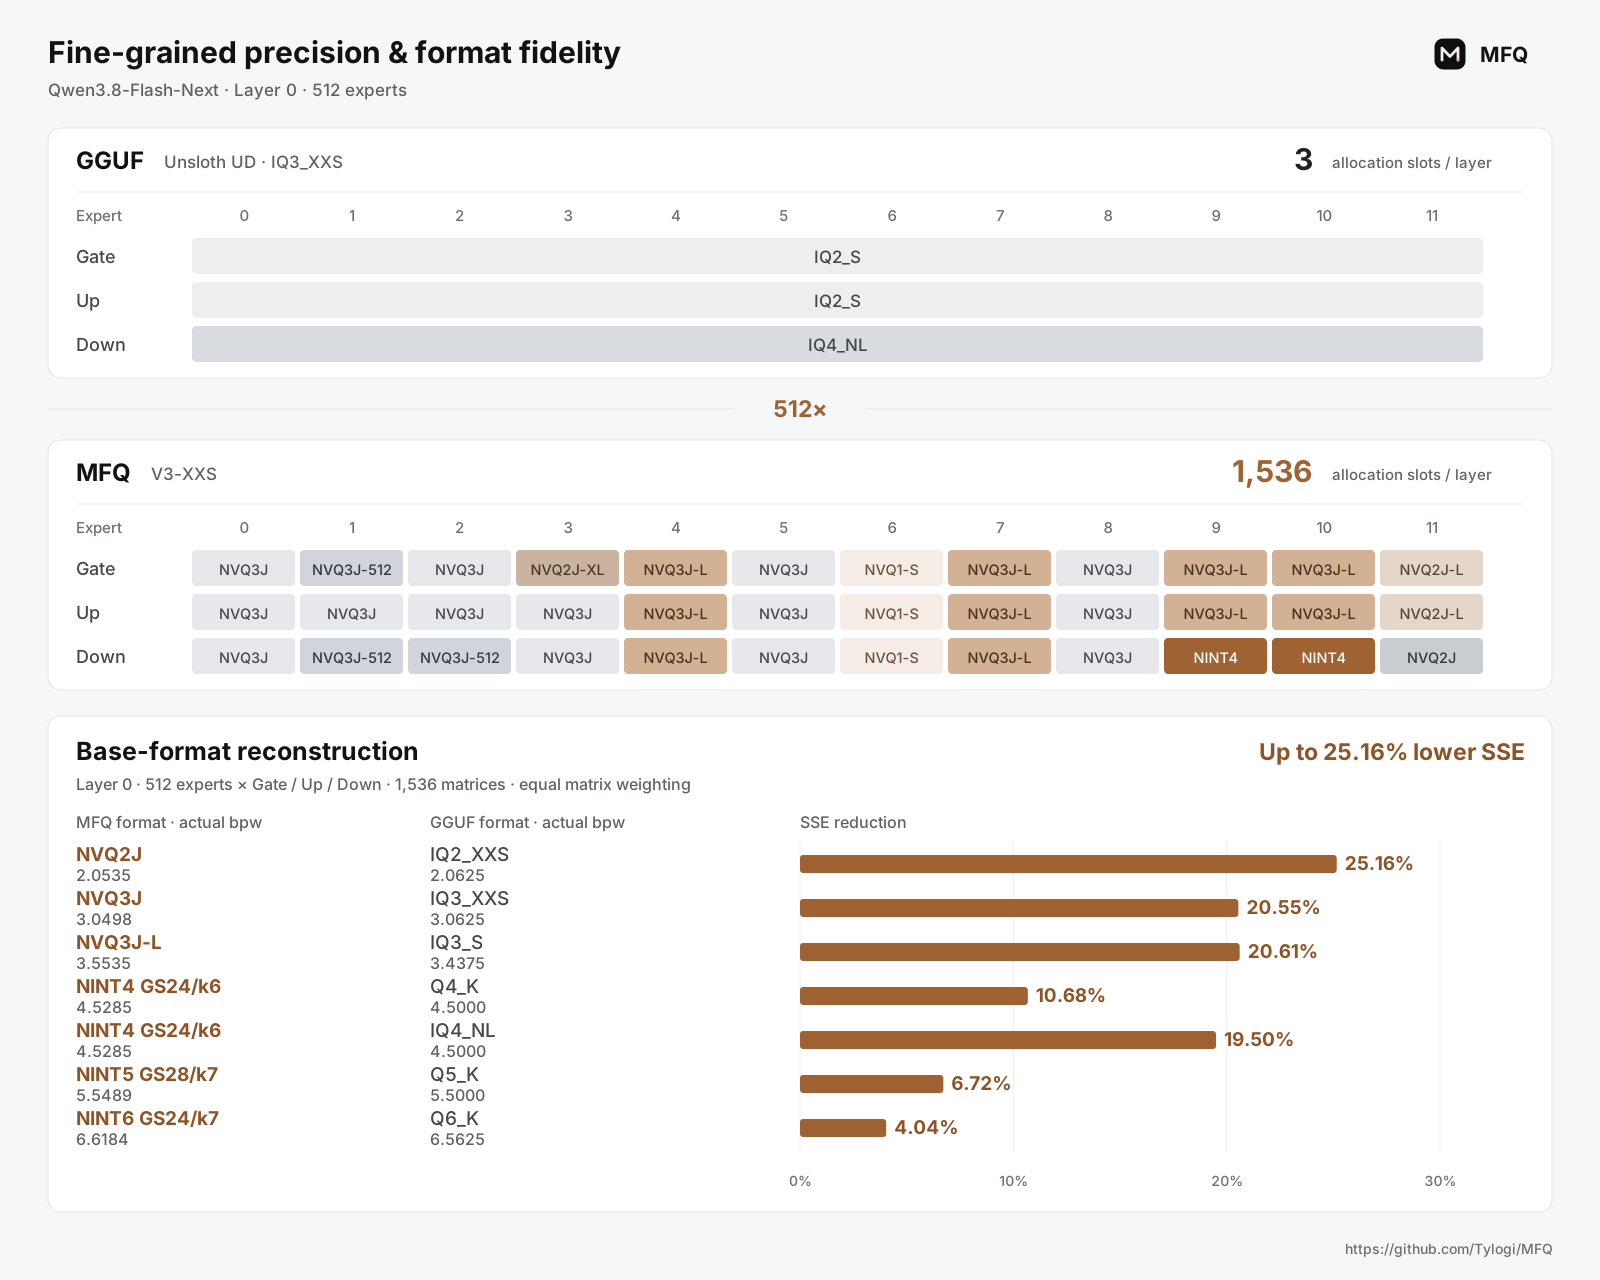
MFQ 能把精度分到单个专家、单个投影、单个 chunk,甚至单个神经元,把高精度留给模型最敏感的地方。NINT 标量格式和 NVQ 向量格式可以共存于同一层,每个专家的 Gate、Up、Down 投影各自选格式,原生运行时直接执行这些混合格式。
MFQ 的基础格式本身也能减少重建误差。在列出的七组 MFQ/GGUF 格式对比里,测试用的第 0 层专家矩阵平均 SSE 降低 4.04%–25.16%。
以 Qwen3.8-Flash-Next 为例:Unsloth UD 的 IQ3_XXS 方案给每层 Gate、Up、Down 投影各挑一种 GGUF 格式;MFQ 的 V3-XXS 给每个专家投影单独选配置。每层有 1,536 个分配槽位,那个 GGUF 方案只有 3 个,相差 512 倍。
校准方法已经开源,论文见 Beyond Expert Rankings: Contrast Calibration for Mixed-Precision MoE Quantization。
精度细了,原生速度还在
MFQ 的原生 kernel 会把格式兼容的专家计算分组执行,同时保留每个投影选定的格式,这样细粒度才真正可用。上面的 V3-XXS 档位开启 MTP 后,在 M5 Max 上跑到 105.4 tok/s,在 RTX 3090 Ti + 32 GiB 内存上跑到 61.0 tok/s。
- Apple Metal 后端基于 MLX,带原生 C++ 运行时,以及针对 MFQ 量化格式写的 Metal kernel。
- CUDA 后端能把显存、系统内存和 SSD 组合起来,跑超出显存容量的模型。Metal 支持有界的专家常驻,也支持把 MoE 专家和 PLE 表从 SSD 流式加载。
- ROCm/HIP 支持还在开发,优化过的 CPU 后端也在计划里。
一个应用管下载、运行和服务
MFQ Studio 把模型下载、加载、内存预算、量化分析和 benchmark 收进一个桌面应用。MFQ Server 提供 OpenAI 和 Anthropic 兼容 API,方便应用和 Agent 接入;它用 LRU 策略管理多个模型,把前缀缓存和 KV cache 分布在内存和 SSD 上。支持的原生路径还提供 continuous batching。
MiniCPM-o 4.5 支持
MFQ 给 MiniCPM-o 4.5 提供了 CUDA C++ 和 Metal C++ 两种原生运行时,也发布了 S4–S8 多模态档位的量化模型:
| 模型 | 已发布的精度档位 | 下载 |
|---|---|---|
| MiniCPM-o 4.5 | S4–S8 多模态档位 | ModelScope |
运行时细节见 MiniCPM-o 4.5 multimodal runtime。
快速开始
用 MFQ Studio 跑已发布模型
- 从 Releases 下载 MFQ Studio,安装包里带桌面应用、MFQ Server 和原生运行时。
- 在 Downloads 里下模型,再到 Models 里加载;也可以直接打开本地已有的
.mfqcheckpoint。 - 本地直接用,或者通过兼容 API 接进应用,不用从源码构建。
从源码构建
需要 Git、uv、CMake 3.26+ 和 C++ 工具链。NVIDIA 平台要 CUDA 12+,Apple 芯片走 Metal,这时把 uv sync 换成 uv sync --extra metal。
git clone https://github.com/Tylogi/MFQ.git MFQ
cd MFQ

uv sync
uv run mfq build --backend auto
uv run mfq serve
打开 http://127.0.0.1:8090/ 就能加载模型。
量化自己的模型
如果手上是 HF Safetensors checkpoint,建议从 S4-M 混合精度预设开始:它让敏感张量保持较高精度,视觉和 MTP 组件默认保留原始精度。
# Apple 芯片上使用:uv sync --extra metal --extra train
uv sync --extra train

# Hugging Face safetensors -> 自包含的 MFQ
uv run mfq quantize \
  /models/Qwen3.8-27B \
  /models/Qwen3.8-27B-MFQ-S4-M.mfq \
  --preset S4-M \
  --backend auto

# 加载并启动服务
uv run mfq serve \
  --model /models/Qwen3.8-27B-MFQ-S4-M.mfq \
  --context-size 32768
量化器还支持全精度 MFQ 和 GGUF 输入、逐张量或 Expert-Wise 精度映射、激活重要性矩阵,以及分片输出。
链接
- GitHub:Tylogi/MFQ
- MiniCPM-o 4.5 MFQ 模型:ModelScope
- 论文:arXiv 2610.20353
作者:Tylogi AI Lab。项目采用 Apache 2.0 许可证。