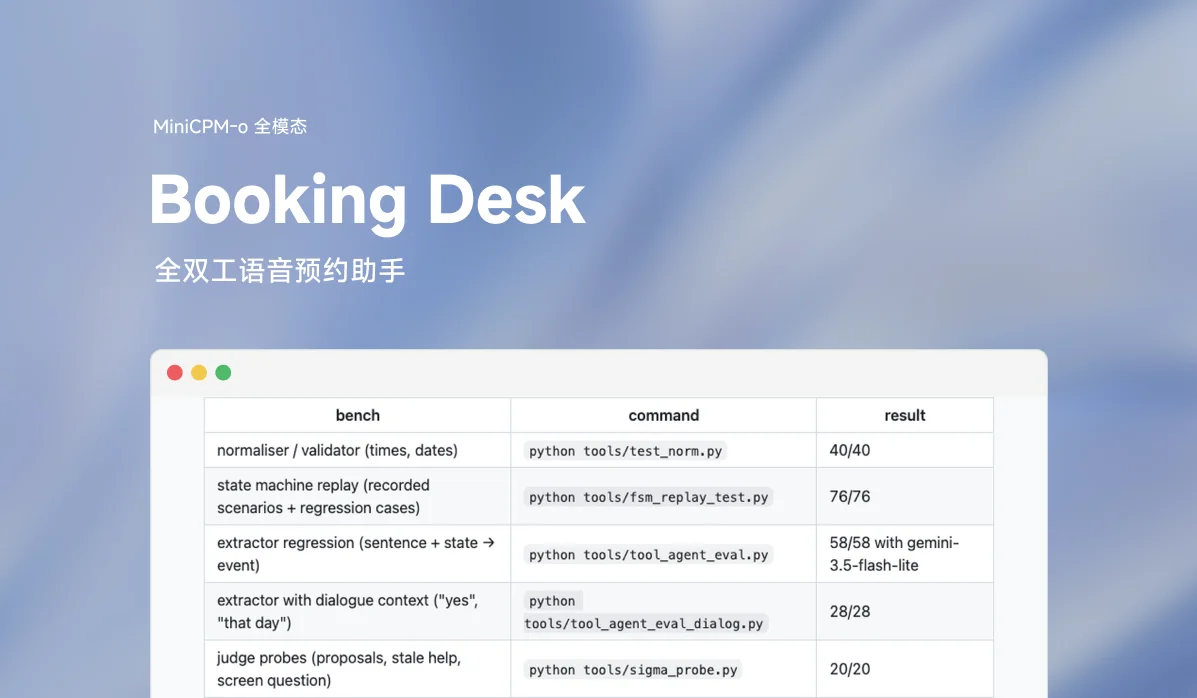
这是一个全双工语音预约前台,跑在 MiniCPM-o 4.5 原版权重上。语音模型一直在听、在说,它背后的推理 LLM 和确定性状态机负责调工具(查、约、取消),并写一块简短的操作员屏幕。语音模型每秒从视觉输入读一次这块屏幕,就像接线员盯着 CRM。另有一个裁判模块,专门抓不实陈述。没有微调,也没有轮次切换:推理始终不在音频链路上,来电的人也不用等回合。
当前分支:vision-booking。 操作员屏幕渲染成一帧图像,从模型的视频输入送进去。姊妹分支 text-booking 在视觉槽位里直接发同样的屏幕文本,不做图像编码,表现一致。两个分支只差这一条通道。
演示视频(3 分钟)
录制用的是一张 RTX 5090(32 GB),戴耳机,英文对话,一段对话内没有剪辑。
定位
这里选 MiniCPM-o 4.5 当前端模型,原因有三:开源、能在一张消费级 GPU 上跑,并且暴露了这套设计需要的两个钩子:逐单元的说 / 听决策,以及可以加窗的 KV cache。它不是全双工模型的终点:DuplexOmni(Huang et al., 2026, arXiv:2606.09186)把实时思考和听、看、说一起放进了模型内部,看起来是这类智能体更强的基座。论文解读:DuplexOmni: Real-Time Listening, Seeing, Thinking, and Speaking for Full-Duplex Interaction (YouTube)。下面的设计除了这两个钩子不依赖具体的前端模型,所以这套编排应该能迁移。
它能做什么
客户和前台对话。前台问月份、日期和时间,查日历;客户说“你帮我选”时,它会推荐一个时段;只有听到明确的“是”才预约;也能取消已有预约,同样要明确同意。预约数据库显示在另一个页面上,只由代码写入,模型碰不到。
工作原理
三个通道,每个都用在模型训练时就熟悉的用途上:
- 音频只属于客户。 没有合成语音,也不注入音频。模型开口说话的自然触发就是声学信号。
- 视觉是操作员屏幕。 屏幕上是两三行字,每句都是操作员能原样对客户说的话(
BOOK: APRIL/WHICH DAY?;APRIL 20, 2 PM/FREE/SHALL I BOOK IT?;BOOKED/ANYTHING ELSE?)。绝不写面向操作员的指令:强制开口时,模型会逐字念屏幕,于是SAY: AVAILABLE就变成了 “I'm going to say available”。屏幕是状态,不是消息:模型说话时它也在更新,模型决定开口的那一刻读到什么,就说什么。 - 控制 token 决定“何时”。 上游有
force_listen;作者加了它的镜像force_speak(MiniCPMO45/modeling_minicpmo_unified.py):在一个已关闭轮次的单元首次决策处,把<|listen|>换成<|speak|>,然后照常解码。实测:12 次里有 11 次在 0.5–1.2 s 内开口。
每一句客户话语的处理循环:
- 浏览器 VAD 在 300 ms 静音后结束这一句 → Whisper large-v3-turbo 转写 → 提取器(一个小型云端 LLM,
google/gemini-3.5-flash-lite,OpenAI 兼容接口)输出一个事件:set(说出的值,从不写入)、yes(唯一会写入的事件,且必须引用表示同意的原话)、no、cancel。 - 状态机(
gateway.py)合并记录、校验字段、查库里的日期或月份、在“你帮我选”时推荐时段、只在yes时预约或取消,并且是幂等的(记录相同就不产生事件)。 - 屏幕变了;模型根据语音作答并读屏幕,时间在客户说完后 1.5–3 s。
- 每个模型轮次结束时(以及客户说完 3 s 还没回应时),裁判(同一个 LLM,输入整段对话 + 屏幕 + 状态 + 时间信息 + 前台的约定)返回
ok或stuck(沉默、跑题、重复、无视屏幕、不实陈述、无法完成),加一句能说的提示语,以及它听到的陈述。 - 陈述由代码在数据库上验证,不交给 LLM:在得到 yes 之前说“我已经帮您订好了” → 红色
NOTHING BOOKED YET;说“下午 3 点有空”但其实已被占用 → 红色3 PM IS TAKEN。出现 stuck 或红色提示时,提示语被放到屏幕上,下一个分块带上force_speak,让模型开口说出来。 - 防护规则(都在真实运行里测过):两句客户话语之间最多提示一次,每个状态最多两次,两次强制之间隔 6 s,期间状态机变了就丢掉过期裁决,前 3 个分块内或轮次进行中绝不强制。裁判在轮次中也会检查:一个罗列日期、陷入循环的轮次会在约 11 s 处被
force_listen截断,然后纠正。 - KV cache 按会话加窗(基础版,4000 → 3500 tokens,保留系统提示词):上游会让它一直涨到模型上限,几分钟后对话就崩了。
数据结果
参考的真实会话(记录的运行登记,时间取自日志):
| 会话 | 时长 | 写入的预约 | 错误写入 | 裁判强制 | 红色提示 | 备注 |
|---|---|---|---|---|---|---|
sess_20257233a096(9 月 8 日) | 4 分 13 秒 | 2(April 4 3 PM、November 15 6 PM) | 0 | 4,全部合理 | 0 | “你帮我选”推荐了一天;轮次中检查放行了一个正常的 12 s 轮次 |
sess_f0ab8867fc79(9 月 7 日) | 2 分 43 秒 | 1 | 0 | 3,全部合理,语气词上 0 误触发 | 1,1 s 内被语音纠正 | 月份查询只读一次,部分日期以正确的极性读出 |
这些运行里的延迟:提取器 1.0–1.4 s,裁判 0.8–1.2 s,强制轮次在分块后 0.6–0.7 s 开口,模型在客户说完后 1.5–3 s 读到新屏幕。屏幕帧:448×448,每秒一帧。
基准测试(前两项不需要 GPU):
| 基准 | 命令 | 结果 |
|---|---|---|
| 规范化 / 校验器(时间、日期) | python tools/test_norm.py | 40/40 |
| 状态机回放(录制场景 + 回归用例) | python tools/fsm_replay_test.py | 76/76 |
| 提取器回归(句子 + 状态 → 事件) | python tools/tool_agent_eval.py | 58/58(gemini-3.5-flash-lite) |
| 带对话上下文的提取器(“yes”“那天”) | python tools/tool_agent_eval_dialog.py | 28/28 |
| 裁判探针(推荐、过期提示、屏幕问题) | python tools/sigma_probe.py | 20/20 |
提取器还测过三个备选方案,都没采用:约束解码的本地 Qwen3-1.7B(44/55,自由生成 47/55;它会为了把 JSON 填满而编值)、Nemotron 3 Nano(48/58 @ 1.2 s,对比 flash-lite 的 52/58 @ 0.9 s,测于修复评测框架之前)、Claude Sonnet 5(高 3 分,但每次调用 2.5 s,对这个循环来说太慢)。
失败经验与教训
完整记录在 docs/WRITEUP.md,简要清单如下:
- 光靠屏幕从没唤醒过模型(9 月 6 日之前的所有会话):一帧画面不是开口的触发信号。所以后来有了
force_speak,而不是更长的提示词、横幅或合成音频。 - 注入到模型输出槽位的文本,会被它当成自己的话说出来(“do you like cats” → “I like cats”);系统区域里的文本只是背景,不是命令。所以屏幕改走感知通道。
- 定时策略(每个事件帧都强制、锁存、3.5 s 看门狗)话太多,还会重复回答。后来换成裁判,由裁判看着对话决定。
- 屏幕上的操作员指令会被逐字念出来。 最后只留面向客户的句子。
- MiniCPM-o 4.5 的原生工具调用不可用:tokenizer 里有 Qwen3 的
<tool_call>模板,但模型会直接编答案,不去调用(试了 3 次)。所以另做了独立的提取器。 - 在状态机里显式加 STUCK 状态(9 月 13 日)反而更糟:强制突破了上限,模型自说自话。已放弃;裁判提示语加防护规则才是能用的形态。
局限
- 决策粒度是 1 s(一个单元),所以每次纠正都落在下一秒,而不是下一个 100 ms。
- 只支持英文。提示词只有一行:"You are in duplex mode, where you can listen and speak at the same time. You are the operator of an appointment booking desk. Follow the instructions on the SCREEN, always repeat dates for confirmation."
- 需要耳机:模型语音和麦克风之间没有回声消除。
- 麦克风距离要合适:别太近,也别太远。
- 提取器和裁判是云端调用(OpenAI 兼容接口);有本地 Qwen3-1.7B 兜底,但得分低一些(48/55)。
- 很短的轮次里,语气词之后偶尔会出现非英语音素,来自语音解码器;这个可以接受。
运行
硬件:一张 32 GB 显存的 GPU(在 WSL2 下的 RTX 5090 上测过;用 turbo 配置约占 29 GB)。
软件:Python 3.10、带 CUDA 的 PyTorch、pip install -r requirements.txt,还要 openai-whisper 做旁路 ASR(同一环境,或者用 ASR_PYTHON 指定另一个环境)。
- 权重:从 openbmb/MiniCPM-o-4_5 下到
models/MiniCPM-o-4_5。可选models/Qwen3-1.7B作为本地提取器兜底(HUD_ASR=small)。 - 提取器 / 裁判接口,写在
~/.config/tool_agent.env或仓库根目录的.env里:Plain TextTA_API_KEY=...TA_BASE_URL=https://api.cline.bot/api/v1 # any OpenAI-compatible endpointTA_MODEL=google/gemini-3.5-flash-lite - 启动全部服务(后端、旁路 ASR、提取器 / 裁判、worker、gateway;后端加载大约要 4 分钟):
Bashbash tools/run_desk.sh
- 打开
https://localhost:8006/static/hud/hud.html(自签名证书),戴上耳机,选麦克风,点 Start session。预约记录在https://localhost:8006/static/hud/db.html。 - 事后看一次运行:
python tools/hud_run_log.py --conv(登记在logs_demo/hud_runs/)。
HUD 页面上还会显示状态图、最近一次裁判结论、强制记录和已发送的帧,另有一个手动面板(不用语音),可以手动驱动状态机。
仓库结构
| 路径 | 内容 |
|---|---|
gateway.py | 上游 gateway + 前台逻辑:状态机、预约数据库、屏幕、裁判路由(_hud_*,约从第 750 行起) |
static/hud/ | 操作员屏幕页面(hud.html、hud-app.js)、预约视图(db.html) |
tools/tool_agent_server.py | 提取器 + 裁判服务(云端或本地) |
tools/asr_server.py、tools/switch_asr_profile.sh | 旁路 ASR(Whisper)及其配置 |
tools/run_desk.sh | 启动脚本 |
MiniCPMO45/ | 上游模型代码及作者的修改:force_speak 覆盖、按会话的 KV 滑动窗口(set_sliding_window、window_stats)、文本注入钩子、解码器修复(温度作用于分块末尾、重复惩罚符号、<|listen|> token id、按词对齐的分块切分) |
core/、py_backend/、static/duplex/ | 新会话字段(force_speak、sliding_window_*)的贯通 |
tools/*_eval*.py、fsm_replay_test.py、sigma_probe.py、test_norm.py | 上述基准测试 |
docs/WRITEUP.md | 成功与失败的经验,附数据 |
docs/UPSTREAM_README.md、docs/en/ | 原始演示系统的 README 和文档 |
相关链接
- GitHub:AlessandroBonomo28/Minicpm-o-booking-desk
- 演示视频:YouTube
项目作者:AlessandroBonomo28。基于 OpenBMB/MiniCPM-o-Demo(基础提交 50b0865)和 MiniCPM-o 4.5 构建;Whisper 来自 OpenAI。前台、屏幕、裁判和模型改动均为本仓库的工作。